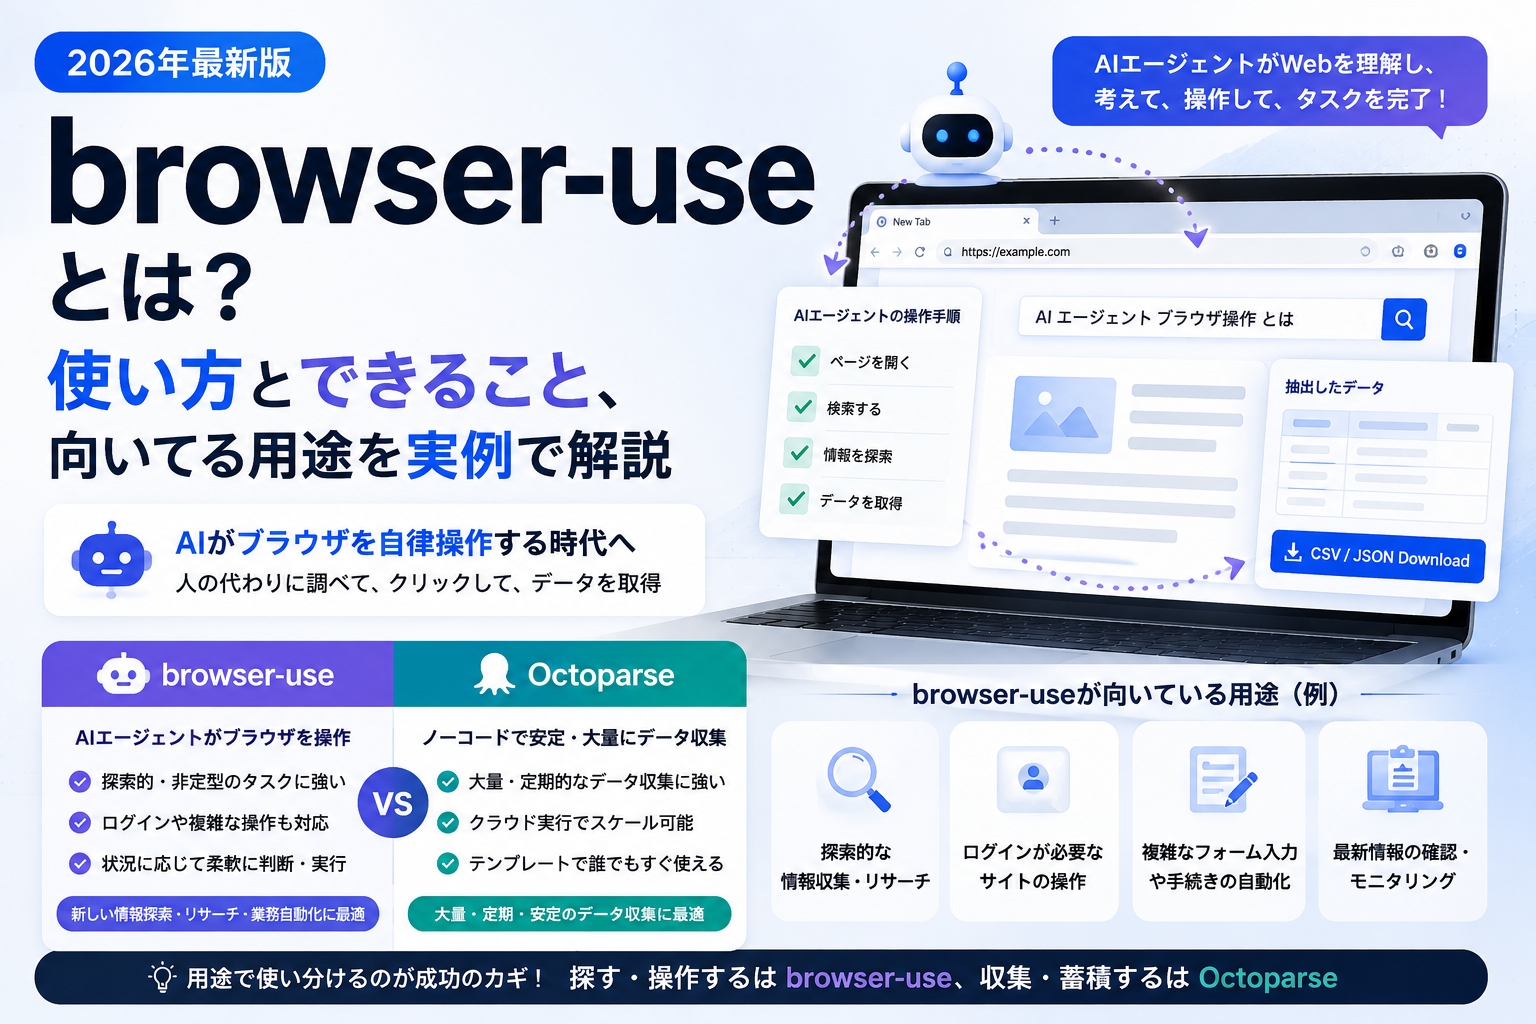
Browser Useは、AIに指示してWebブラウザ上の操作を進めるためのプラットフォームです。Firecrawlは、Webの検索・ページ取得・巡回・操作をAPIから利用し、Markdownや構造化データを受け取るサービスです。ブラウザで作業を進めたいのか、Webデータを集めたいのかが、両者を選ぶ出発点になります。
とはいえ、「どちらでもデータを取れるなら、何を基準に選べばよい?」「APIを呼ぶだけで済む?」「試せたとしても、毎日の運用や費用はどうなる?」と迷う方も多いでしょう。最初のデモが動くことと、業務で使い続けられることは別です。
本記事では、Browser UseとFirecrawlの違いを、機能・料金・導入方法・利用シーンから比較します。それに、その代替ツールも詳しく紹介します。
| やりたいこと | 最初に検討する選択肢 | 判断のポイント |
|---|---|---|
| クリックや入力を含む複数画面の作業をAIに進めさせたい | Browser Use | Agentの判断、ログイン状態、操作後の結果を検証できるか |
| サイト本文を集め、RAGや検索システムに取り込みたい | Firecrawl | 必要なページ範囲、Markdown/JSON、credits消費 |
| 決まった項目を繰り返し集め、チームやシステムで使いたい | Octoparse | テンプレートや再利用タスク、クラウド実行、API接続 |
Browser UseとFirecrawlの違いは?機能と運用方法を比較
中心となる違いは、ブラウザ上で「作業を進める」設計か、Webから「内容を取得する」設計かです。ただし、Browser Useでも構造化データを取得でき、Firecrawlにもブラウザ操作の機能があります。できる・できないの二択ではなく、主な仕事をどちらに任せるかで比較しましょう。
| 比較項目 | Browser Use | Firecrawl |
|---|---|---|
| 主な役割 | 目標に沿ったブラウザ操作、Agent実行、ブラウザ基盤 | 検索・ページ取得・サイト巡回とデータ抽出 |
| 操作方法 | ホスト型Agent、CLI、オープンソースPythonライブラリなど | API、SDK、CLI、MCP、ブラウザ上のPlaygroundなど |
| クリック・フォーム操作 | Agentがページを確認し、操作を進める | Interact/Browser Sandboxで対応 |
| ページの巡回 | Agentや自分の処理で移動・収集を設計する | Crawlなど、複数ページ取得向けのAPIを利用する |
| 結果の使い方 | タスク結果やファイル、指定した構造化出力を後続処理へ | Markdown、HTML、構造化JSONなどを後続処理へ |
| 継続運用 | クラウドAgentなどを使い、起動方法と結果検証を設計 | 取得APIやMonitorなど、目的に合う機能を選ぶ |
| 導入時の確認 | Agentを誰が動かすか、ローカル/クラウド、モデル・セッション管理 | 対象範囲、出力形式、credits、レート制限 |
| 主な利用者 | ブラウザ業務を自動化する開発者、Agent構築チーム | AIアプリ、RAG、検索・データ基盤の開発者 |
機能の確認には、Browser Useの製品別ガイドとFirecrawlの公式機能説明を参照しています。Browser UseをPythonライブラリだけで説明したり、Firecrawlは操作できないと説明したりすると、現在の選択肢を見落とします。
両方を組み合わせることもできます。例えば、ページ本文の取得はFirecrawl、取得した情報を使った社内画面への入力はBrowser Useという構成です。ただし、データの受け渡し、入力内容の検証、重複実行の防止はアプリケーション側で設計します。
関連記事:
Browser-Useとは?使い方とできること、向いてる用途を実例で解説【2026年】
Browser UseとFirecrawlの料金は?無料枠と追加費用を確認
無料で始められることと、継続運用が無料であることは違います。Browser Useは実行するモデルやブラウザ資源、Firecrawlは機能ごとのcreditsが主な費用の見方です。以下は2026年11月2日に確認した公式情報で、金額は米ドルです。契約前には最新条件を確認してください。
Browser Useはモデル・ブラウザ時間・通信量を分けて考える
| 項目 | 公式に案内されている料金・条件 |
|---|---|
| オープンソースライブラリ | ソフトウェアの利用と、モデル・実行環境の費用は別 |
| ホスト型Web Agent | モデル費用に20%の手数料。ブラウザ時間・通信量は別 |
| クラウドブラウザ | 1時間あたり$0.02。分単位の切り上げ、最低1分 |
| 管理された住宅用プロキシ | $5/GB |
| 無料クレジット | 対象となる新規登録者に1人1回$1。毎月更新の無料枠ではない |
| 支払い | 必須の月額サブスクリプションなし。最低チャージ$5、creditsは失効しない |
Firecrawlは月額プランと機能別creditsを確認する
| プラン | 月払い | 年払い時の月額換算 | 毎月のcredits |
|---|---|---|---|
| Free | $0 | — | 1,000 |
| Hobby | $19 | $16 | 5,000 |
| Standard | $99 | $83 | 100,000 |
| Growth | $399 | $333 | 500,000 |
| Scale | $749 | $599 | 1,000,000 |
| Enterprise | 個別見積もり | 個別見積もり | 契約による |
基本的なScrape/Crawlは1ページ1 creditですが、JSON形式によるLLM抽出は追加で4 credits/ページです。Interactはコードのみなら2 credits/ブラウザ分、自然言語のpromptを使う場合は7 credits/ブラウザ分で、最低1分の課金があります。詳しくは機能別のcredits消費を確認してください。
例えば、追加オプションなしの基本取得で100ページなら100 credits、同じ100ページをJSON形式のLLM抽出で処理するなら基本分と追加分で500 creditsという計算です。これは料金体系の計算例で、実測値ではありません。1,000 creditsを常に1,000ページの構造化抽出に使えるとは限りません。
どちらが安いかは「使える結果」までの総費用で比べる
比較すべきなのは、APIの呼び出し回数だけではなく、必要な結果を得るまでの費用です。Browser Useならモデル・ブラウザ・通信、Firecrawlなら取得形式・操作・追加機能のcreditsに加え、どちらも開発と運用の時間を含めて見積もります。
- 同じ対象ページ・取得項目・実行頻度で比較する。
- 欠損や誤取得があった場合の確認・再試行も含める。
- 並列数とレート制限が、業務の締め切りに合うか確認する。
- 小量の試行結果だけで、大量実行時の安さや成功率を断定しない。
どちらを選び、どう使い始める?利用シーン別の判断
複数画面の操作をAIに任せたいならBrowser Useを検討
操作手順が画面の状態に応じて変わる仕事では、Browser Useを検討する理由があります。例えば、自社のテスト環境でページを移動し、フォームに入力し、目的の画面へ到達したかを確認する仕事です。入力後の状態まで検証し、操作が途中で止まったときの対応も決めます。
始め方は、ホスト型AgentにURLと目標を渡す方法、自分のAgentへCLIを与える方法、PythonライブラリでAgentを構築する方法から選びます。既存の開発環境があるなら自分で制御する方法、ブラウザとAgentの運用を任せたいならホスト型が候補です。詳しい導入はBrowser Useの設定と利用例も参考になります。
本文を集めてRAGや検索へ渡したいならFirecrawlを検討
記事やドキュメントの内容を取得して検索対象にしたい場合は、Firecrawlが候補になります。まず単一ページを取得し、必要な本文が残るか、不要なナビゲーションが混ざらないかを確認します。サイト全体に広げる前に、対象パスや取得上限を決めると検証しやすくなります。
コードを組む前にPlaygroundで出力を確認することもできます。継続利用ではAPIやSDKをアプリケーションにつなぎ、取得後の分割・保存・更新処理を設計します。FirecrawlがWeb取得を担っても、RAG全体の設計まで自動で終わるわけではありません。Firecrawlの利用方法と注意点で基本を確認できます。
同じ項目を繰り返し集めるなら、再利用と運用方法を重視する
毎朝の商品一覧、毎週の求人掲載状況、毎月の公開店舗情報など、決まった列を継続して集める仕事では、初回の取得方法だけでなく、その後の運用を考える必要があります。「誰が項目を変更するか」「PCを閉じても動くか」「開発者は結果をどう受け取るか」が選択を左右します。
この場合は、既存テンプレートや保存できる収集タスク、クラウド基盤、APIをまとめて使えるOctoparseも比較対象に入ります。Browser UseやFirecrawlを全面的に置き換えるというより、業務で必要な構造化データを繰り返し届ける方法として評価すると、違いが明確になります。
データ収集の代替ツールOctoparseをおすすめする理由
Browser UseはAIによるブラウザ操作、FirecrawlはWebページの取得やMarkdown・JSON形式への変換に強みがあります。しかし、「数百件の商品情報をまとめて取得したい」「競合サイトの価格を毎日チェックしたい」「収集したデータを社内システムで継続的に使いたい」 といった場合は、データ収集の仕組みそのものを構築・運用する必要があります。
こうした用途でおすすめなのが、Octoparse(オクトパース)です。
Octoparseは、Webデータの一括収集から定期実行、API・MCP連携まで対応するデータ収集プラットフォームです。680種類以上の既存テンプレートやノーコード操作に加え、最新のAIアシスタントでは、欲しいデータを日本語で伝えるだけで、目的に合った収集方法を提案してもらえます。
特にAIアシスタントでは、用途に合わせて4つのデータ収集方法を利用できます。
- テンプレート提案: AIが条件に合う既存スクレイパーを検索・提案します。ユーザーが必要なパラメータを入力して実行するため、商品価格や店舗情報などの一般的なデータを素早く収集したい場合に便利です。
- Browser Use: AIがChrome拡張機能を通じてブラウザを操作し、データを取得します。ログイン後のページや単発の収集に適しています。
- Cloud Agent: AIが専用スクレイパーを自動作成し、クラウドで実行します。独自の取得条件や繰り返し収集する業務に向いており、Standardプラン以上では定期実行も可能です。
- 自動検出: URLから表やリストのデータ構造を認識して収集タスクを作成します。Desktopで取得項目や収集ルールを細かく調整したい場合に便利です。
Octoparseは、単発のWeb操作よりも、構造化データを大量・継続的に収集したいユーザーに適しています。 特にECの価格監視、競合調査、営業リスト作成など、同じデータ収集を繰り返す業務で活用できます。
一方、幅広いブラウザ操作の自動化ならBrowser Use、WebコンテンツのMarkdown化やAIアプリ向けのデータ取得ならFirecrawlが適している場合もあります。
次はOctoparse AIを使ってデータを収集する方法について詳しく紹介します。
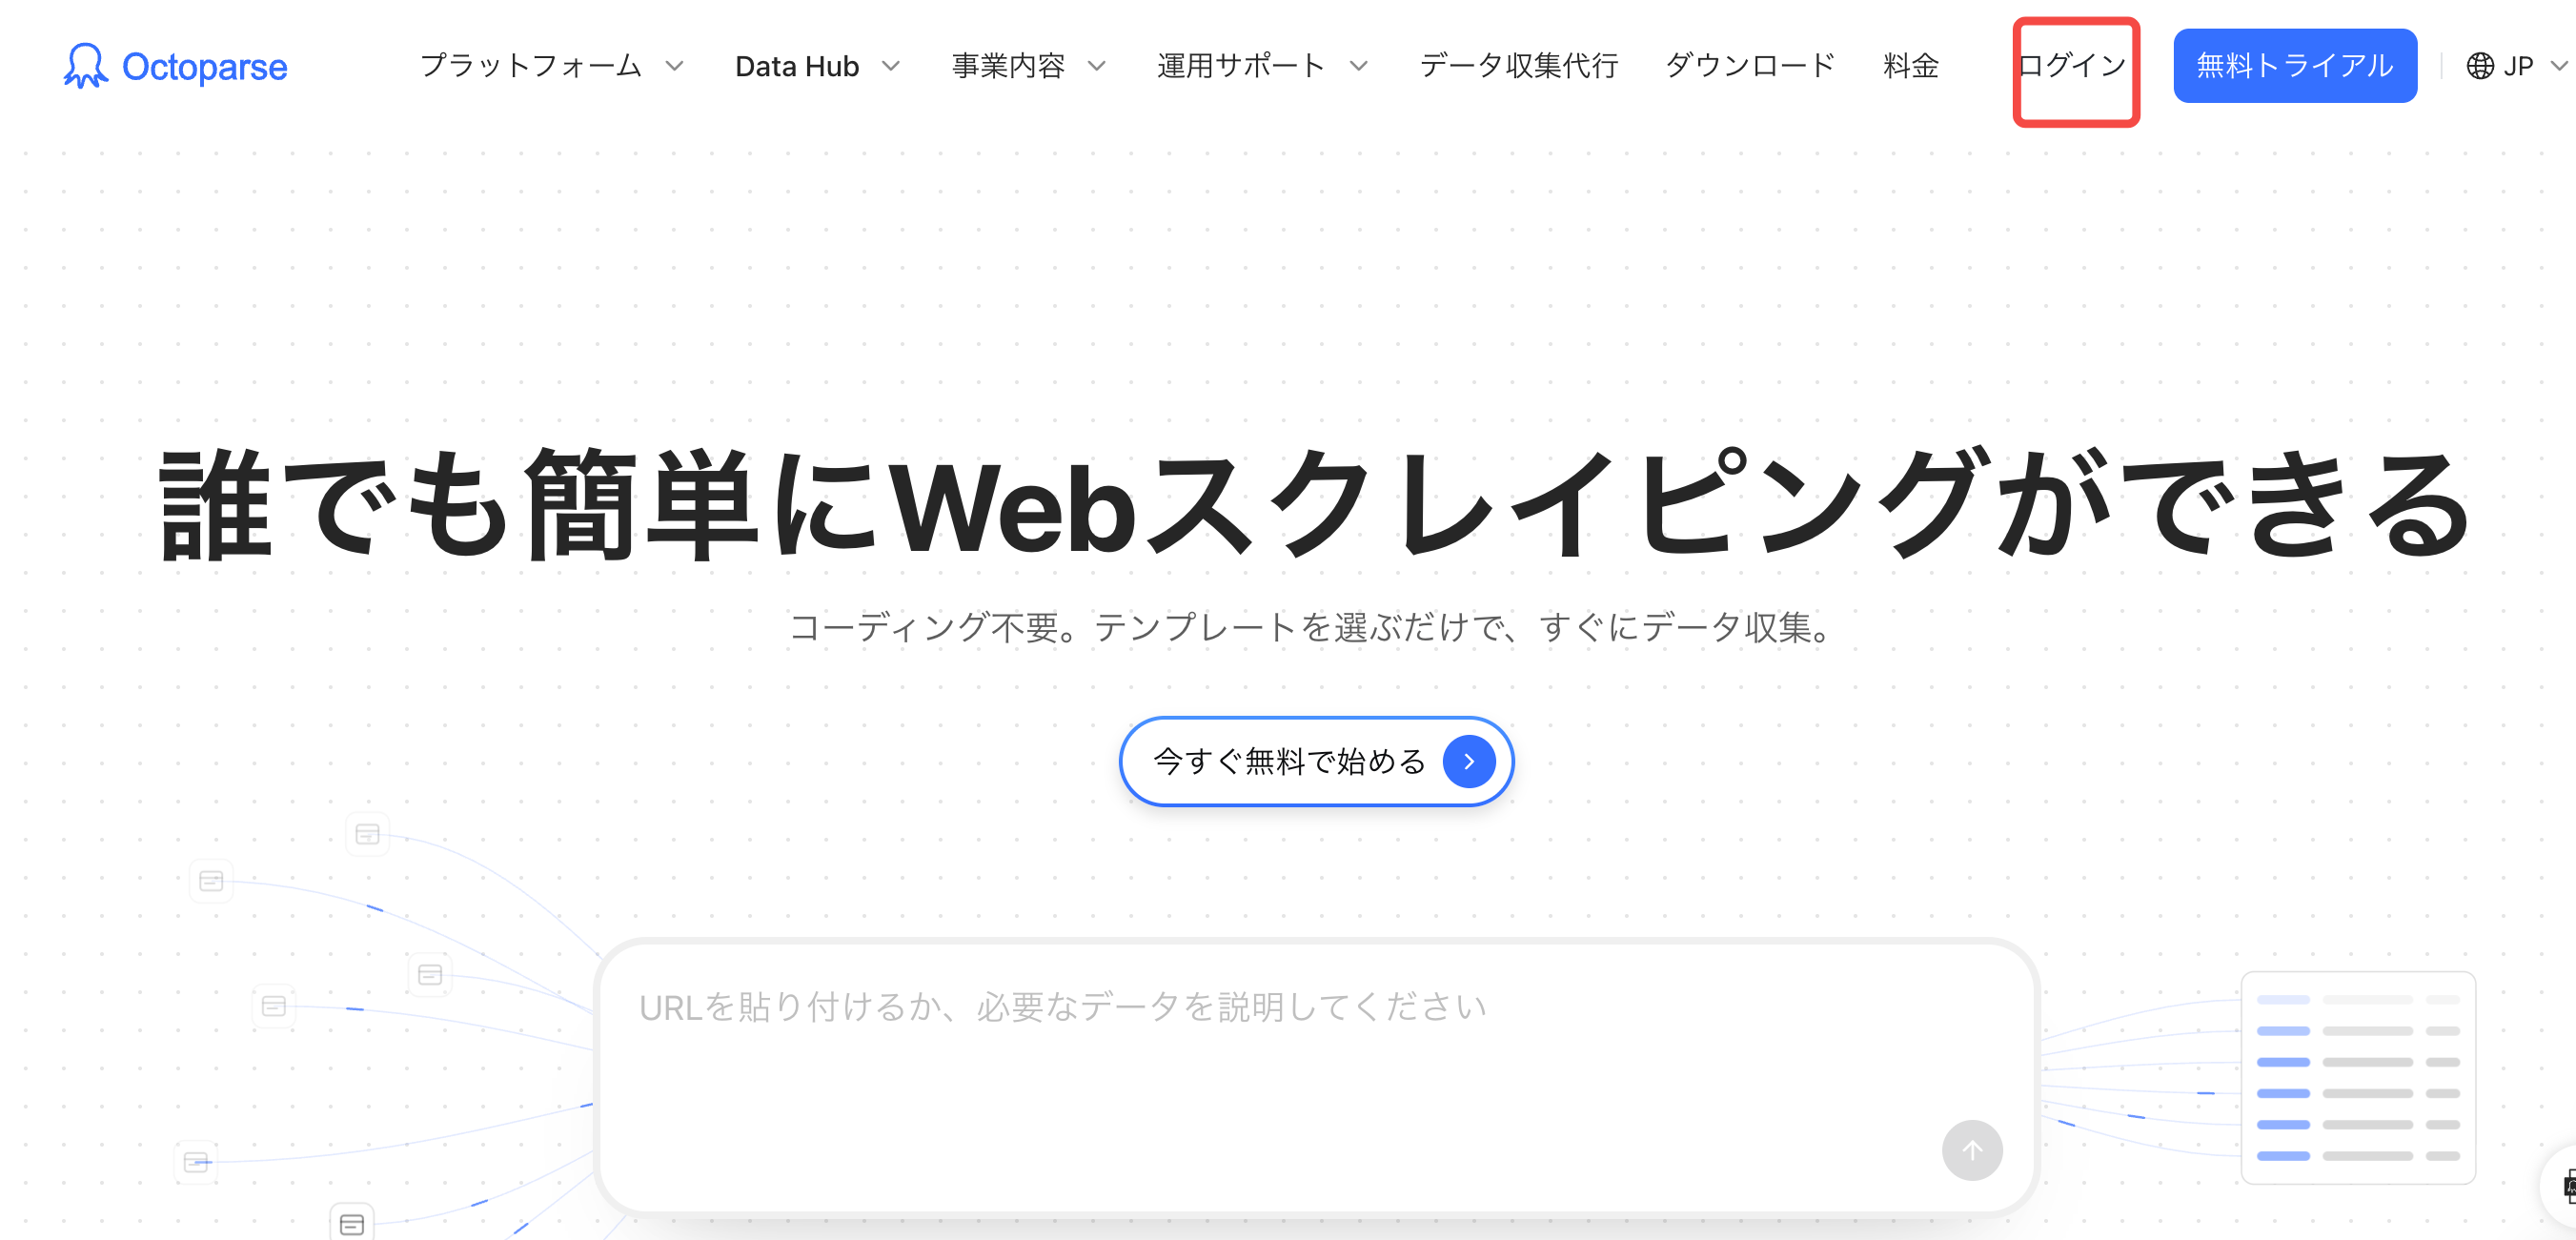
Step1:Octoparseのアカウントを作成
Octoparseでアカウントがない場合、まずは新規アカウントを作成し、ログインします。
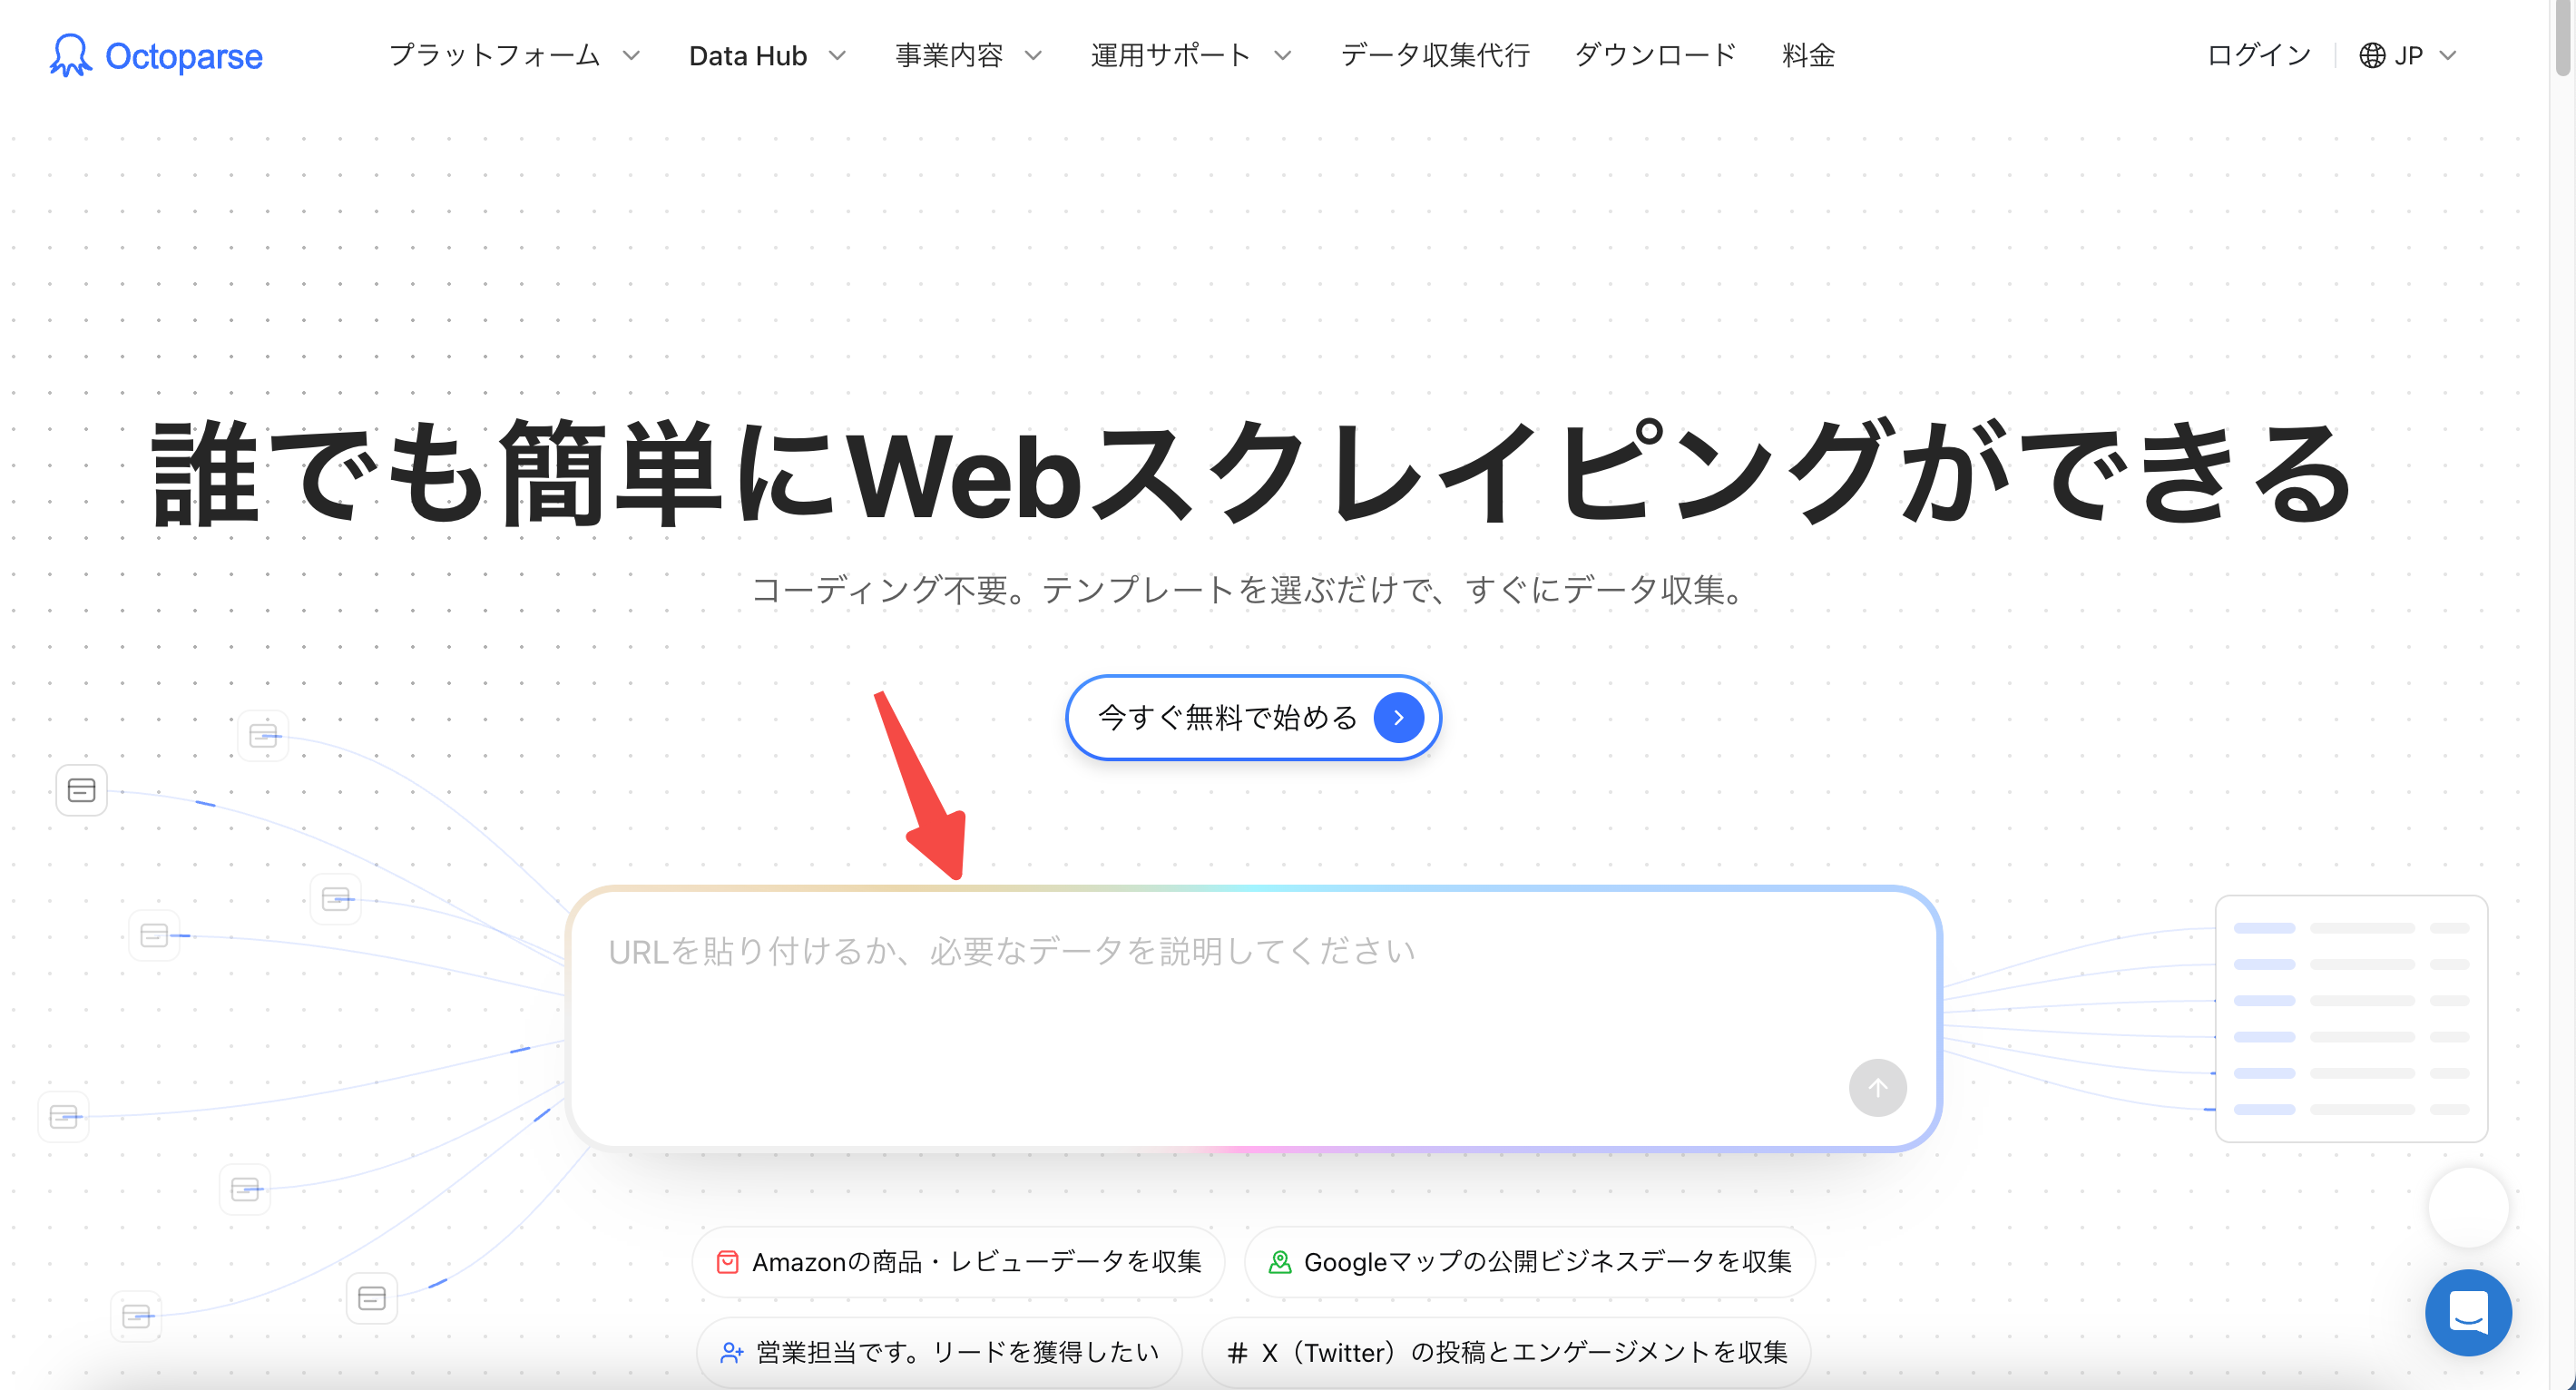
Step2:AIアシスタントを開く
octoparse.jp/console/task/agenticにアクセスするか、Octoparseのホームページにあるチャット欄にリクエストを入力します。
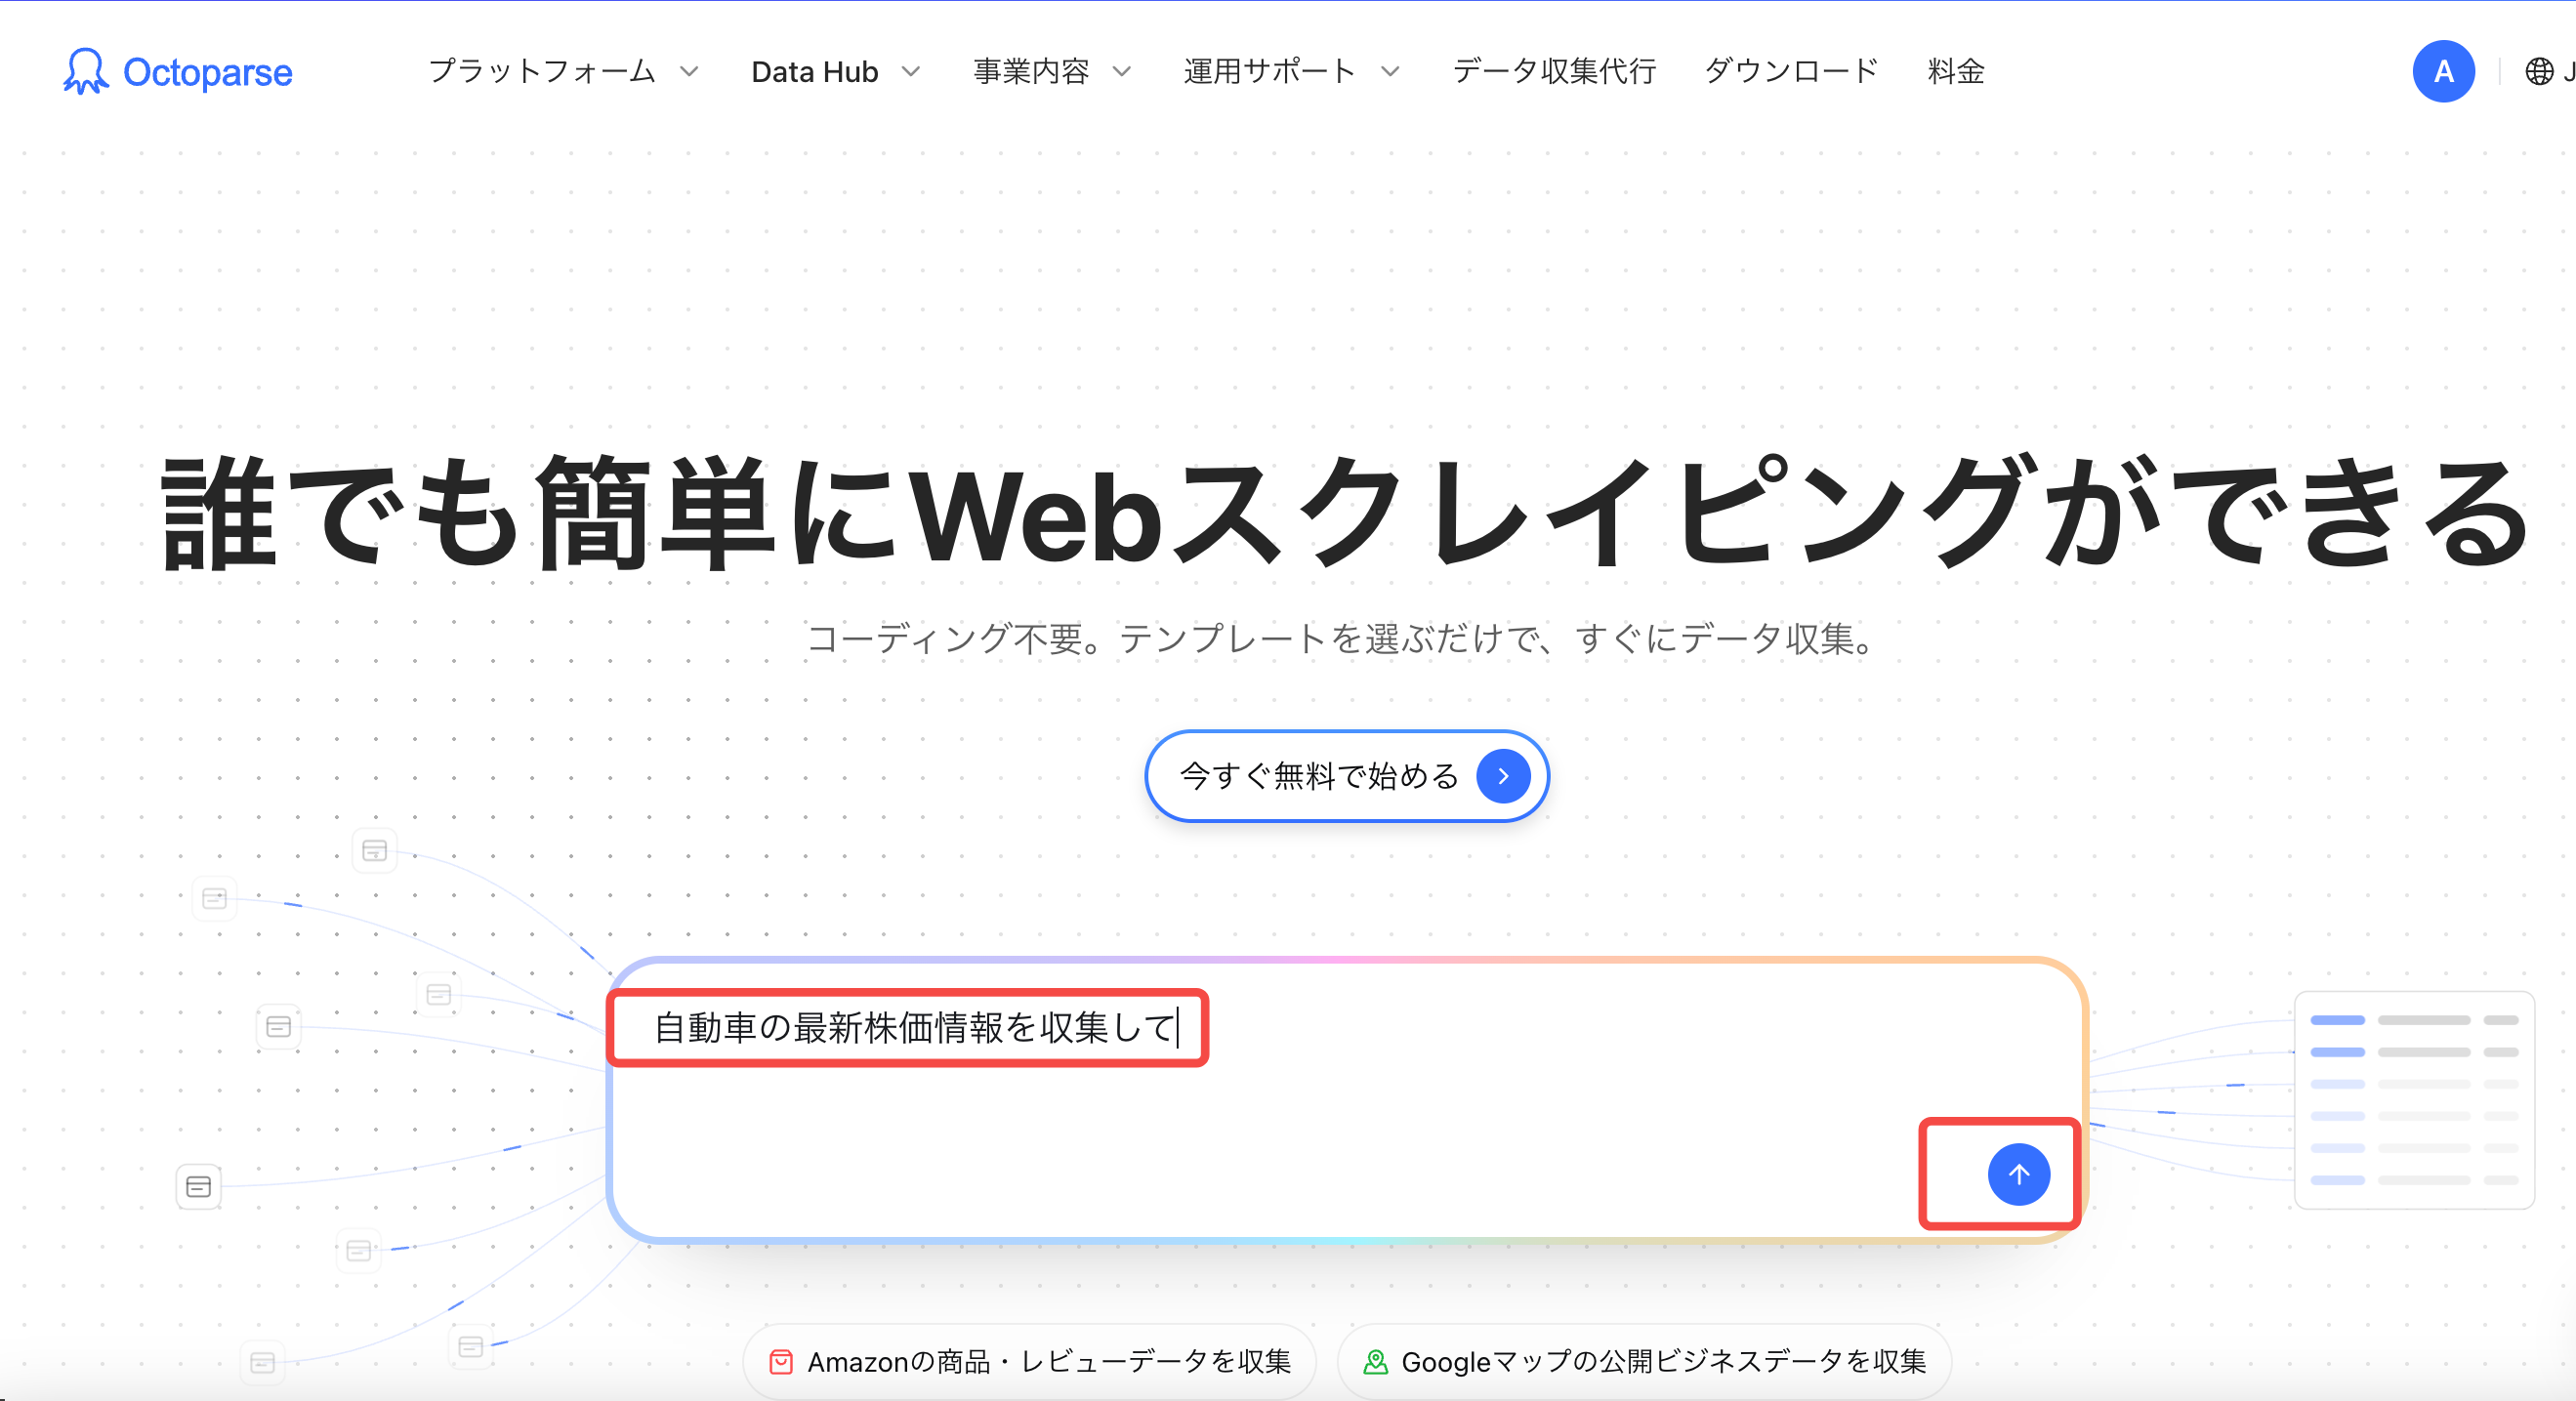
Step3:取得したいデータを伝える
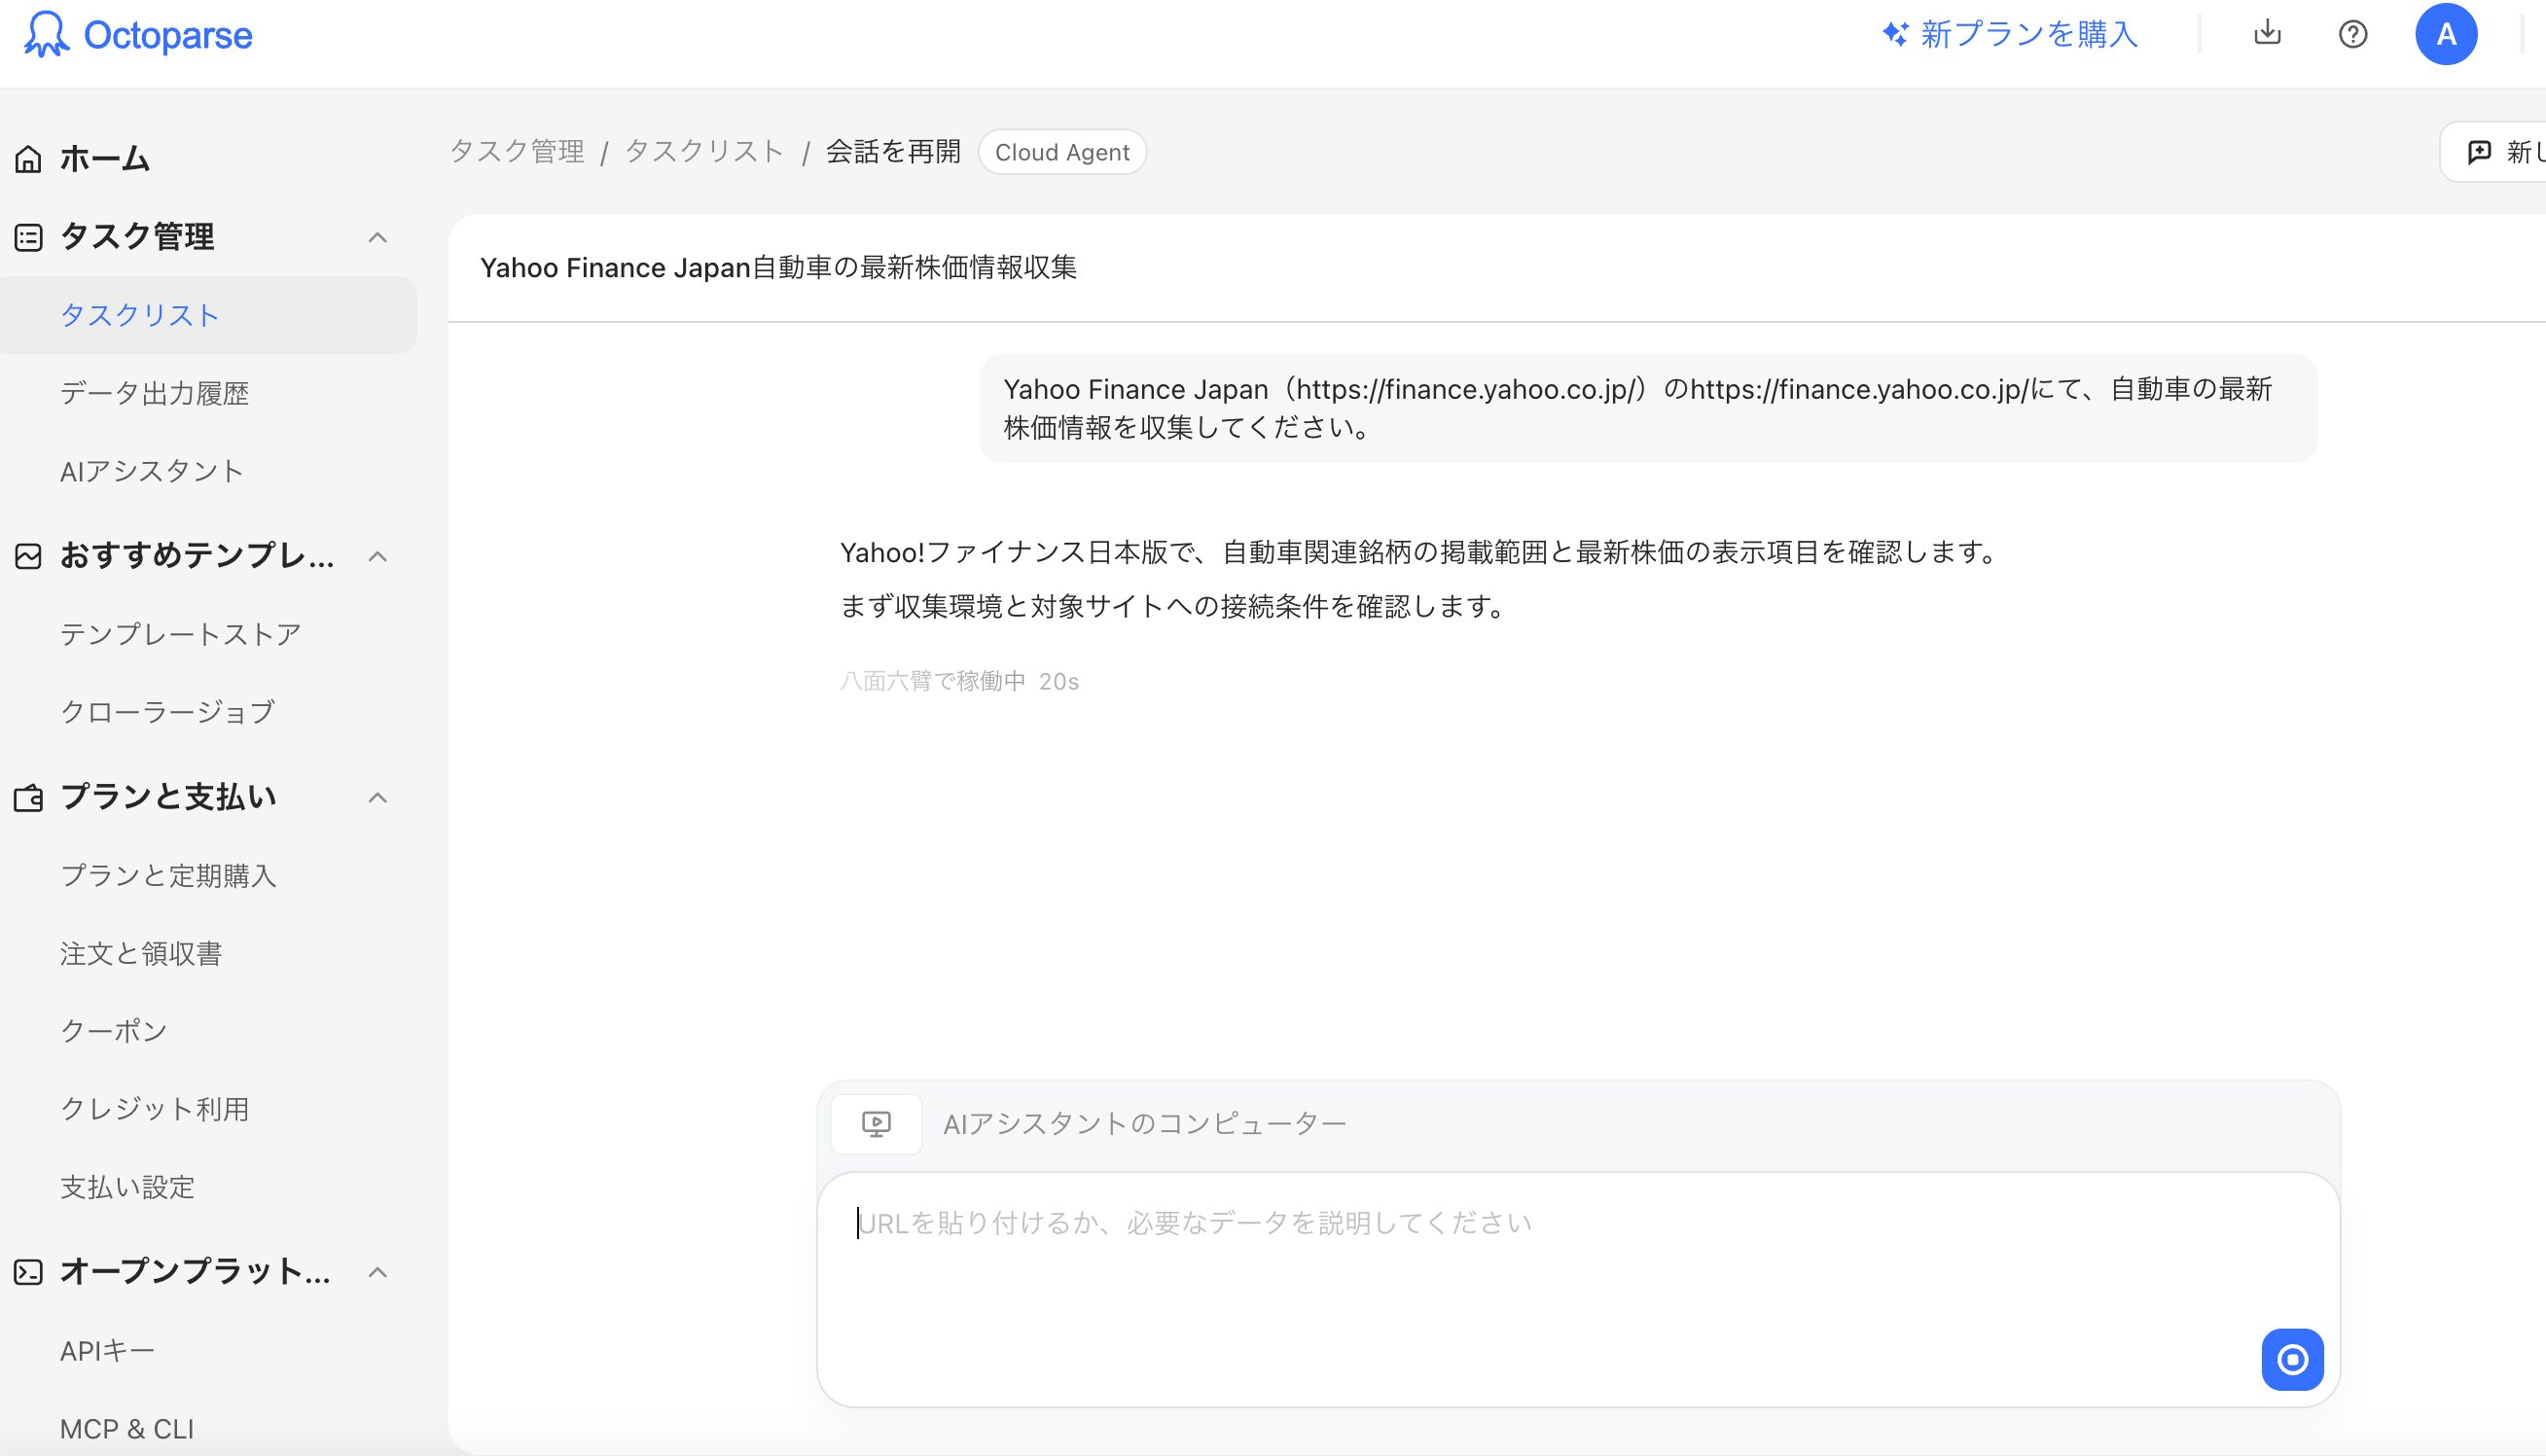
対象サイト、必要なフィールド、フィルターを、好きな言語で普段どおりに伝えます。URLを貼り付けても構いません。ここでは、「自動車の最新株価情報を収集して」を入力した。
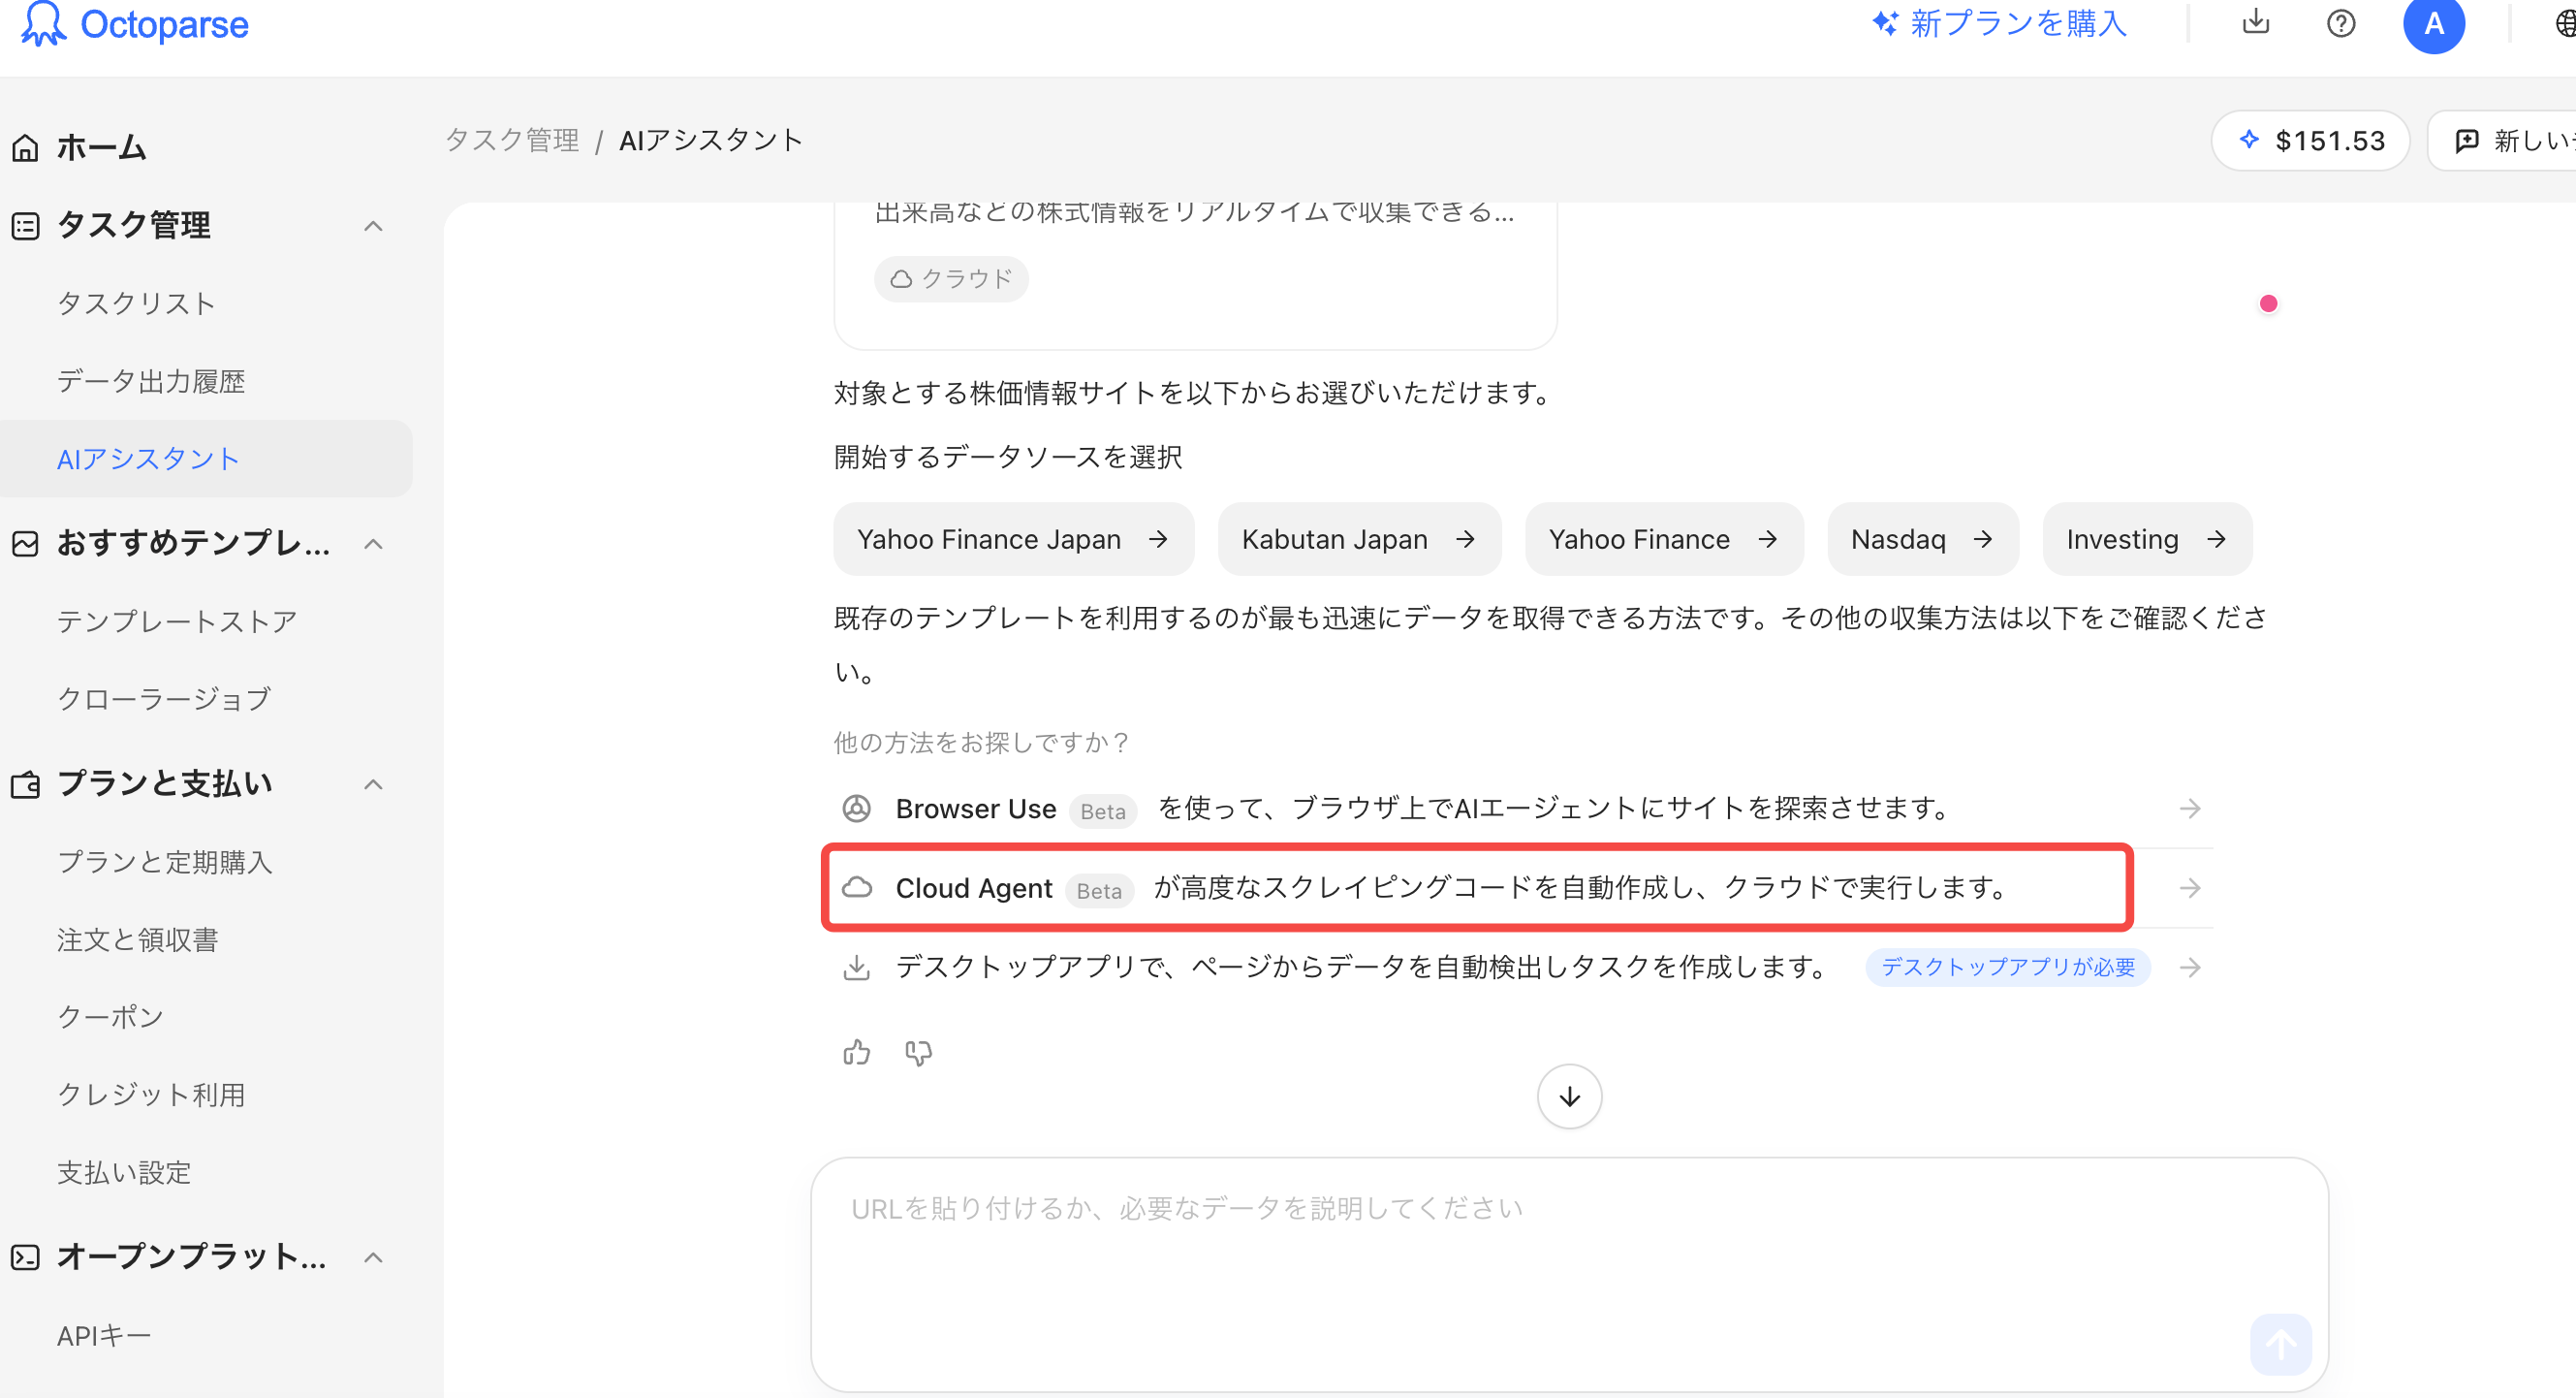
Step4:AIアシスタントが理解した内容を確認する
AIアシスタントは 「理解した要件」に、サイト、目的、制約条件としてリクエストをまとめます。内容が違う場合は、「編集」 を選択して修正し、「保存」 を選択します。
また、AIがユーザーのニーズに応じて利用できる収集方法を提案します。ここでは、テンプレート、Browser Use、Cloud Agent、自動検出などいずれも利用できるので、例としてCloud Agentを選択した。
Step5:タスクを作成・実行する
AIアシスタントは選択された方法でタスクを作成し、実行します。
Step6:取得したデータの確認・エクスポート
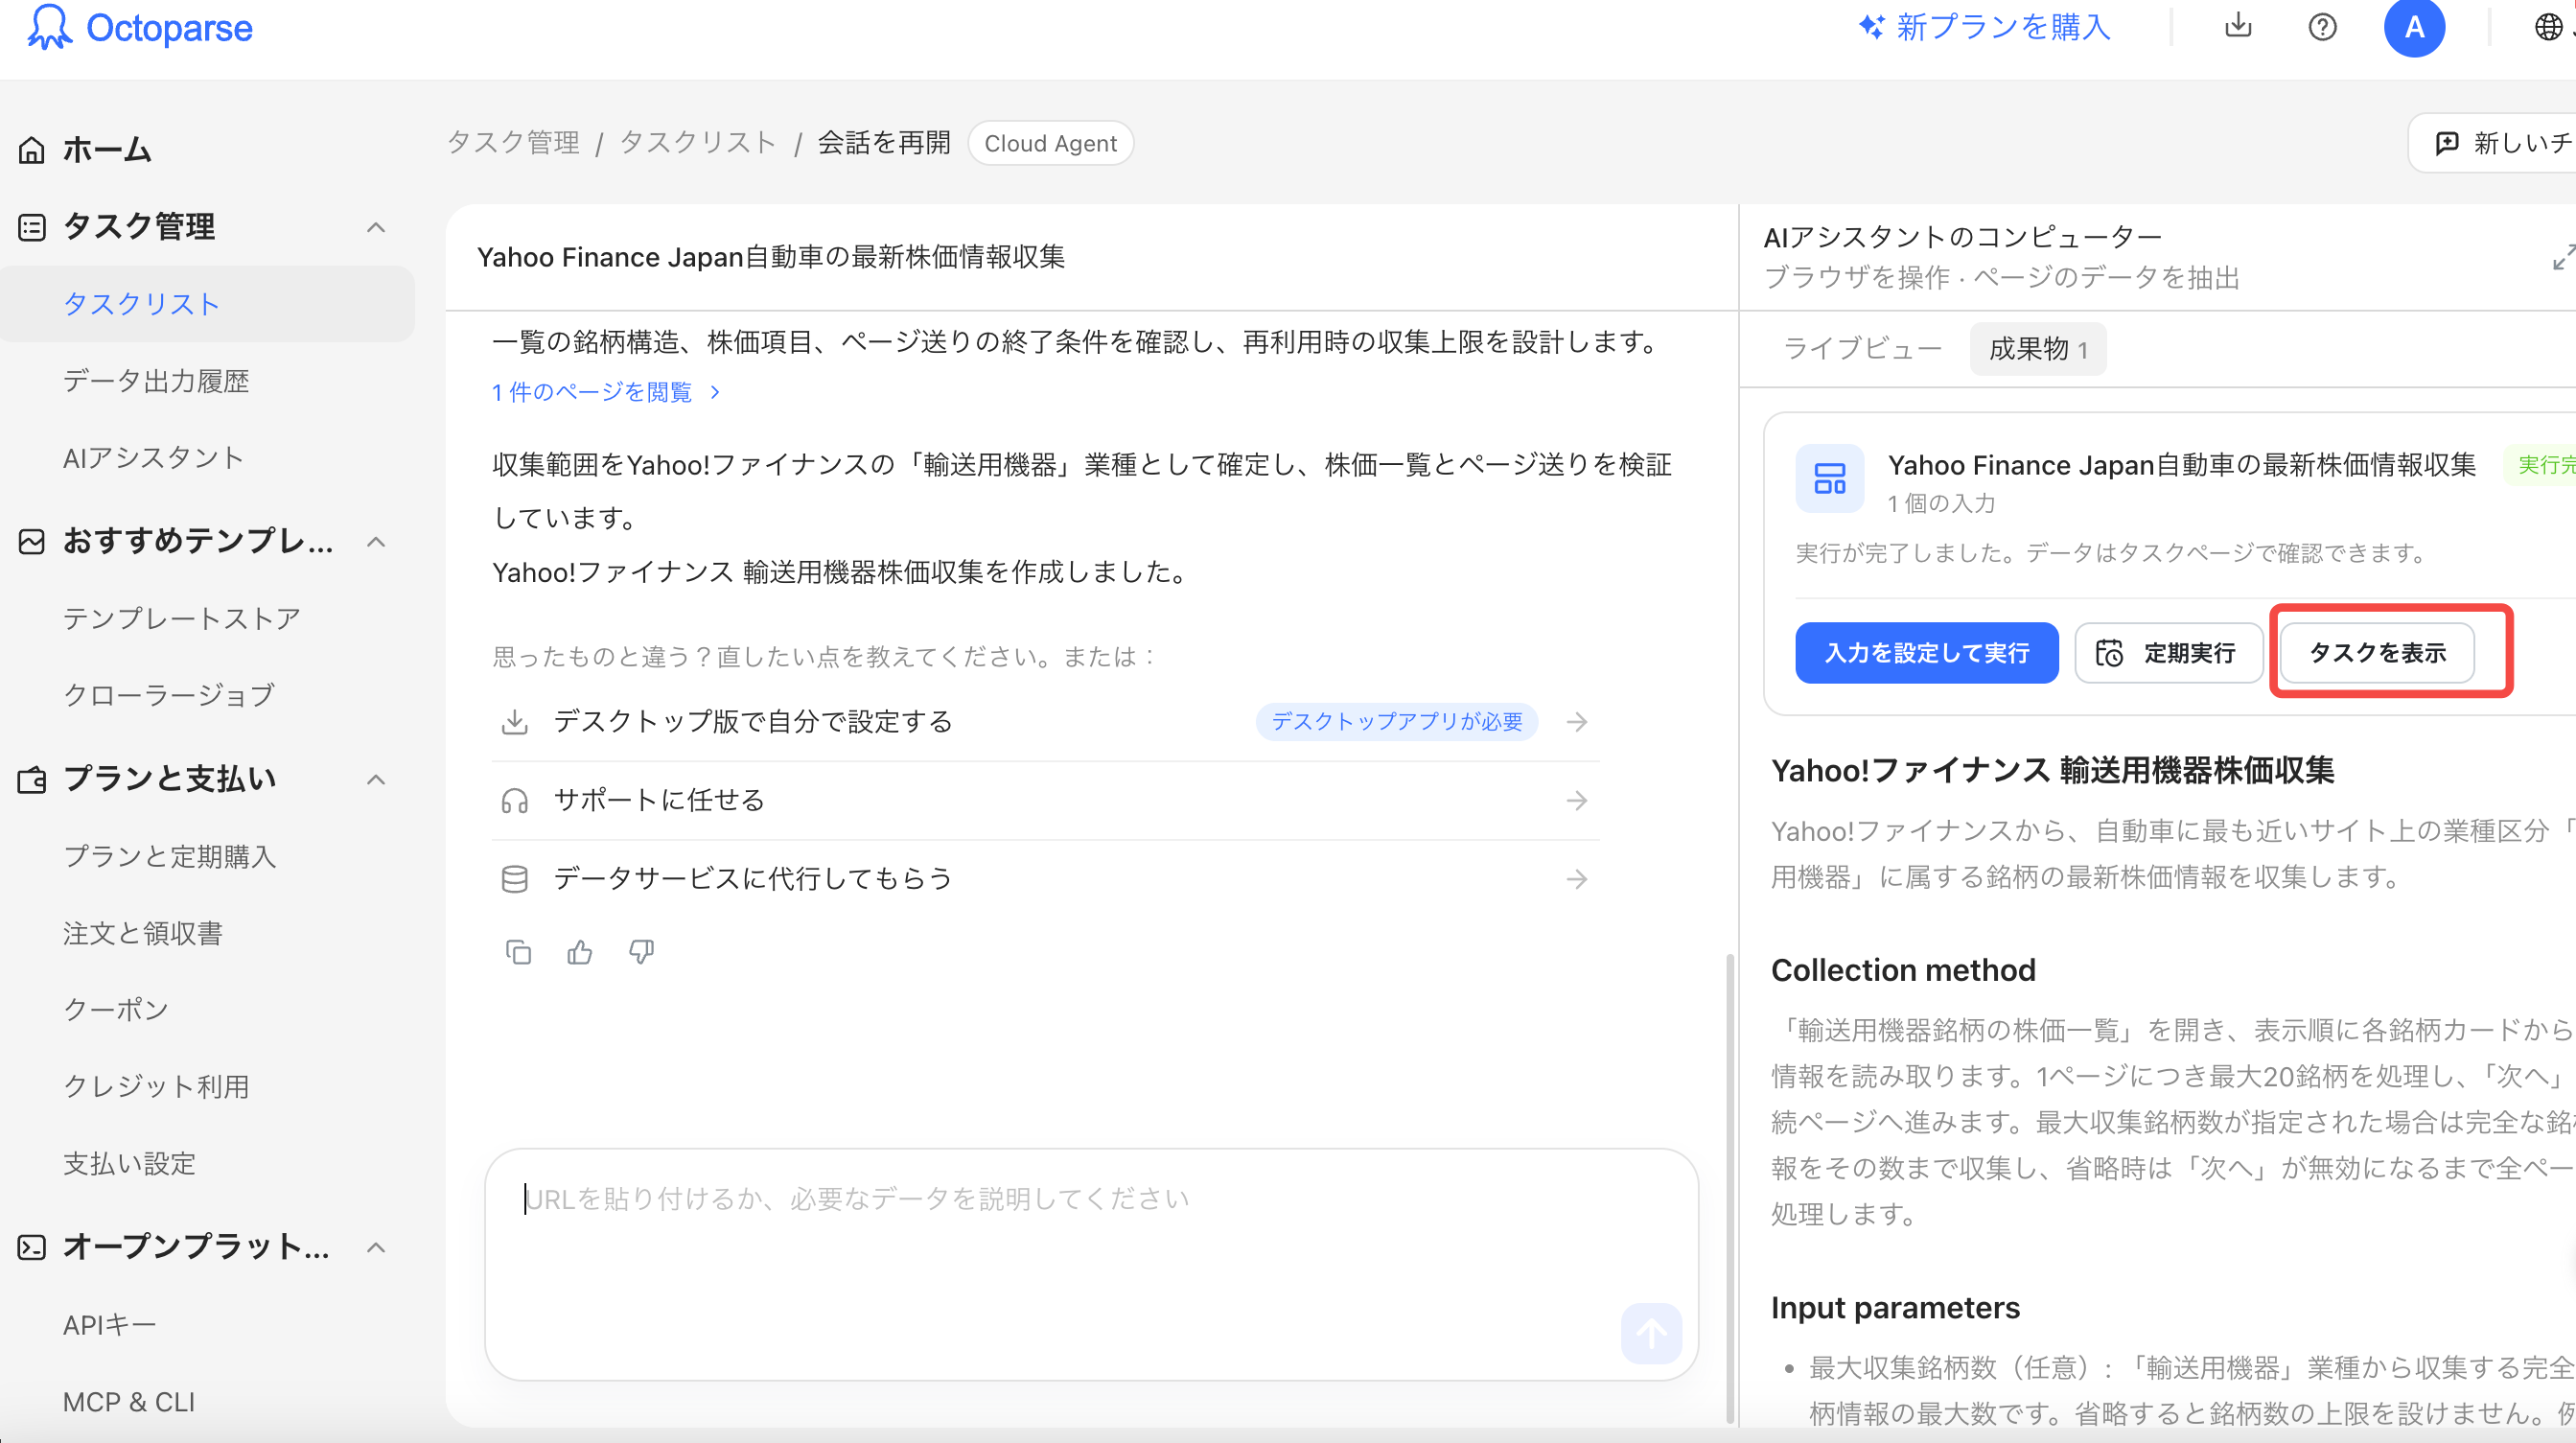
AIがタスクの実行が完了したら、「タスクを表示」をクリックし、データの確認とエクスポートを進められます。もし今後も定期的にデータを収集した場合は、定期実行も設定できます。ただし、定期実行の設定はスタンダードプラン以上で利用できます。
関連記事:
Browse AI代替ツール5選|最適なデータ収集ツールを徹底比較
開発者がOctoparse APIを選ぶ理由は?コスト・保守・連携のしやすさで考える
Webデータを自社システムに取り込む際、開発者の負担になるのは、スクレイピングコードの作成だけではありません。サイト構造の変更への対応、プロキシ管理、定期実行、エラー処理など、継続的な運用にも手間がかかります。
Octoparse APIは、こうしたデータ収集の仕組みをすべて自社で開発・維持する代わりに、既存のスクレイパーやクラウド実行基盤をAPI経由で利用できるのが特徴です。
1. 既存のスクレイパーを活用し、開発・保守の負担を減らせる
例えば、ECサイトの価格や在庫を毎日取得する場合、サイトごとにスクレイパーを開発し、ページ構造の変更にも対応し続ける必要があります。
Octoparseなら、対応する既存テンプレートを利用するか、AIアシスタント・Octoparse Desktopで専用の収集タスクを作成し、APIから実行できます。
さらに、AgentTools APIでは、既存テンプレートの検索から、パラメータを指定した新規タスクの作成・実行、結果取得まで自動化できます。
searchTemplates → executeTask → exportData
あらかじめ構築された収集機能を再利用できるため、Webページの解析やスクレイパー開発にかかる工数を減らせます。
また、Octoparse Cloudの実行基盤を利用すれば、自社でブラウザ実行環境やプロキシなどを一から用意する負担も軽減できます。
ただし、サイトや収集条件によって追加設定・保守が必要になる場合があります。コストを比較する際は、API利用料金だけでなく、自社開発や継続的なメンテナンスにかかる時間も含めて検討するとよいでしょう。
2. 自社アプリやデータ分析システムに収集機能を組み込める
例えば、競合商品の価格を監視するSaaSを開発する場合、ユーザーが商品を登録すると、Octoparse APIを通じて収集タスクを実行し、取得した価格や在庫情報を自社データベースに保存する仕組みを構築できます。
開発者はデータ収集エンジンをゼロから作るのではなく、価格比較・分析・通知など、自社サービスの主要機能の開発に集中できます。
また、マーケティング担当者がOctoparseで収集項目や条件を調整し、開発者がAPI連携を担当するという分担も可能です。収集要件が変わるたびに、開発者がスクレイピング処理をすべて書き直す負担を減らせます。
3. クラウド実行とAPI・MCP連携で、継続的なデータ活用に対応
Octoparse Cloudでは、作成済みのスクレイパーをクラウド上で実行できます。対応プランではスケジュール実行や複数タスクの並列処理も利用できるため、定期的な価格監視やデータ更新を自社サーバーだけに依存せず運用できます。
外部システムとの連携方法も、用途に応じて選択できます。
- API: 自社アプリやバックエンドからタスクを実行し、収集結果を取得する
- MCP: ClaudeやCursorなどのAIエージェントから、テンプレートや収集タスクを呼び出す
このように、Webデータの収集はOctoparse、取得したデータの分析・活用は自社システムという役割分担が可能です。
特に、EC価格監視システム、社内BIツール、営業支援アプリ、AIエージェントなど、外部Webデータを継続的に利用するサービスを開発している方に適しています。
一方、独自のスクレイピングコードを自由に作成・デプロイしたい場合や、少量の公開データをたまに取得するだけの場合は、自社実装や他のAPIサービスのほうが適していることもあります。
| 開発者の判断軸 | Octoparseを選ぶ理由 | 比較時に残る確認事項 |
|---|---|---|
| コスト | テンプレート・再利用タスク・運用基盤を一緒に評価できる | プランと従量課金、移行・保守時間まで含む総額 |
| 操作・変更 | 業務側がタスクを準備し、開発者が利用側を担当できる | 変更可能な入力、列構成、APIの対応範囲 |
| システム接続 | APIで既存タスクの実行や結果取得を組み込める | 認証、ページ分割、例外処理、取り込み先の実装 |
| クラウド運用 | カスタムタスクの定期・並列実行をクラウドへ寄せられる | 対象プラン、同時実行数、待機時間、必要な鮮度 |
| データ品質 | 保存した取得規則と結果を確認して再利用できる | 欠損、サイト変更、ID、重複・履歴の扱い |
導入は小さく試す:データ収集からAPI連携までの進め方
最初は、自社が管理するページや、収集・利用の許可を確認したページで、必要な列が取得できるかを検証します。ここでは、商品名・表示価格・商品URLを継続取得する場合の設計例を示します。実測結果や特定テンプレートの操作手順ではありません。
- 対象URLと必要な列、許容する欠損、取得頻度を決める。
- AI AssistantやOctoparse Desktopで再利用タスクを準備し、少数のページで結果を確認する。
- ローカルのBrowser Useモードか、Cloud Agentなどのクラウド実行かを選ぶ。定期収集には対応するクラウド実行を使う。
- クラウドで実行し、取得件数・列・取得時刻を確認する。定期実行は必要なプランと条件で設定する。
- 公式APIの現行ドキュメントで認証・権限・利用可能な操作を確認し、既存タスクの結果取得を接続する。
- 自社側で商品URLなどのキーと収集日時を使い、重複・履歴・失敗時の扱いを決める。
データを保存する場合、「新しい商品だけ追加する」のか、「同じ商品の価格を毎日残す」のかでも設計が変わります。APIが正常応答したことだけで完了にせず、必要な行が届き、下流の処理で使えるかまで確かめましょう。
Browser Use・Firecrawl・Octoparseはどんな人に向く?
| 比較項目 | Browser Use | Firecrawl | Octoparse |
|---|---|---|---|
| 向く利用者 | ブラウザ業務やAgentを設計する開発者 | RAG・検索・Web取得を組む開発者 | 業務担当者と開発者が収集を共有するチーム |
| 主な成果物 | ページ上の操作結果、ファイル、指定した出力 | Markdown、HTML、構造化JSONなど | 定型項目を持つ収集データと再利用タスク |
| 継続・自動化 | ホスト型や自前の実行構成で設計 | 取得APIやMonitorなどを利用 | 対応プランでカスタムタスクのクラウド定期実行 |
| 無料で試す際の制約 | オープンソース版にも実行資源が必要。対象新規登録者の$1は1回限り | 毎月1,000 credits。形式・機能によって消費量が変わる | 無料プランあり。取得経路ごとの行数・実行条件を確認 |
| 出力・システム利用 | 取得した結果をアプリ側で検証・処理 | APIから取得し、保存・検索などへ利用 | CSV等の出力、既存タスクのAPI接続、MCP |
| 注意する境界 | 操作が多いほどモデル・実行資源の見積もりが必要 | ページ数と構造化抽出のcreditsは同一ではない | 汎用のブラウザ業務すべてを代替する製品ではない |
Browser Useは、Web上の作業をAIに進めさせることが主目的なら有力です。Firecrawlは、ページ内容をAIアプリへ渡す取得層が欲しいときに検討しやすい選択肢です。Octoparseは、定型データの収集を継続し、業務担当者と開発者が同じ基盤を利用したいときに評価する価値があります。
Octoparseも無料で試せますが、Browser Useモードのローカル実行と、カスタムタスクのクラウド定期実行は別です。
導入前に確認したい利用条件とデータ品質
データ収集では、技術的に取得できることと、そのデータを目的の用途で利用できることを分けて確認します。対象サイトの利用規約、robots.txt、ログインが必要な情報の権限、再配布や保存の条件を確認してください。公開ページであることだけで、自由な利用が認められるわけではありません。
- APIキーやログイン情報を記事、公開コード、取得結果に含めない。
- 取得元URLと収集時刻を保存し、データの鮮度を確認できるようにする。
- 必須列の欠損、件数の急減、重複を検知し、再試行の上限を決める。
- 自動入力や送信を含む場合は、実行権限と確認が必要な操作を事前に決める。
よくある質問
Q1. Browser UseとFirecrawlの一番大きな違いは何ですか?
Browser Useは、AIによるブラウザ操作とその実行基盤が中心です。Firecrawlは、検索・取得・巡回からWeb内容をデータとして受け取る機能が中心です。両方にデータ取得と操作の機能があるため、必要な成果物と運用方法で選びます。
Q2. Browser UseとFirecrawlは無料で使えますか?
Browser Useのオープンソースライブラリは利用できますが、モデルや実行環境の費用は別です。対象者への$1 creditは1回限りです。Firecrawlには毎月1,000 creditsの無料枠があり、機能や出力形式によって消費量が変わります。
Q3. Firecrawlでもクリックやフォーム入力はできますか?
はい。Interact/Browser Sandboxでブラウザ操作を扱えます。基本的なページ取得とは使う機能と課金の単位が異なるため、操作時間やpromptの有無を含めて見積もります。
Q4. OctoparseのBrowser Useは独立製品のBrowser Useと同じですか?
本記事では別のものとして扱っています。OctoparseのBrowser UseはAI アシスタント内の収集モード名で、Octoparse in Chromeを使って自分のブラウザで実行します。このモードはクラウドの定期実行には対応しません。
Q5. 開発者にもOctoparseをおすすめできますか?
はい。Octoparse(オクトパース・オクトパス)は、テンプレートや構築済みタスクをAPIから利用し、結果を自社のシステムへつなぐ用途でも検討できます。収集基盤の運用を任せたい場合に向きますが、任意の処理をすべてコードで制御したい場合は必要なAPI範囲を先に確認してください。
Q6. Octoparse APIを呼べば収集タスクも自動で作成できますか?
APIを、任意のカスタムスクレイパーをゼロから構築する機能として捉えないでください。再利用タスクの構築はAI アシスタントやOctoparse Desktop、実行や結果取得はAPIという役割分担が基本です。対象APIの現行仕様と権限を確認して接続します。
まとめ
選定で最初に決めたいのは、AIにブラウザ上の仕事を進めさせるのか、ページ本文を集めるのか、同じ列のデータを継続して届けるのかです。目的が決まれば、モデルやcreditsだけでなく、保守・実行環境・連携まで含めて比較できます。
定型データの収集を業務へ組み込みたいなら、OctoparseのAI Assistantで対象URLと必要な項目を伝えるところから試せます。結果を確認し、クラウドでの再実行とAPI連携へ進めば、自社で担当する処理と任せる処理を具体的に判断できます。