ScrapingBeeとは、対象URLをAPIへ送ることで、プロキシの切り替えやJavaScriptの実行を含むWebページ取得を代行するクラウド型のWebスクレイピングAPIです。自社アプリやデータ基盤へWeb取得機能を組み込みたい開発者には便利ですが、受け取ったHTMLを解析して表に整える処理や、複数ページを巡回する設計が別途必要になる場合があります。コードを書かずに画面上で項目を選び、ExcelやCSVまで取得したい場合は、Octoparseのようなノーコード型ツールの方が扱いやすいこともあります。
この記事では、ScrapingBeeの機能、使い方、料金、レビューで評価される点と注意点を紹介するとともに、その代替ツールについても詳しく解説します。単純に月額料金だけを比べるのではなく、「誰が設定するのか」「最終的にHTMLが欲しいのか、表形式のデータが欲しいのか」という実務上の違いから判断します。
| 状況 | 先に検討するツール | 理由 |
|---|---|---|
| 自社アプリから大量のURLを取得したい | ScrapingBee | APIを中心に既存コードやデータ基盤へ組み込みやすい |
| JavaScriptページのHTMLを取得したい | ScrapingBee | ヘッドレスブラウザとプロキシをAPIから利用できる |
| 非エンジニアが商品名や価格をExcelへ出したい | Octoparse | 画面上で項目を指定し、表形式で確認・出力できる |
| 一覧、詳細、ページ送りを一つの処理にしたい | Octoparse | 操作の流れを可視化して設定できる |
| HTTPリクエストをコードで細かく制御したい | ScrapingBee | APIパラメータとして制御しやすい |
| 業務担当者が取得項目を頻繁に変更する | Octoparse | HTML解析コードを修正せず画面上で調整しやすい |
ScrapingBeeとは?どのようなWebスクレイピングAPI?
ScrapingBeeとは、Webページを取得する際に必要となるブラウザ実行、プロキシ管理、再試行などのインフラをAPIとして提供するサービスです。利用者は対象URLと必要なオプションを送信し、HTML、JSON、Markdown、テキスト、スクリーンショットなどを受け取ります。Webページの取得部分を外部サービスへ任せ、自社側では解析や保存、分析に集中したい開発チームに向いています。
ScrapingBeeが解決する問題は?
自社でWebスクレイピングを実装すると、対象ページへアクセスするコードだけでなく、JavaScriptの実行環境、IPアドレス、タイムアウト、再試行、同時実行、エラー監視も管理する必要があります。ScrapingBeeは主にこの「ページを安定して取得するまで」の負担をAPI側へ移します。すでにBeautiful Soup、Cheerio、自社パーサー、データベースなどを持つチームほど役割を切り分けやすいサービスです。
通常のノーコードスクレイピングツールと何が違う?
違いは、標準的な完成物にあります。ScrapingBeeの中心は、コードから呼び出せる取得APIです。CSSやXPath、AIによる抽出機能もありますが、取得したデータをどこへ保存し、複数URLをどう巡回し、失敗をどう再実行するかは利用者側で設計する余地が大きく残ります。一方、ノーコード型ツールは、画面上で対象項目とページ操作を設定し、取得結果を表として確認・出力するところまでを一つの作業画面で扱います。
ScrapingBeeは現在も利用できる?
ScrapingBeeは現在も運営されています。2026年1月にOxylabsグループへの参加を発表しましたが、公式発表では既存の契約プランを維持すると説明しています。買収情報だけを見てサービス終了と判断する必要はありません。ただし、料金、Credit数、機能は変更される可能性があるため、契約時には公式ページを再確認してください。
ScrapingBeeとは何ができる?主な機能を解説
JavaScriptレンダリングとヘッドレスブラウザ
ScrapingBeeはヘッドレスChromeでJavaScriptを実行できます。最初のHTMLにはデータがなく、ページ表示後に商品情報や一覧が読み込まれるサイトで役立ちます。待機、クリック、スクロール、フォーム入力、カスタムJavaScriptなどのシナリオも設定できます。ただし、操作できることと対象サイトが自動取得を許可していることは別です。
ローテーションプロキシと地域指定
リクエストごとのプロキシ管理をScrapingBee側へ任せ、必要に応じてPremium Proxy、Stealth Proxy、地域指定を利用できます。難しい対象ほど高いCredit倍率になる可能性があるため、最初から最も高価な設定を使うのではなく、通常設定で少量を試し、失敗理由と成功率を確認してから段階的に設定を変える方が費用を管理しやすくなります。
CSS・XPath・AIによるデータ抽出
HTML全体を受け取るだけでなく、CSSセレクタまたはXPathで項目を指定し、JSONとして返す抽出ルールを利用できます。AI Queryでは「商品の価格」のような自然言語で取得内容を指定でき、AI Extract Rulesでは必要なキーを定義できます。AI抽出は便利ですが、ページ構造、表記揺れ、欠損により結果が変わるため、重要なデータはサンプル行と元ページを照合してください。
HTML・JSON・Markdown・スクリーンショット出力
現在のScrapingBeeはHTMLだけのサービスではありません。公式ページではMarkdown、テキスト、抽出JSON、スクリーンショットも案内されています。RAGやAIへ文章を渡すならMarkdown、既存パーサーを使うならHTML、画面状態の記録ならスクリーンショットというように、後工程に合う形式を選びます。
専用API・外部連携・MCP
Google検索、Amazon、YouTubeなど一部の対象には専用APIがあります。また、n8n、Make、Zapierとの連携や、AIツールから検索・取得を実行するMCP Serverも提供されています。このため「ScrapingBeeはコードを書ける人しか一切使えない」と断定するのは正確ではありません。ただし、認証情報、Credits、出力の検証は引き続き必要です。
ScrapingBeeとはいくらで使える?料金とCredits
ScrapingBeeの有料プランは月額49米ドルからで、登録時にはクレジットカード不要の1,000 API Creditsが提供されています。以下は2026年10月10日にScrapingBee公式料金ページで確認した内容です。価格はVATを含まず、将来変更される可能性があります。
| プラン | 月額 | API Credits | 同時リクエスト |
|---|---|---|---|
| 無料試用 | 0 USD | 1,000 | 登録画面で確認 |
| Freelance | 49 USD | 250,000 | 50 |
| Startup | 99 USD | 1,000,000 | 100 |
| Business | 249 USD | 3,000,000 | 200 |
| Business+ | 599 USD | 8,000,000 | 400 |
| Enterprise 14 | 999 USD | 14,000,000 | 500 |
無料で使えるのは1,000 API Credits
公式ページでは、登録時に1,000 API Creditsをクレジットカードなしで試せると案内されています。これは「毎月1,000ページを永久無料で取得できる」という意味ではありません。無料条件と有効期間は登録画面で再確認し、最も難しい対象URLを少量テストするために使うと判断材料になります。
1 Creditは1ページを意味しない
ScrapingBeeの料金で最も誤解しやすいのは、プランのCreditsをそのまま取得可能ページ数として読めない点です。公式ドキュメントでは、Classic ProxyでJavaScriptを使わない場合は1 Credit、JavaScriptを使う標準設定は5 Credits、Premium ProxyとJavaScriptの組み合わせは25 Credits、Stealth ProxyとJavaScriptは75 Creditsと説明されています。AI機能はさらに5 Credits加算されます。
| 設定例 | 1リクエストのCredit | 250,000 Creditsでの理論回数 |
|---|---|---|
| Classic、JavaScriptなし | 1 | 250,000回 |
| Classic、JavaScriptあり | 5 | 50,000回 |
| Premium Proxy、JavaScriptあり | 25 | 10,000回 |
| Stealth Proxy、JavaScriptあり | 75 | 約3,333回 |
上表は単純計算であり、取得成功数を保証するものではありません。AI抽出、再試行、対象サイトの難易度、レスポンス品質も含め、実際には「必要な項目を正しく取得できた1,000件当たりの費用」で比較してください。
ScrapingBeeの使い方は?
ScrapingBeeの使い方は、アカウント作成、API Keyの取得、対象URLへのリクエスト、出力確認、必要なオプションの追加という流れです。いきなり大量URLへ実行せず、静的ページ、JavaScriptページ、取得が難しいページを数件ずつ試すと、Credit消費と成功条件を把握しやすくなります。
Step 1:アカウントを作成してAPI Keyを取得する
ScrapingBeeへ登録し、DashboardでAPI Keyを確認します。API Keyはパスワードと同じ認証情報です。ソースコードへ直接書き込んでGitHubへ公開せず、環境変数やシークレット管理機能へ保存してください。
Step 2:Dashboardで対象URLと出力を設定する
最初は自社サイトや取得許可のあるテストページを使い、対象URLを指定します。HTML、Markdown、スクリーンショット、抽出JSONなど、後工程で必要な形式を選びます。ページ内の特定項目だけが必要なら、CSS、XPathまたはAI抽出を検討します。
Step 3:最初のAPIリクエストを送信する
Dashboardのコード例、cURL、Python、Node.jsなどからリクエストを送信します。最初の確認ではHTTPステータスだけでなく、必要な本文が返っているか、文字化けしていないか、ログイン画面やエラーページを取得していないかを確認します。
Step 4:JavaScript・Proxy・抽出ルールを追加する
必要なデータが初期HTMLにない場合はJavaScriptレンダリングを使います。通常設定でブロックされる場合に限り、利用条件を確認したうえでPremium Proxyなどを検討します。出力が大きすぎる場合は抽出ルールを追加し、必要な項目だけを返すと後工程を簡素化できます。
Step 5:Credits・エラー・データ品質を確認する
設定ごとのCredit消費、成功件数、空欄率、重複、応答時間を記録します。取得できたHTMLの件数だけでなく、必要な項目が正しく入った件数を成功と定義してください。対象サイトごとに条件が違う場合は、ドメイン別に設定と費用を分けて管理します。
ScrapingBeeとはどんなメリットがあるツール?
ブラウザとプロキシ基盤を自社運用しなくてよい
ScrapingBeeの大きな利点は、ヘッドレスブラウザやプロキシの運用を取得APIへまとめられることです。ブラウザの更新、IP管理、インフラ監視に使う時間を減らし、抽出ロジックやデータ活用へ集中できます。
既存アプリやデータ基盤へ組み込みやすい
Web APIとして呼び出せるため、既存のバックエンド、ジョブキュー、データパイプライン、AIアプリへ接続しやすい設計です。自社側に解析、保存、監視の仕組みがあるほど、ScrapingBeeの役割をページ取得層として明確にできます。
動的ページと複数の出力形式に対応できる
JavaScriptページ、スクリーンショット、Markdown、AI抽出などを一つのサービス内で選べます。単純なHTTPクライアントでは必要な本文を取得できない場合や、AIへ渡す文章を整えたい場合に、別々の基盤を用意せず試せる点は利点です。
ScrapingBeeのデメリットと注意点は?
Credit消費量を見積もりにくい
同じ1リクエストでも、JavaScript、Premium Proxy、Stealth Proxy、AI抽出の有無で消費量が変わります。プラン表のCredit数が大きく見えても、難しいページでは実行可能回数が少なくなります。料金ページだけで決めず、実際の対象URLで試算する必要があります。
HTML取得後の処理が残る場合がある
HTML APIから返った内容を商品名、価格、評価などの列へ変換するには、解析コードが必要です。抽出ルールやAI機能で負担を減らせますが、複数ページの巡回、重複排除、保存、再実行、データ検証まで自動的に完成するとは限りません。
非エンジニアには導入障壁がある
MCPやn8nなどの選択肢は増えていますが、API Key、HTTP、JSON、Credits、エラー処理の理解は依然として役立ちます。業務部門が自分で取得項目を変える環境では、毎回開発者へ修正を依頼する時間も総コストに含めるべきです。
日本語での運用条件を確認する必要がある
公式サイトと技術文書は英語が中心です。日本語ページの文字コードや抽出そのものはテストできますが、日本語UI、社内教育、問い合わせ対応を重視する場合は、導入前に担当者が無理なく運用できるか確認してください。
ScrapingBeeのレビュー・評判は?
ScrapingBeeのレビューでは、APIの導入しやすさ、JavaScriptページへの対応、プロキシ運用を任せられる点が評価される一方、利用量が増えたときの価格とCredit計算を注意点として挙げる声があります。レビューサイトの数値は時期や審査方法で変わるため、評価点だけでなく、投稿者がどの対象サイトと規模で使ったのかを見ることが重要です。
| 評価されやすい点 | 注意点として挙がりやすい内容 | 導入前の確認方法 |
|---|---|---|
| APIが分かりやすい | 基本的なAPI知識は必要 | 担当者がサンプルリクエストを再現できるか確認 |
| JavaScriptページを取得できる | レンダリングでCredit消費が増える | 実ページ100件程度で平均消費を測定 |
| Proxy管理を減らせる | 難しい対象は高倍率になる | 対象ドメイン別に成功単価を計算 |
| 既存システムへ組み込みやすい | 解析・保存・巡回は別設計になる場合がある | 取得後から利用までの工程図を作る |
筆者の立場では、レビューを読むだけで採用を決めるより、自社の中で最も難しいURLを数種類選び、必要項目の取得率、Credit消費、処理時間、保守作業を同じ条件で比べる方が確実です。Webスクレイピングは対象ページによる差が大きく、他社の成功例がそのまま自社へ当てはまるとは限りません。
ScrapingBeeとは誰に向いている?向いていない人も比較
| ScrapingBeeが向いている人 | ScrapingBeeが向いていない可能性がある人 |
|---|---|
| Python、Node.js、APIを扱える | コードを書かずExcelを得たい |
| HTML解析と保存処理をすでに持つ | 取得項目を業務担当者が頻繁に変更する |
| 自社アプリへWeb取得機能を組み込みたい | 一覧・詳細・ページ送りを画面で確認したい |
| 大量URLをプログラムから処理したい | Credit倍率を管理したくない |
| リクエストを細かく制御したい | 日本語UIと日本語資料を優先したい |
ScrapingBeeの代替ツールには何がある?
ScrapingBeeの代替ツールは、同じAPI型だけでなく、最終的に必要なデータと運用担当者から選びます。料金は変更されるため、下表では未検証の最新価格を並べず、製品の中心と制約を比較します。
| ツール | タイプ | データ・出力 | 継続・自動化 | 主な制限 | 適した人 |
|---|---|---|---|---|---|
| ScrapingBee | WebスクレイピングAPI | HTML、JSON、Markdown、画像など | API、外部スケジューラー、連携 | 機能別Credit倍率と後工程の設計 | 開発者、データチーム |
| Octoparse | ノーコード収集ツール | 指定項目を表形式で取得しCSV、Excel、JSONなどへ出力 | ローカル・クラウド収集、スケジュール | 高度なAPI基盤だけが目的なら適合しない場合がある | 業務担当者、アナリスト |
| ScraperAPI | WebスクレイピングAPI | HTML、一部対象の構造化データ | API、非同期処理など | Creditsと解析処理を確認 | ScrapingBeeに近いAPI型を比較したい開発者 |
| Firecrawl | AI・LLM向けWebデータAPI | Markdown、HTML、構造化データ | API、クロール、AIワークフロー | 業務向けの視覚的な抽出設定とは目的が異なる | RAG、AIエージェント開発者 |
| Apify | クラウド実行基盤・Actorマーケット | Actorごとに対象と出力が異なる | スケジュール、API、Webhook | プラットフォーム費用とActor条件を個別確認 | 既製処理とカスタム開発を組み合わせたいチーム |
| Scrapy・Playwright | 自社開発 | 実装次第 | 自社でサーバー、監視、再試行を構築 | 開発、Proxy、障害対応、保守を自社負担 | 自由度と内部統制を優先する開発組織 |
ScrapingBeeの代替としてOctoparseを選ぶ理由は?
「Webサイトからデータを集めたいけれど、プログラミングはできない」「APIの設定やスクレイピングの仕組みを学ぶ時間がない」——そんな方には、ScrapingBeeよりもOctoparseが使いやすい選択肢です。
Octoparse(オクトパース・オクトパス)は、プログラミング不要でWeb上の情報を自動収集できるノーコードAIデータ収集ツールです。
ScrapingBeeは、APIを使ってWebページの情報を取得する開発者向けのサービスですが、Octoparseなら専門的な知識がなくても、商品価格、企業情報、口コミ、求人情報などを収集し、ExcelやCSVなどの形式で活用できます。
さらに、Octoparseは従来のノーコード操作に加え、AI Agentによる自然言語でのデータ収集にも対応。複雑な設定を覚える代わりに、AIに「どんなデータが欲しいか」を伝えるだけで、Webデータの取得を始められます。
AI Agentで、専門知識がなくてもデータ収集を自動化
従来のスクレイピングツールでは、APIの設定や取得項目の指定、スクレイピング処理の構築など、データを取得するまでに専門知識や準備が必要になることがあります。
OctoparseのAI Agentなら、収集したいデータを自然言語で伝えるだけで、目的に合わせた方法でデータ収集を始められます。 プログラミングやスクレイピングの知識がなくても、次の3つの方法を利用できます。
- AIによるテンプレート提案: 「Amazonの商品価格を収集したい」「Googleマップから店舗情報を取得したい」などと入力すると、AIが目的に合った既存のスクレイピングテンプレートを提案します。ユーザーは提案されたテンプレートから、複雑な設定を行わずにデータ収集を始められます。
- Browser Use: AIエージェントがブラウザを直接操作し、Webサイトを探索しながら必要な情報を取得します。ユーザーがページを一つずつ開いたり、手作業で情報をコピーしたりする負担を減らせます。
- Cloud Agent(Beta): 自然言語で収集したいデータや条件を指示すると、AIがスクレイピングタスクを自動作成・実行します。ユーザー自身が複雑な収集フローを一から構築する必要がなく、データ収集の自動化をより簡単に実現できます。
つまり、「どうやってデータを取得するか」を自分で考えるのではなく、「どんなデータが欲しいか」をAIに伝えるだけ。 Octoparseは、従来のスクレイピングで必要だった設定や操作の負担を軽減し、初心者でもデータ収集に取り組みやすい環境を提供します。
Octoparseの使い方は?
ここでは、事前に準備したテンプレートによるデータ収集方法とAI Agentによるデータ収集方法について詳しく紹介します。対象には自社サイト、許可を得たページ、スクレイピング練習用ページなどを使い、最初は数ページで検証してください。
テンプレートでのデータ収集方法
Step 1:Google Maps用テンプレートを選択する
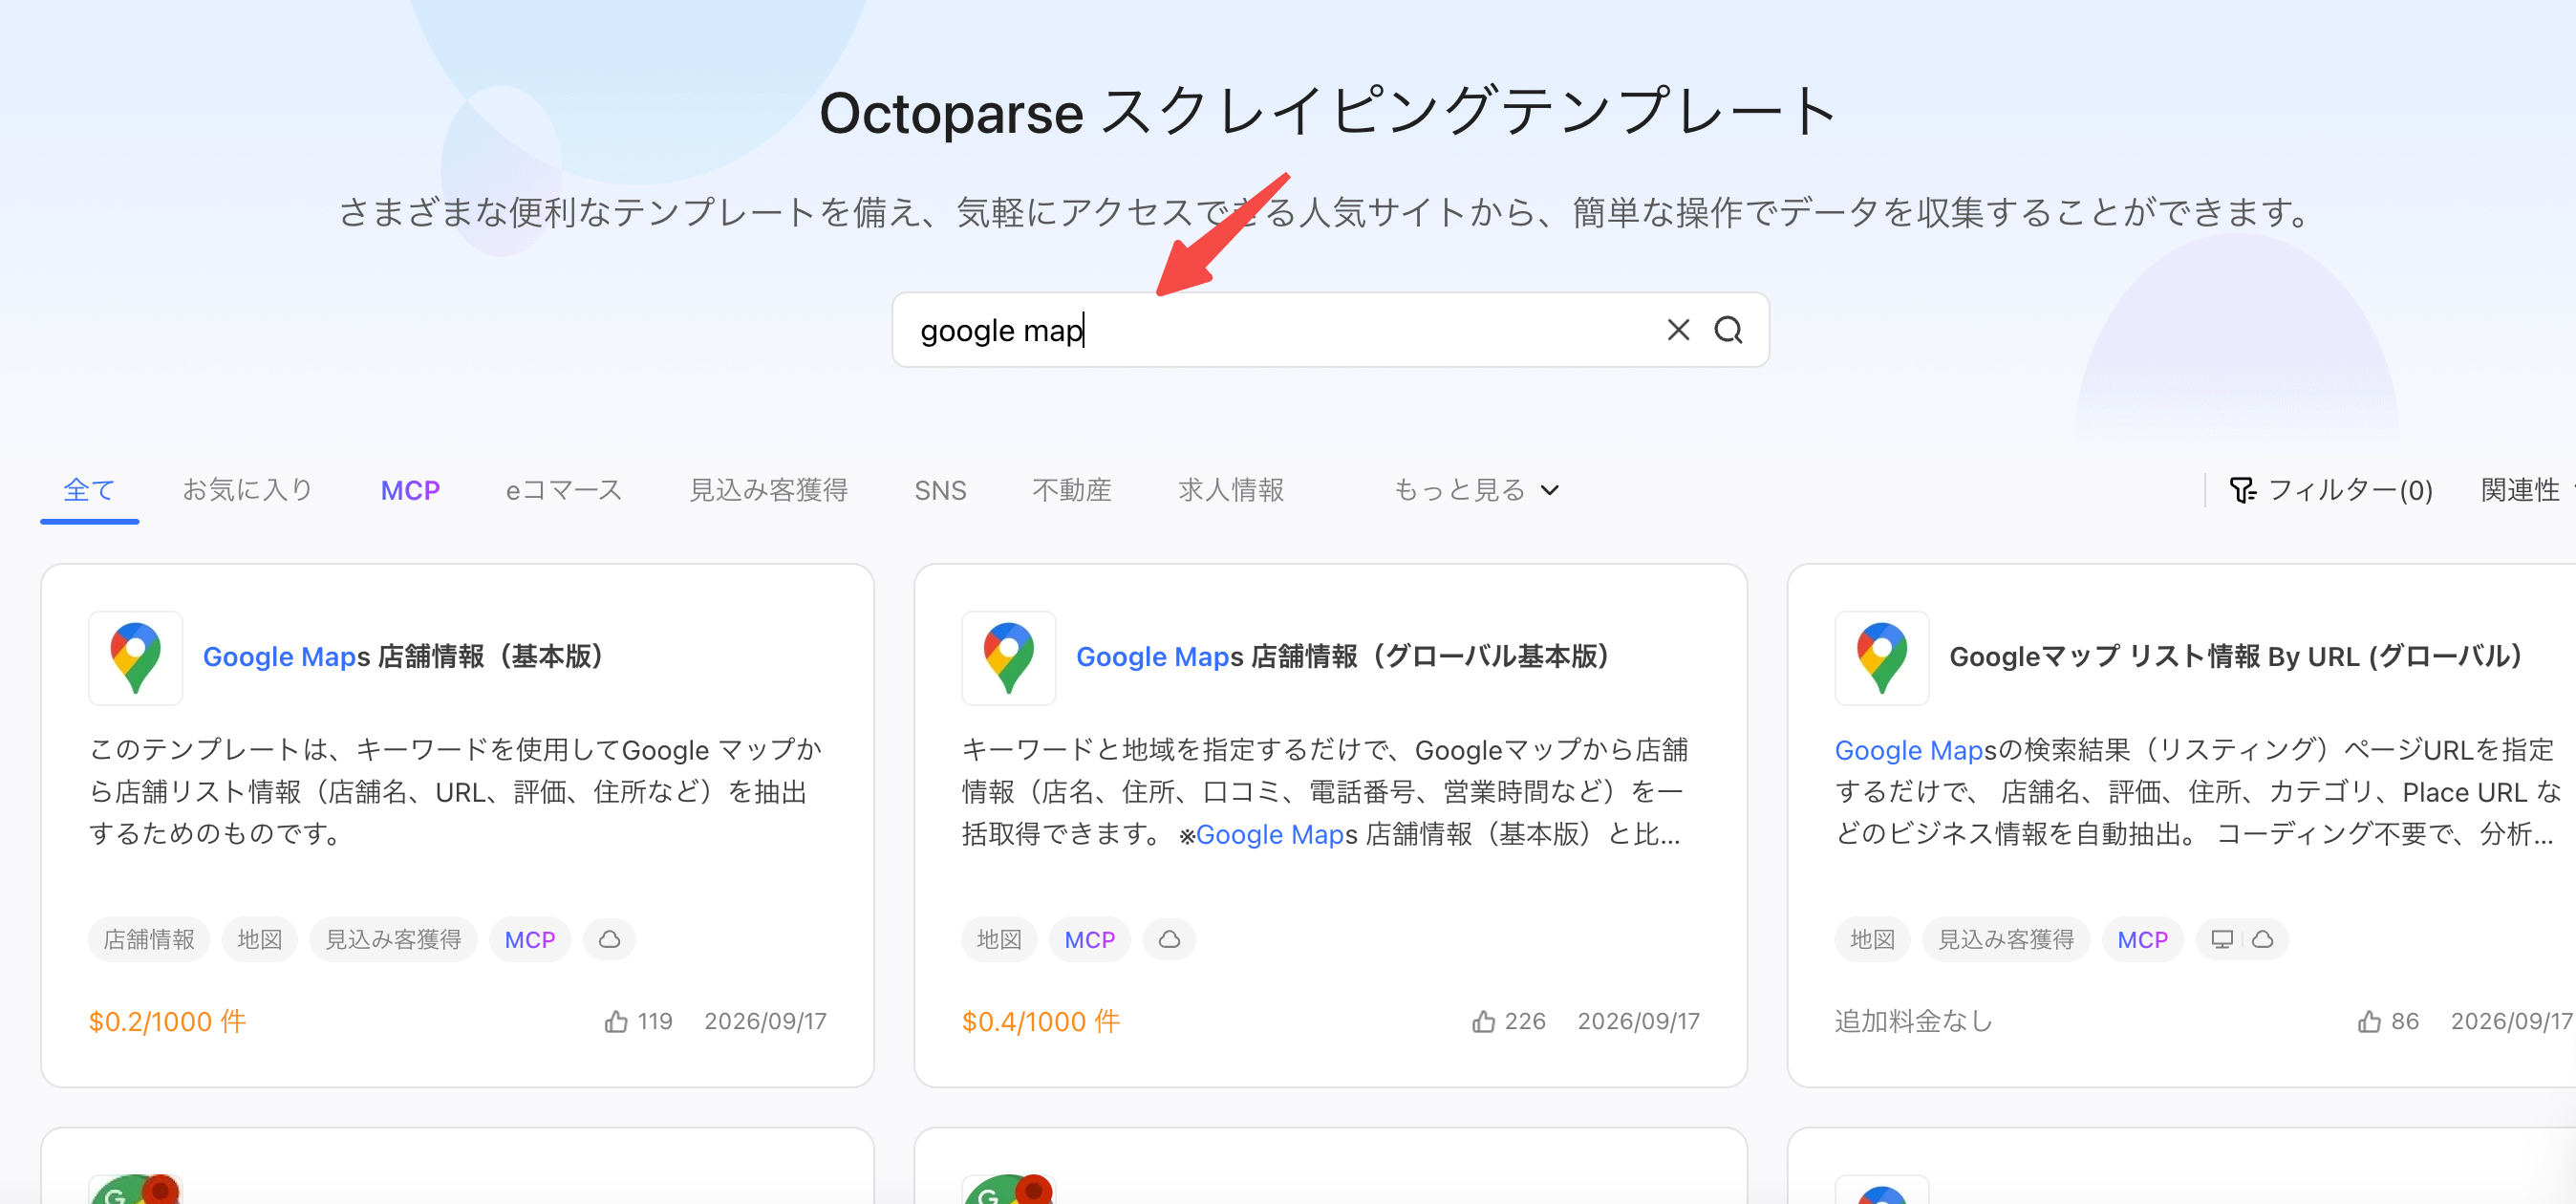
Octoparseへログインし、ホーム画面またはテンプレートギャラリーで「Google Maps」を検索します。店舗一覧、レビュー、連絡先など目的によってテンプレートが異なるため、必要なフィールドと実行条件を確認して選択します。この例では、Google Maps 店舗情報(基本版)を候補とします。
Step 2:検索キーワードを入力する
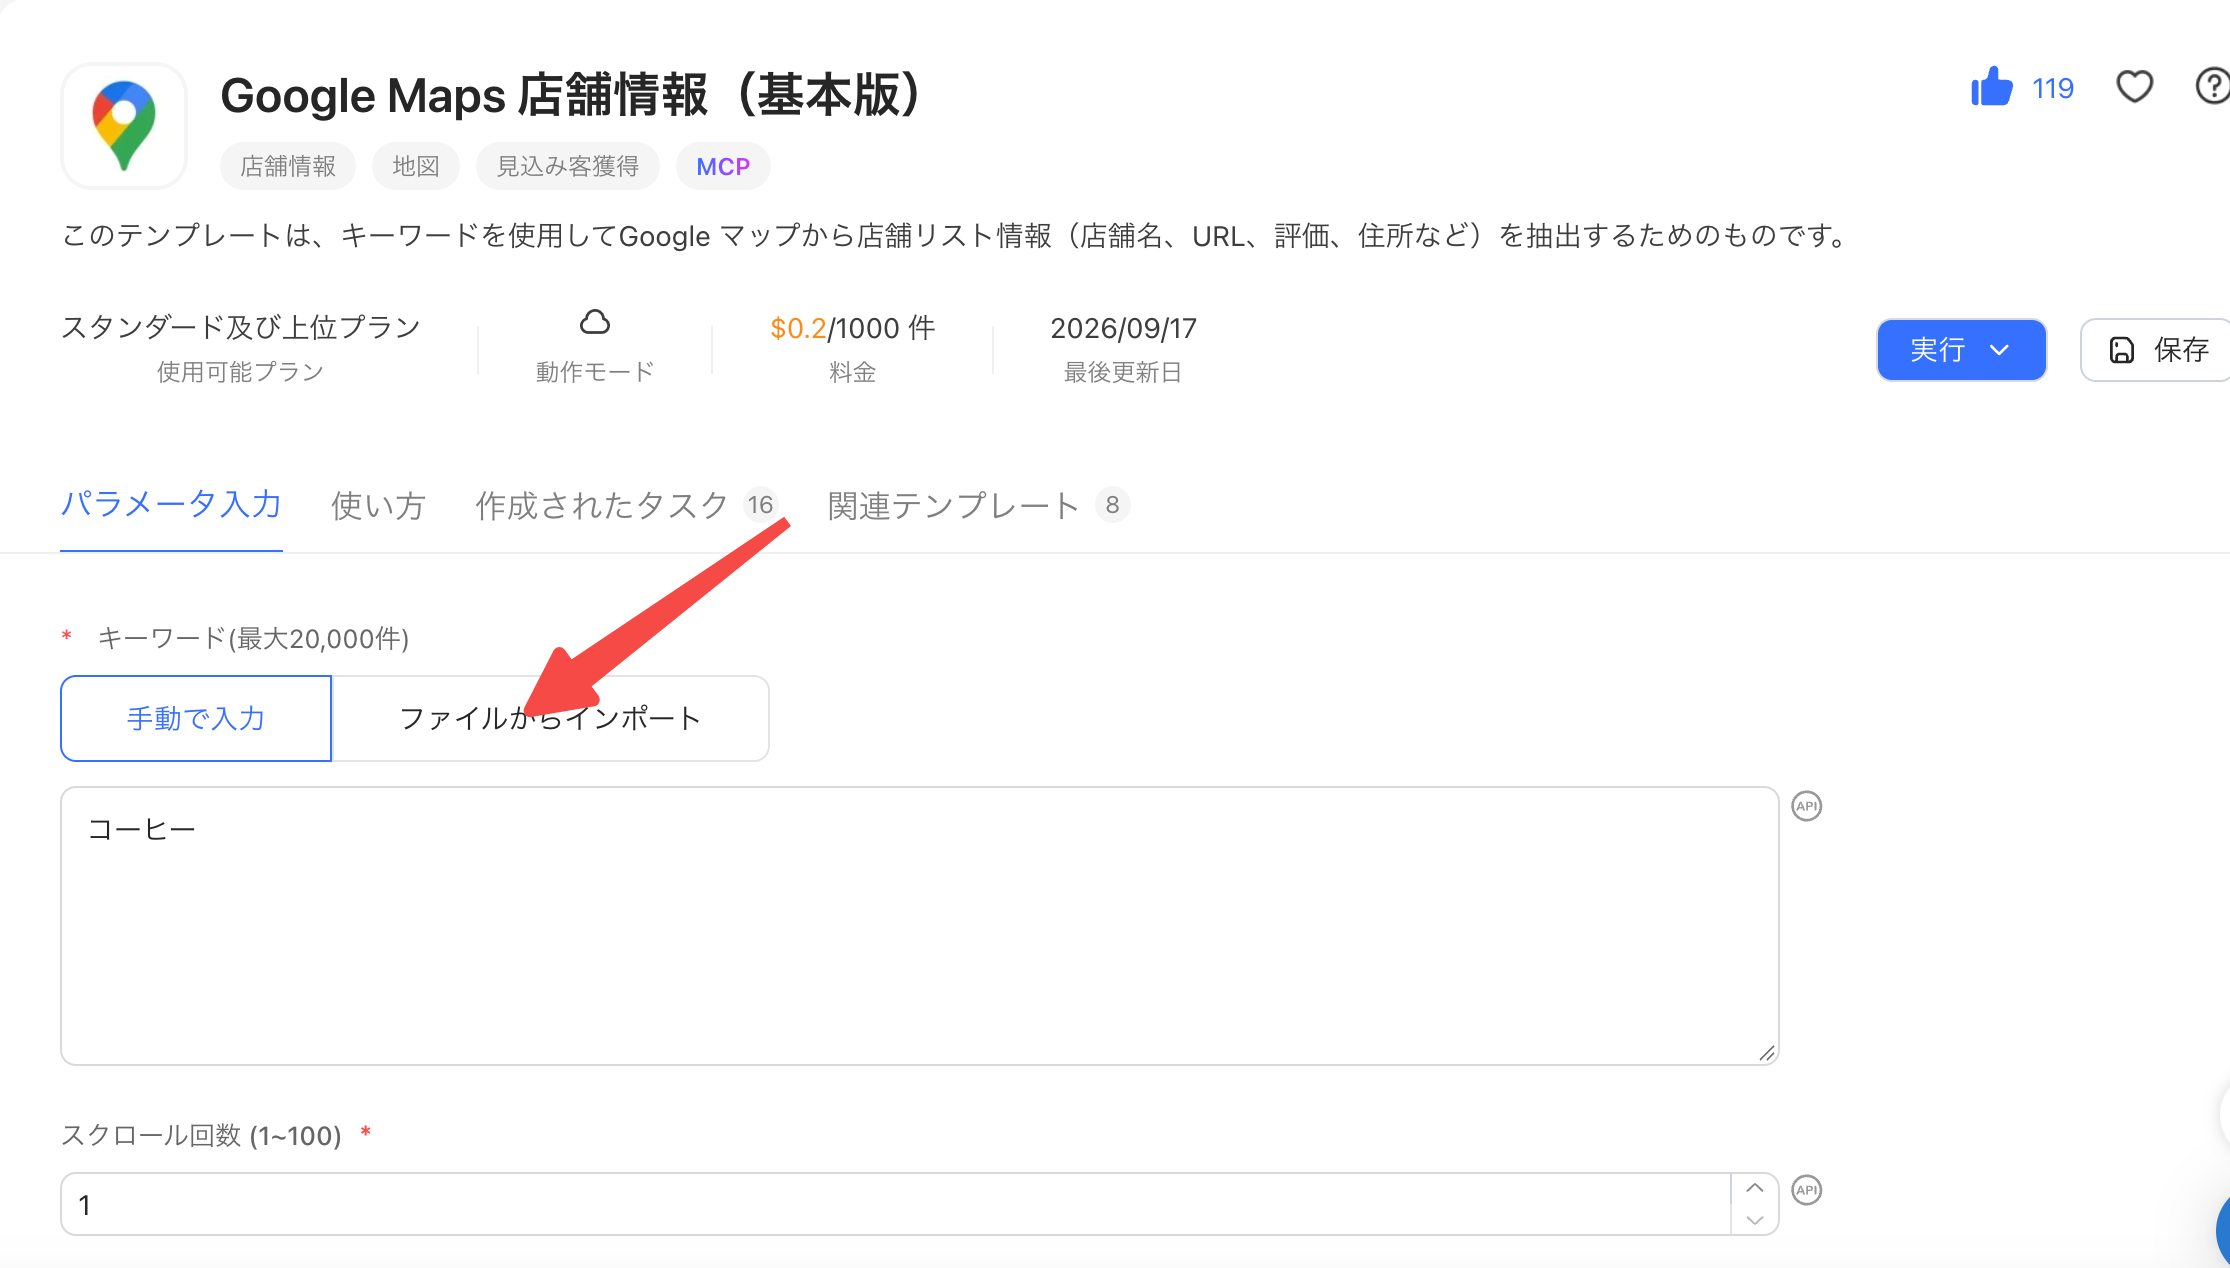
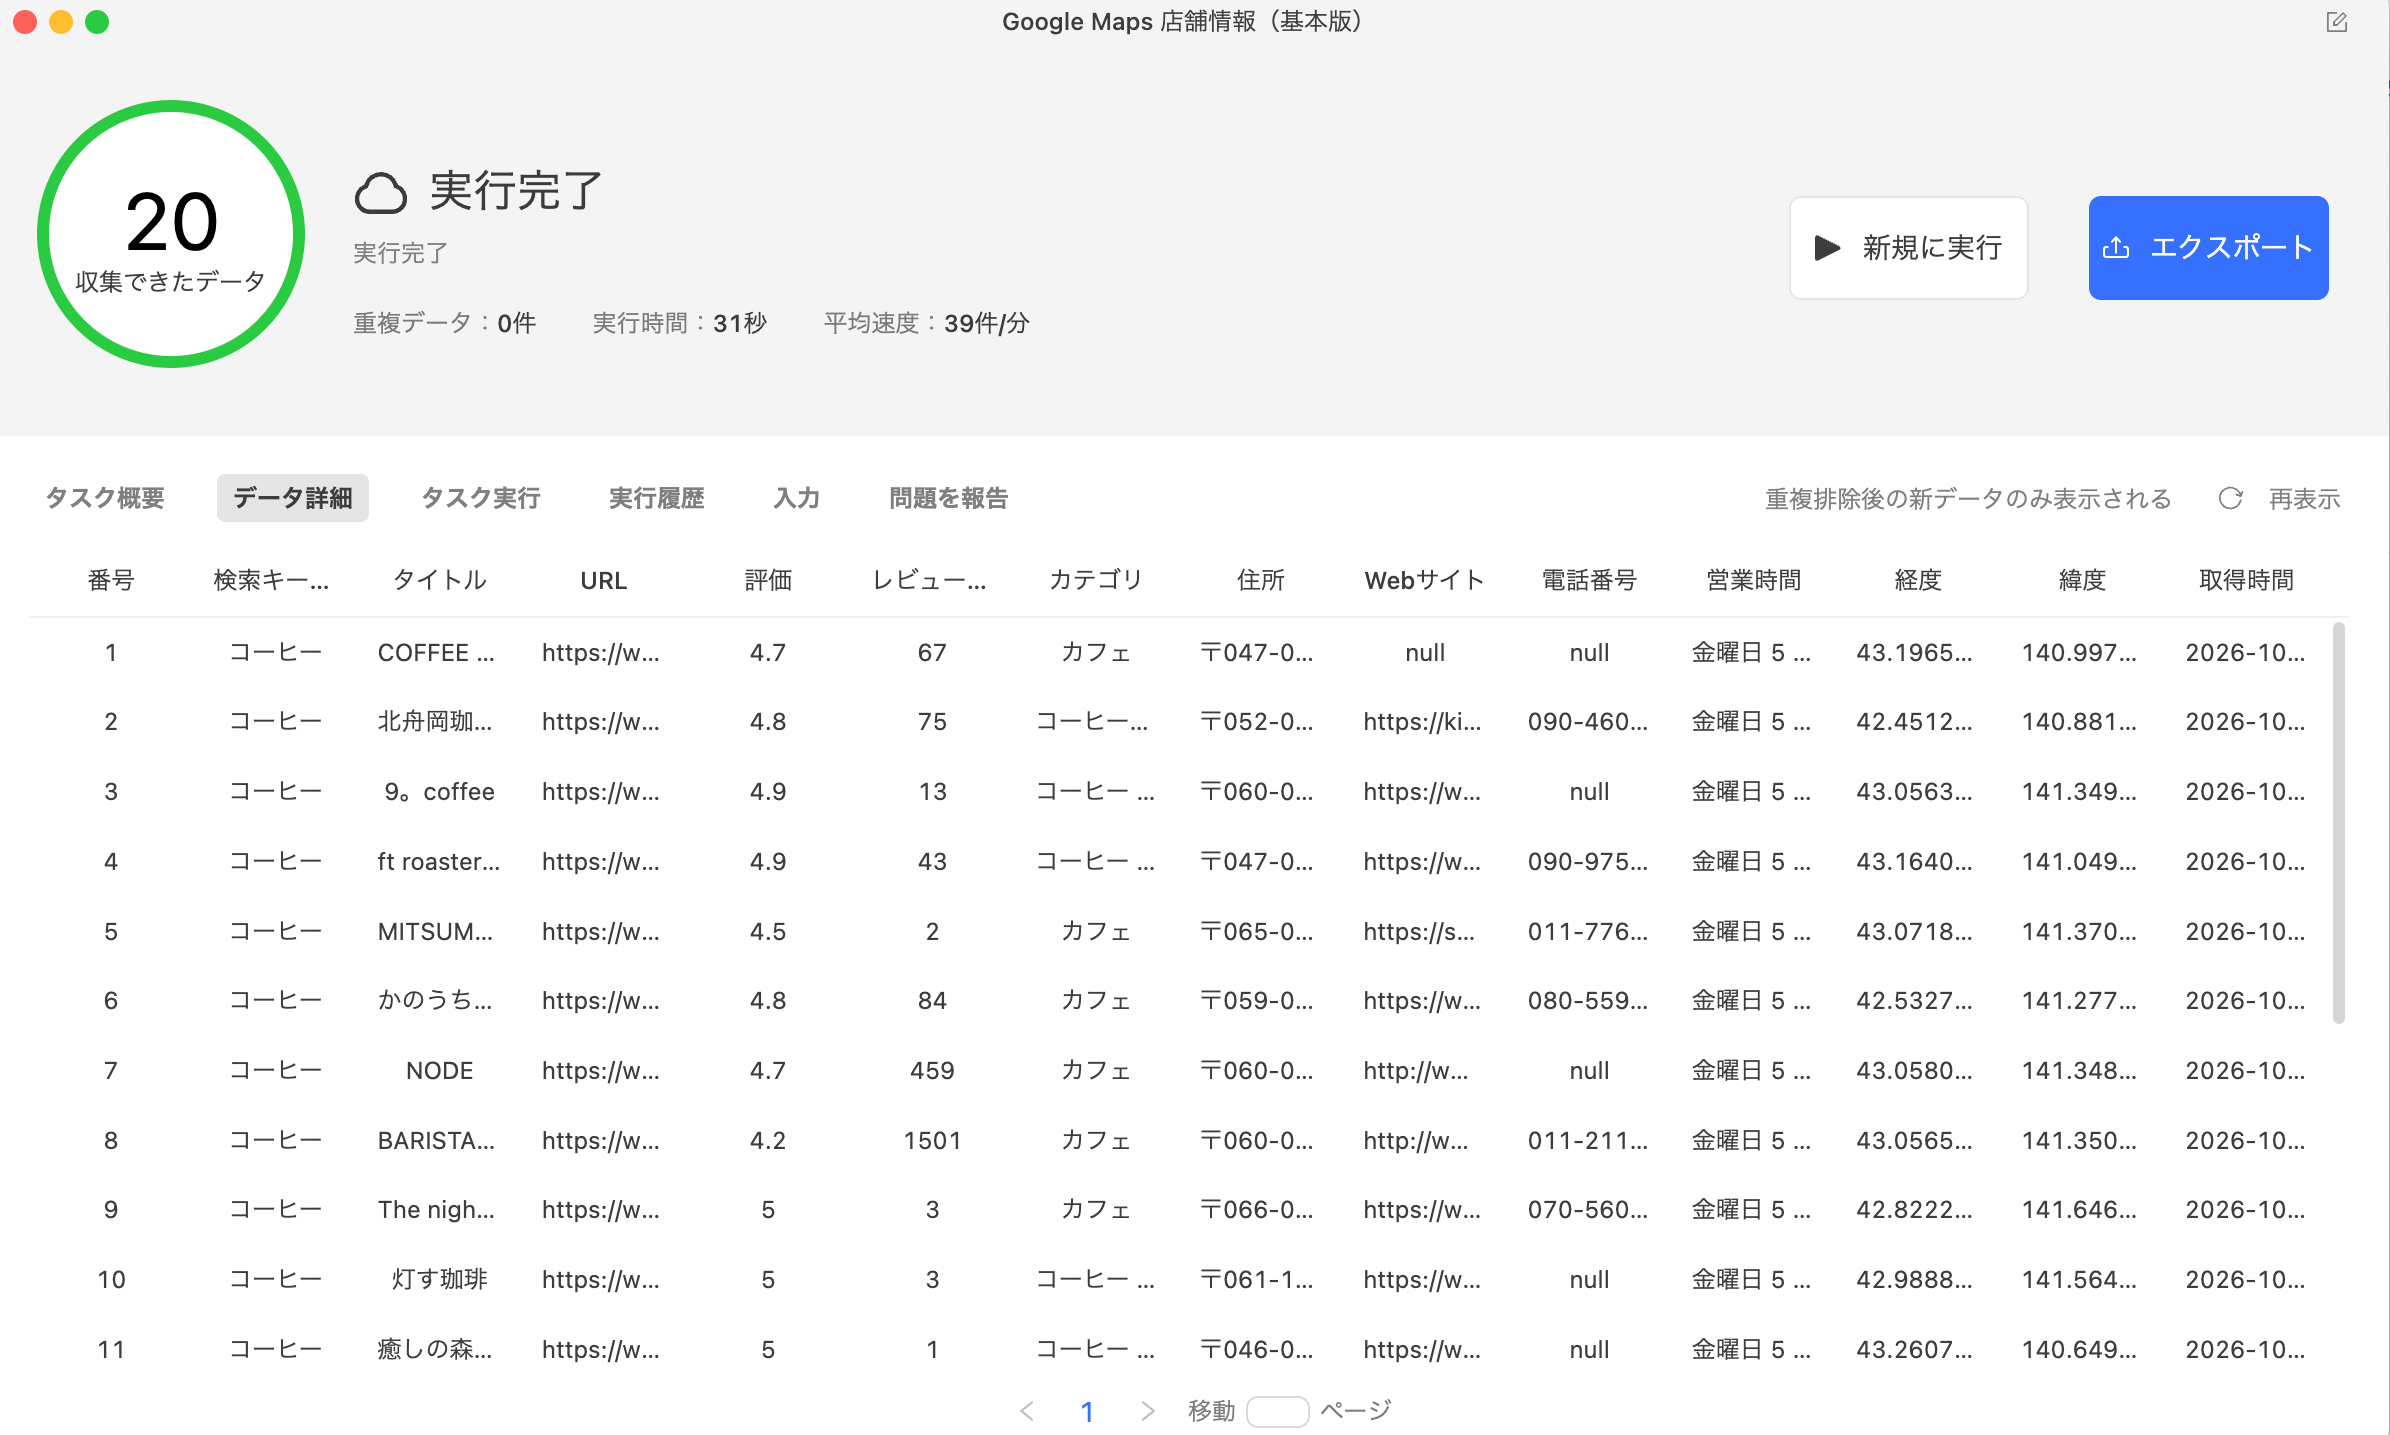
選択したテンプレートにフィールドなどを入力します。ここでは、キーワードを「コーヒー」と設定し、スクロール回数を1回と設定しました。
Step 3:データの収集を始める
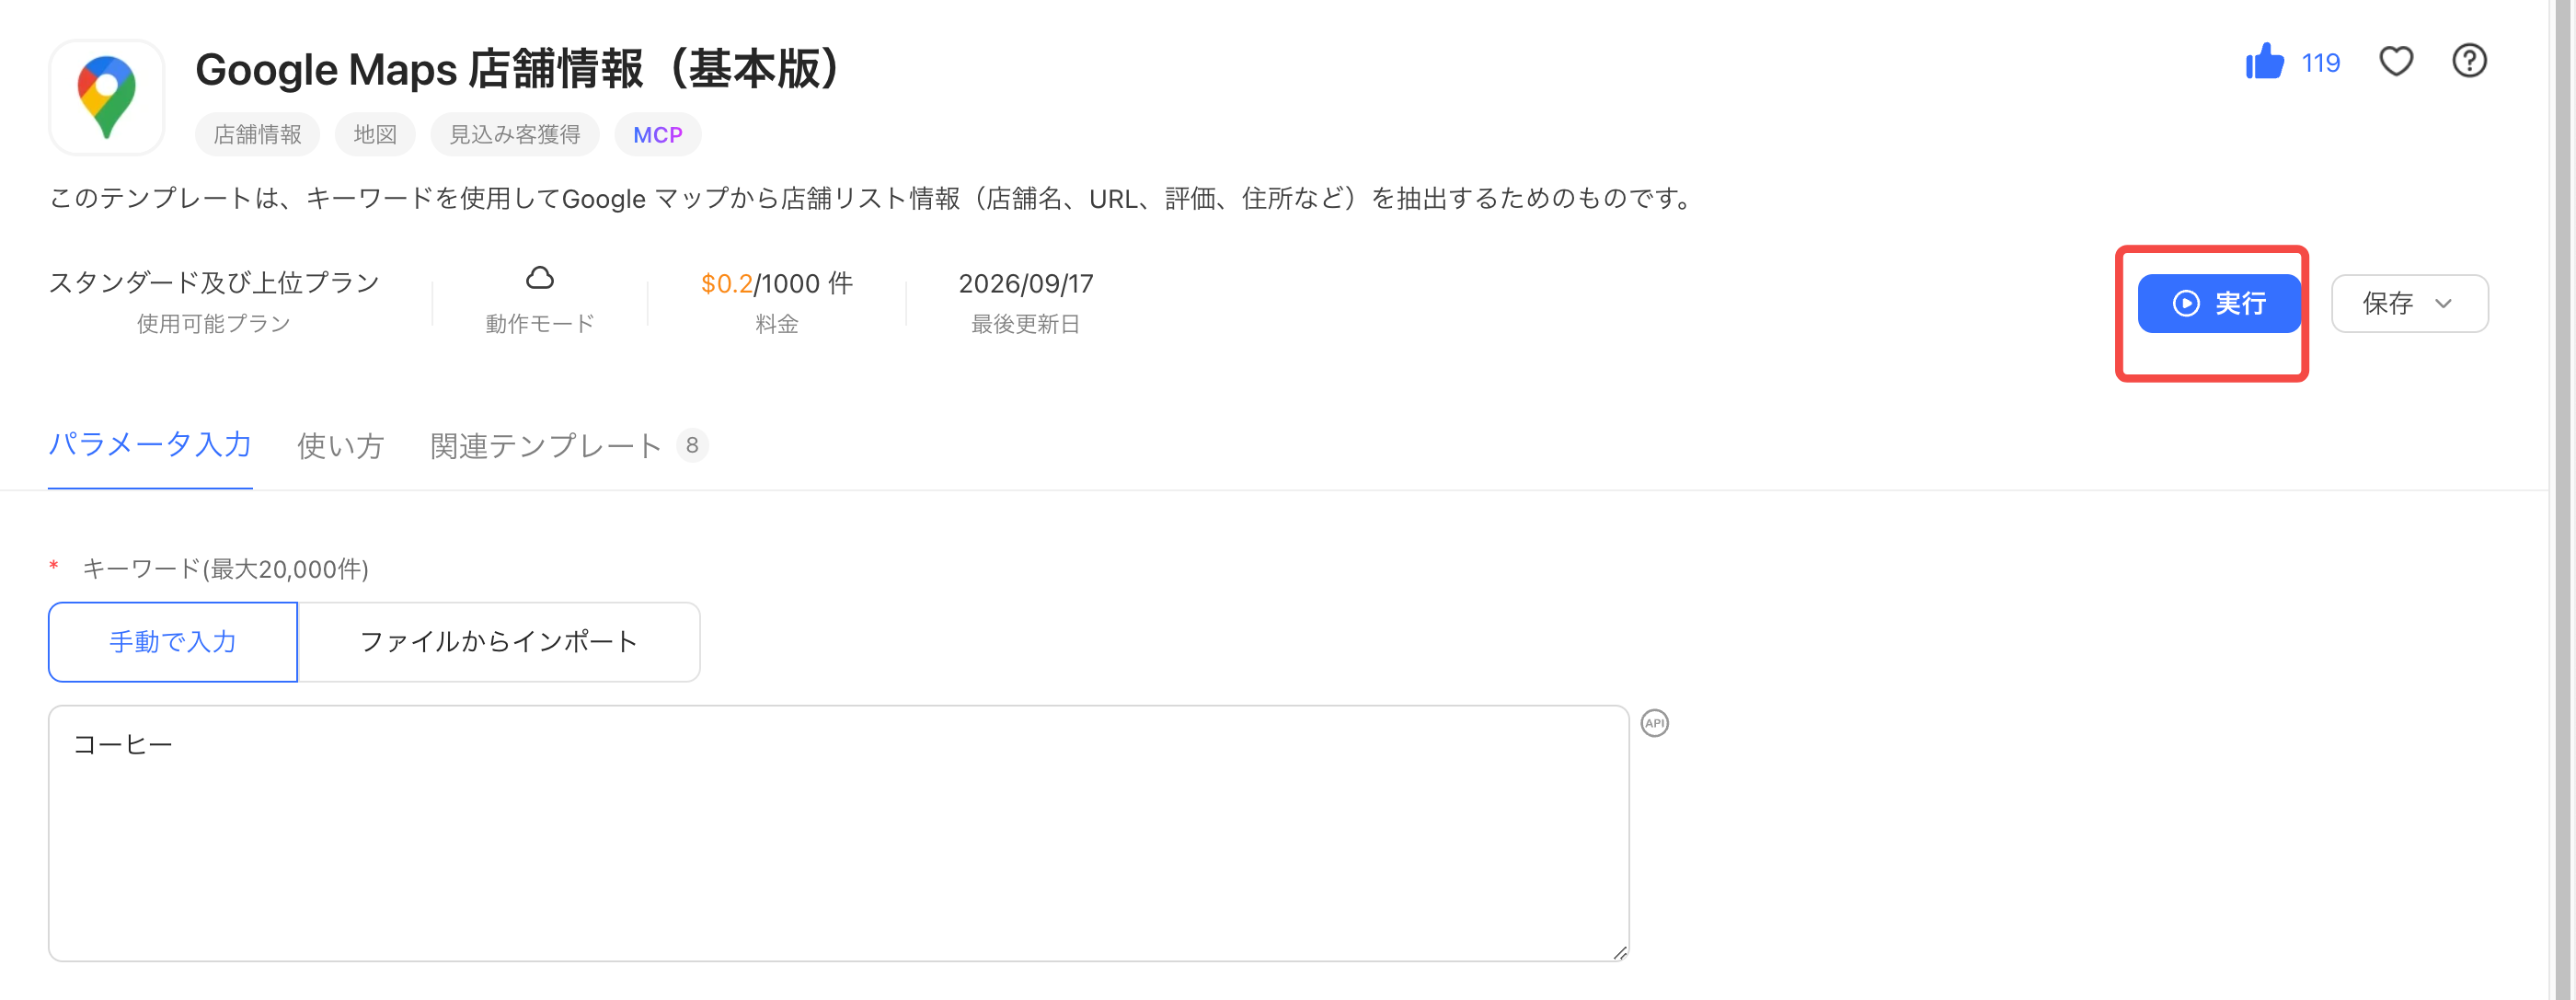
「実行」をクリックし、データの収集を始めます。
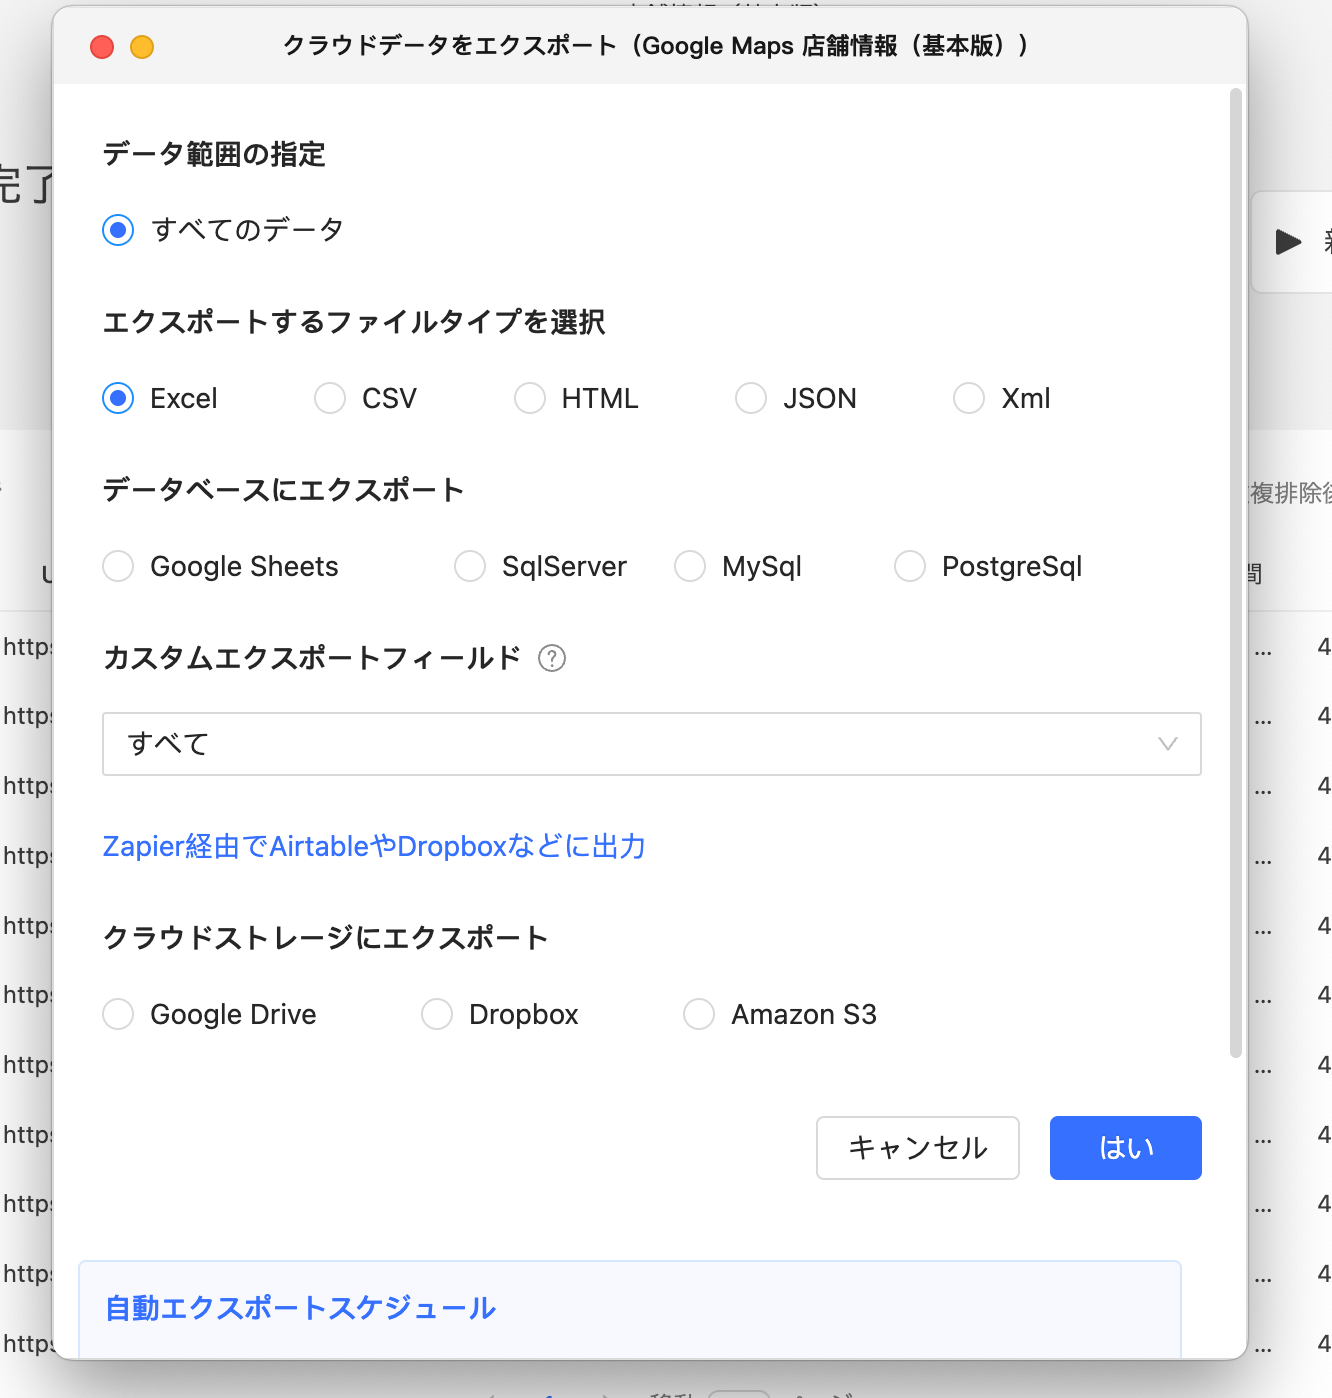
Step 4:データをExcelまたはCSVへエクスポートする
取得した結果を確認し、必要な範囲をExcelまたはCSVへエクスポートします。取得日時、検索キーワード、対象地域、テンプレート名も別列または管理台帳に記録すると、再実行時に比較しやすくなります。Google Mapsの規約上、取得データの保存や外部利用が認められるかは、エクスポート前に改めて確認してください。Google Mapsに特化した方法と注意点は、店舗情報を収集する方法の解説も参照してください。
関連記事:
Google Mapスクレイピングの方法|AI活用・営業リスト作成・注意点
AI Agentによるデータ収集方法
Step 1:Octoparseのアカウントを作成
Octoparseでアカウントがない場合、まずは新規アカウントを作成し、ログインします。
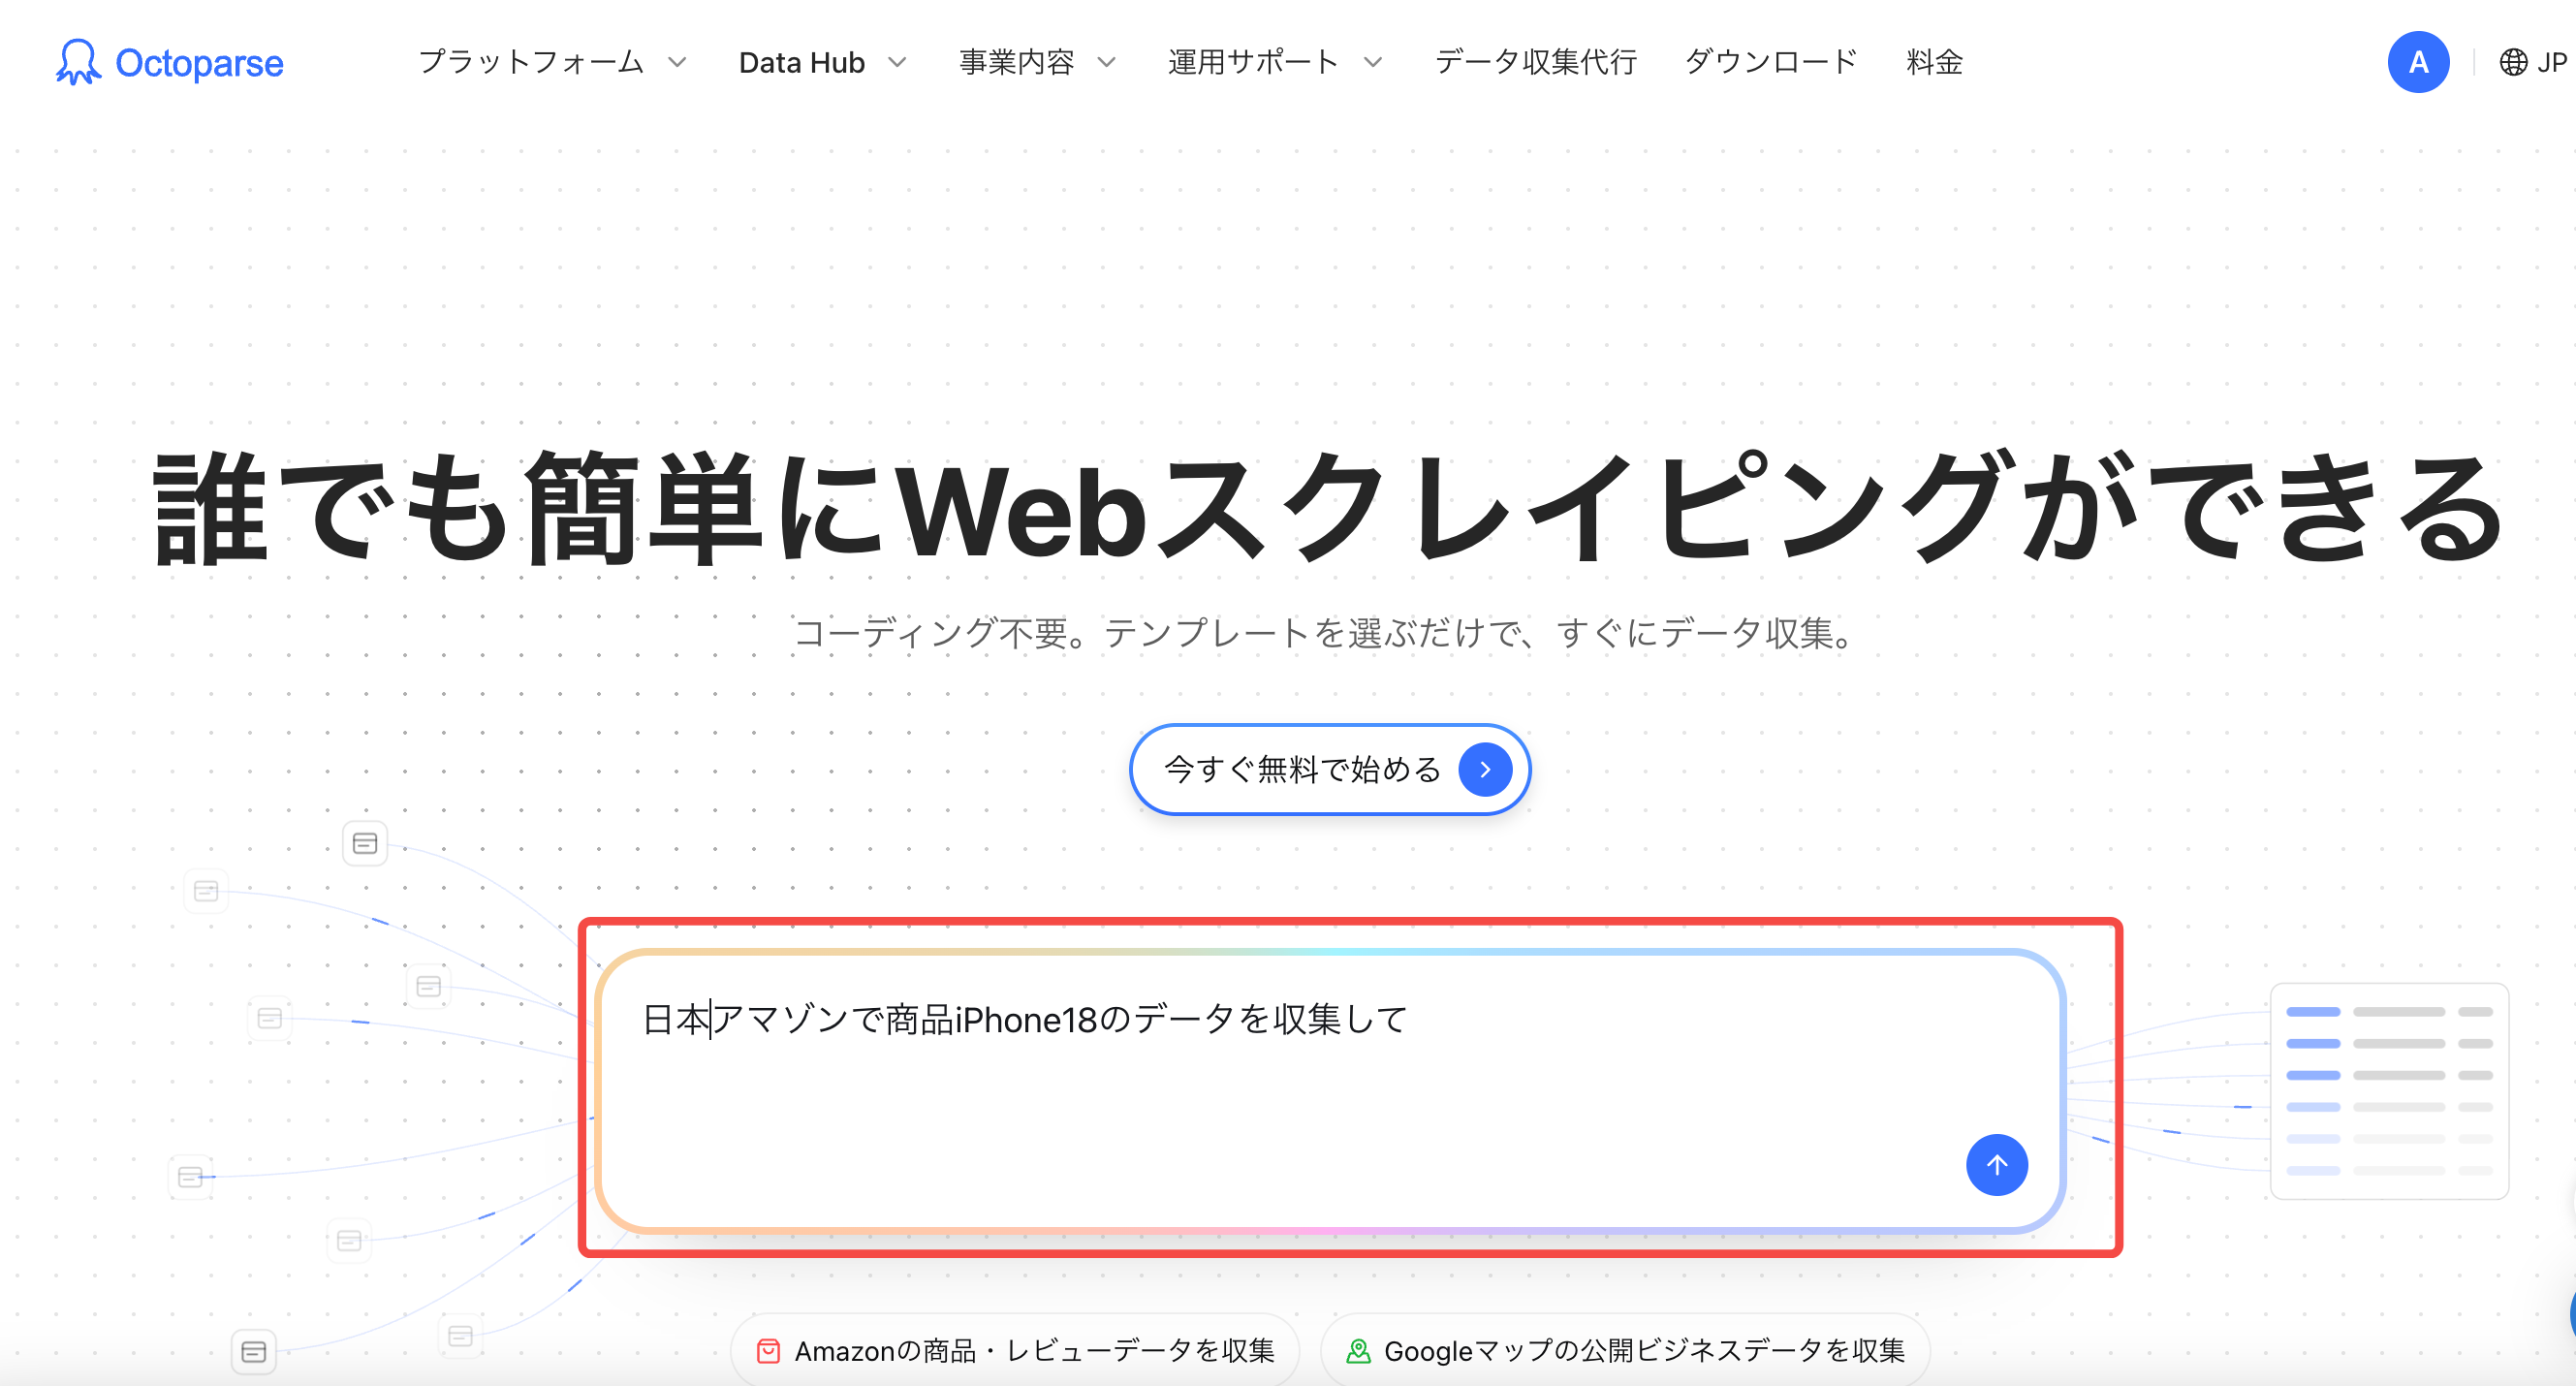
Step 1:データの収集を開始
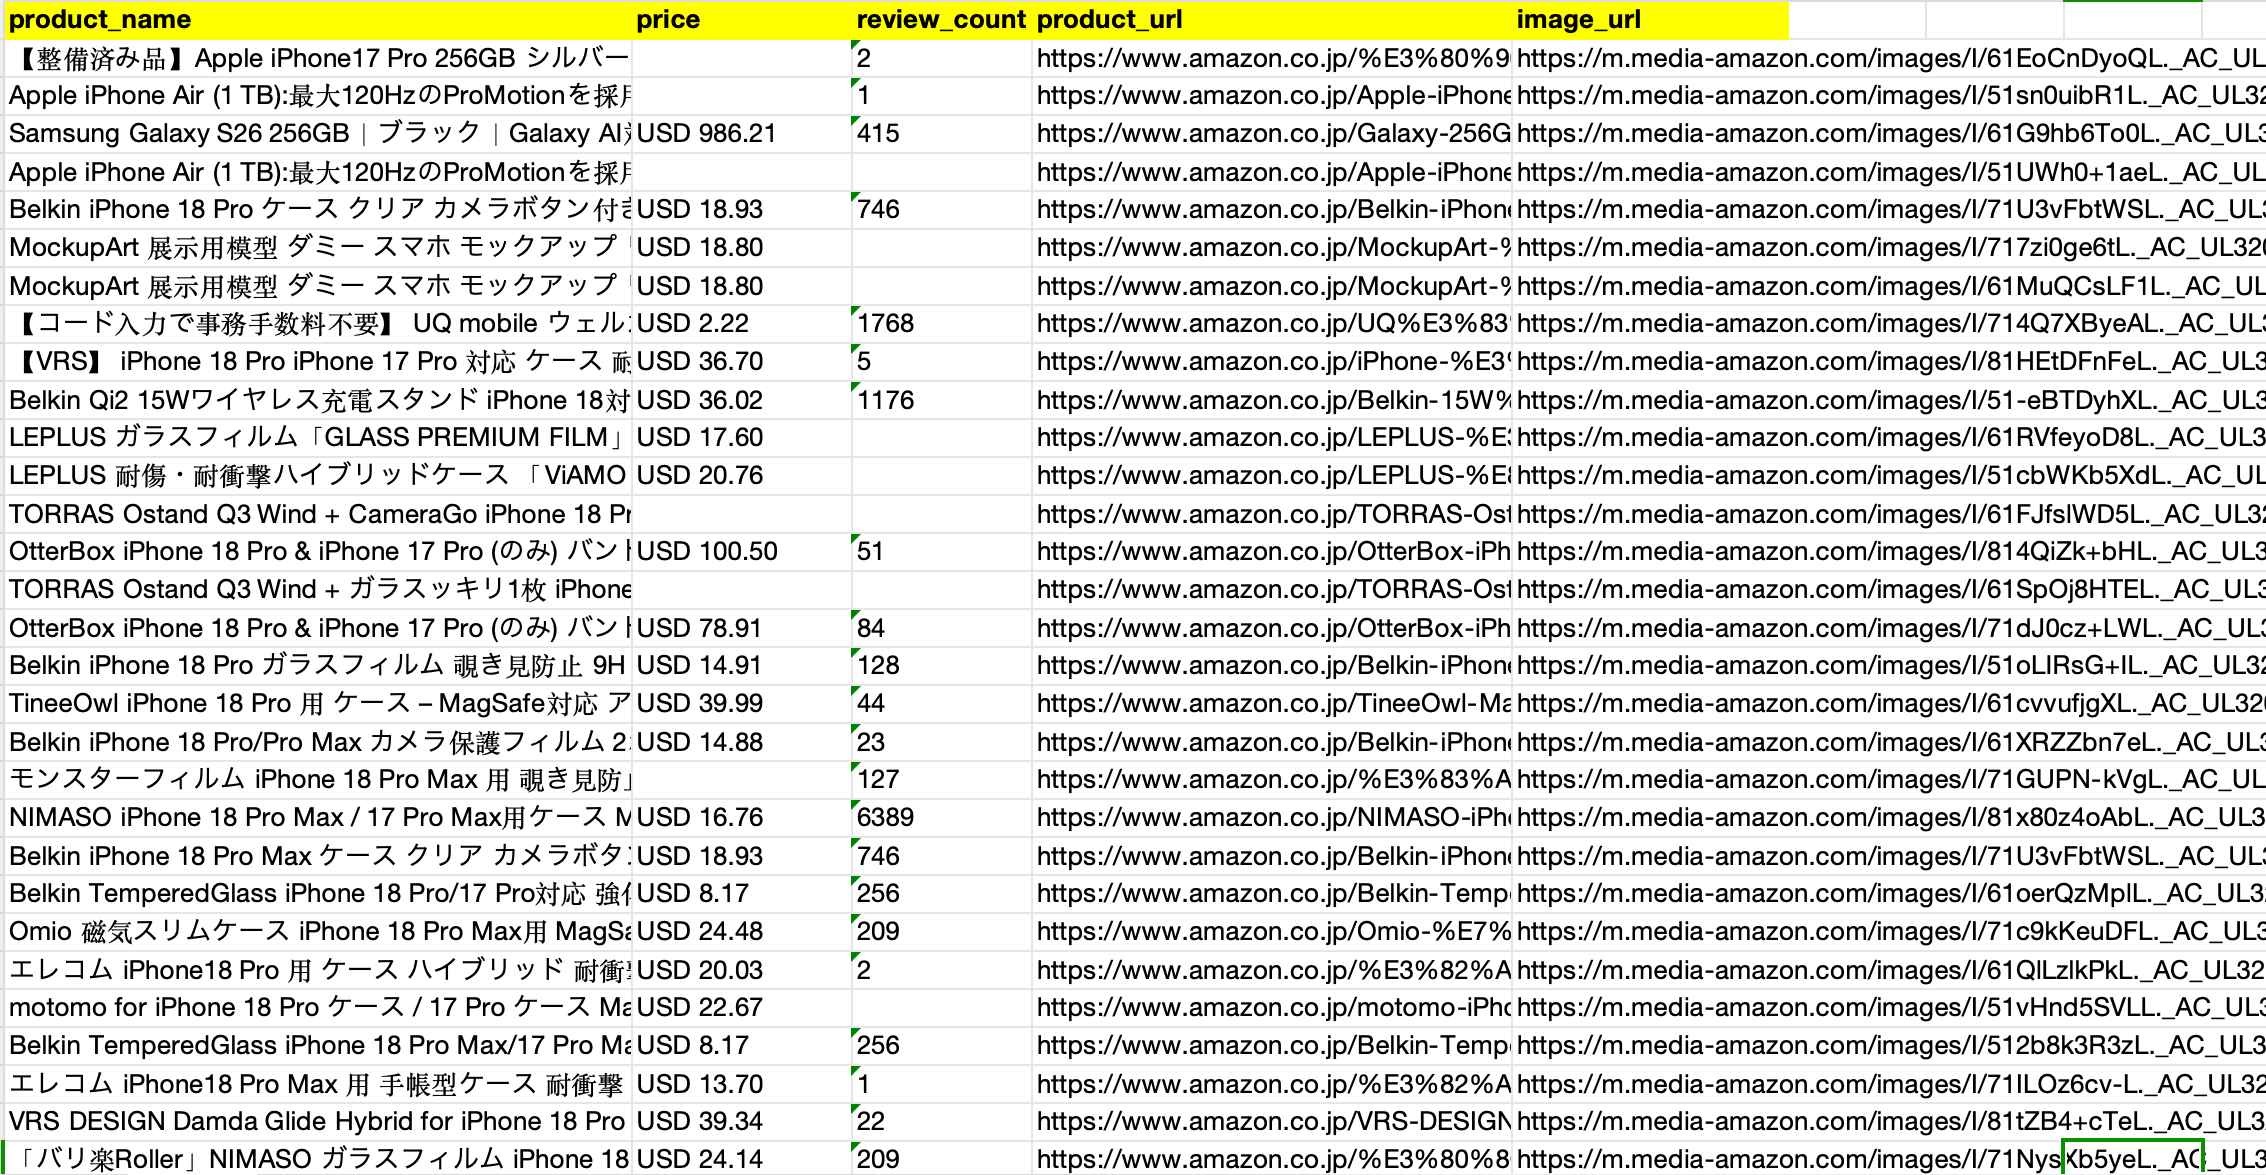
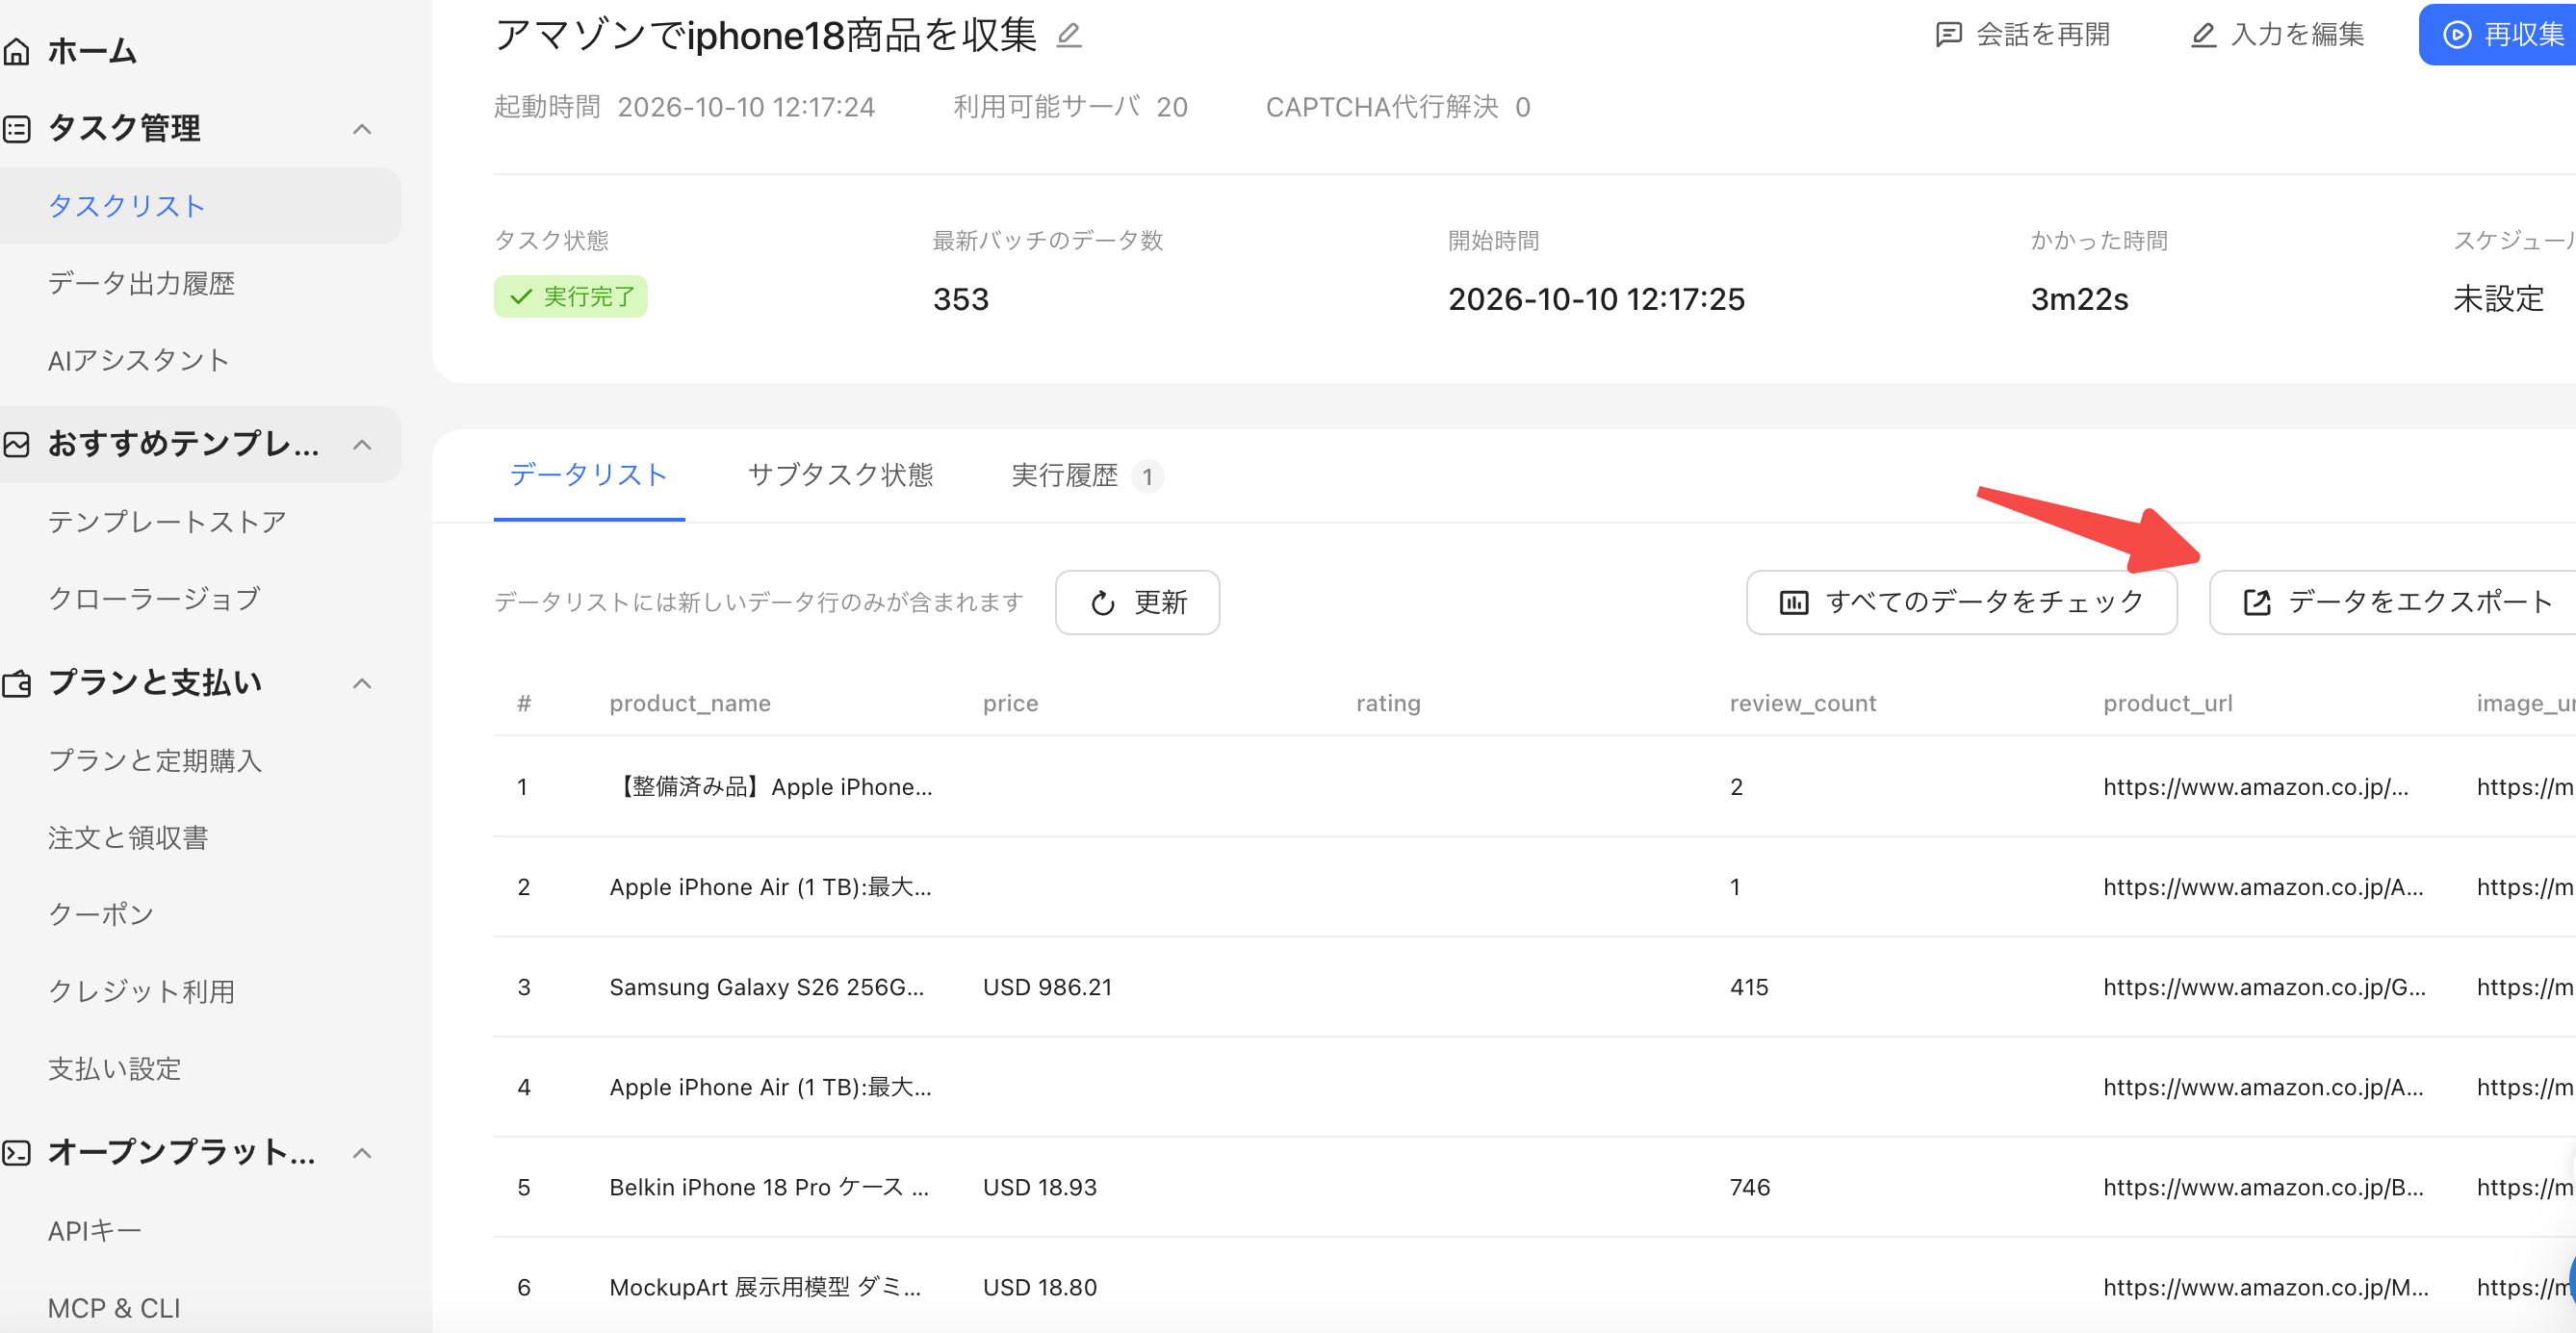
Octoparseホームページまたは自分アカウントのマイページでのAIアシスタントで自然言語だけでデータの収集を始めます。例えば、AIに「アマゾンで商品iPhone18のデータを収集して」と指示します。
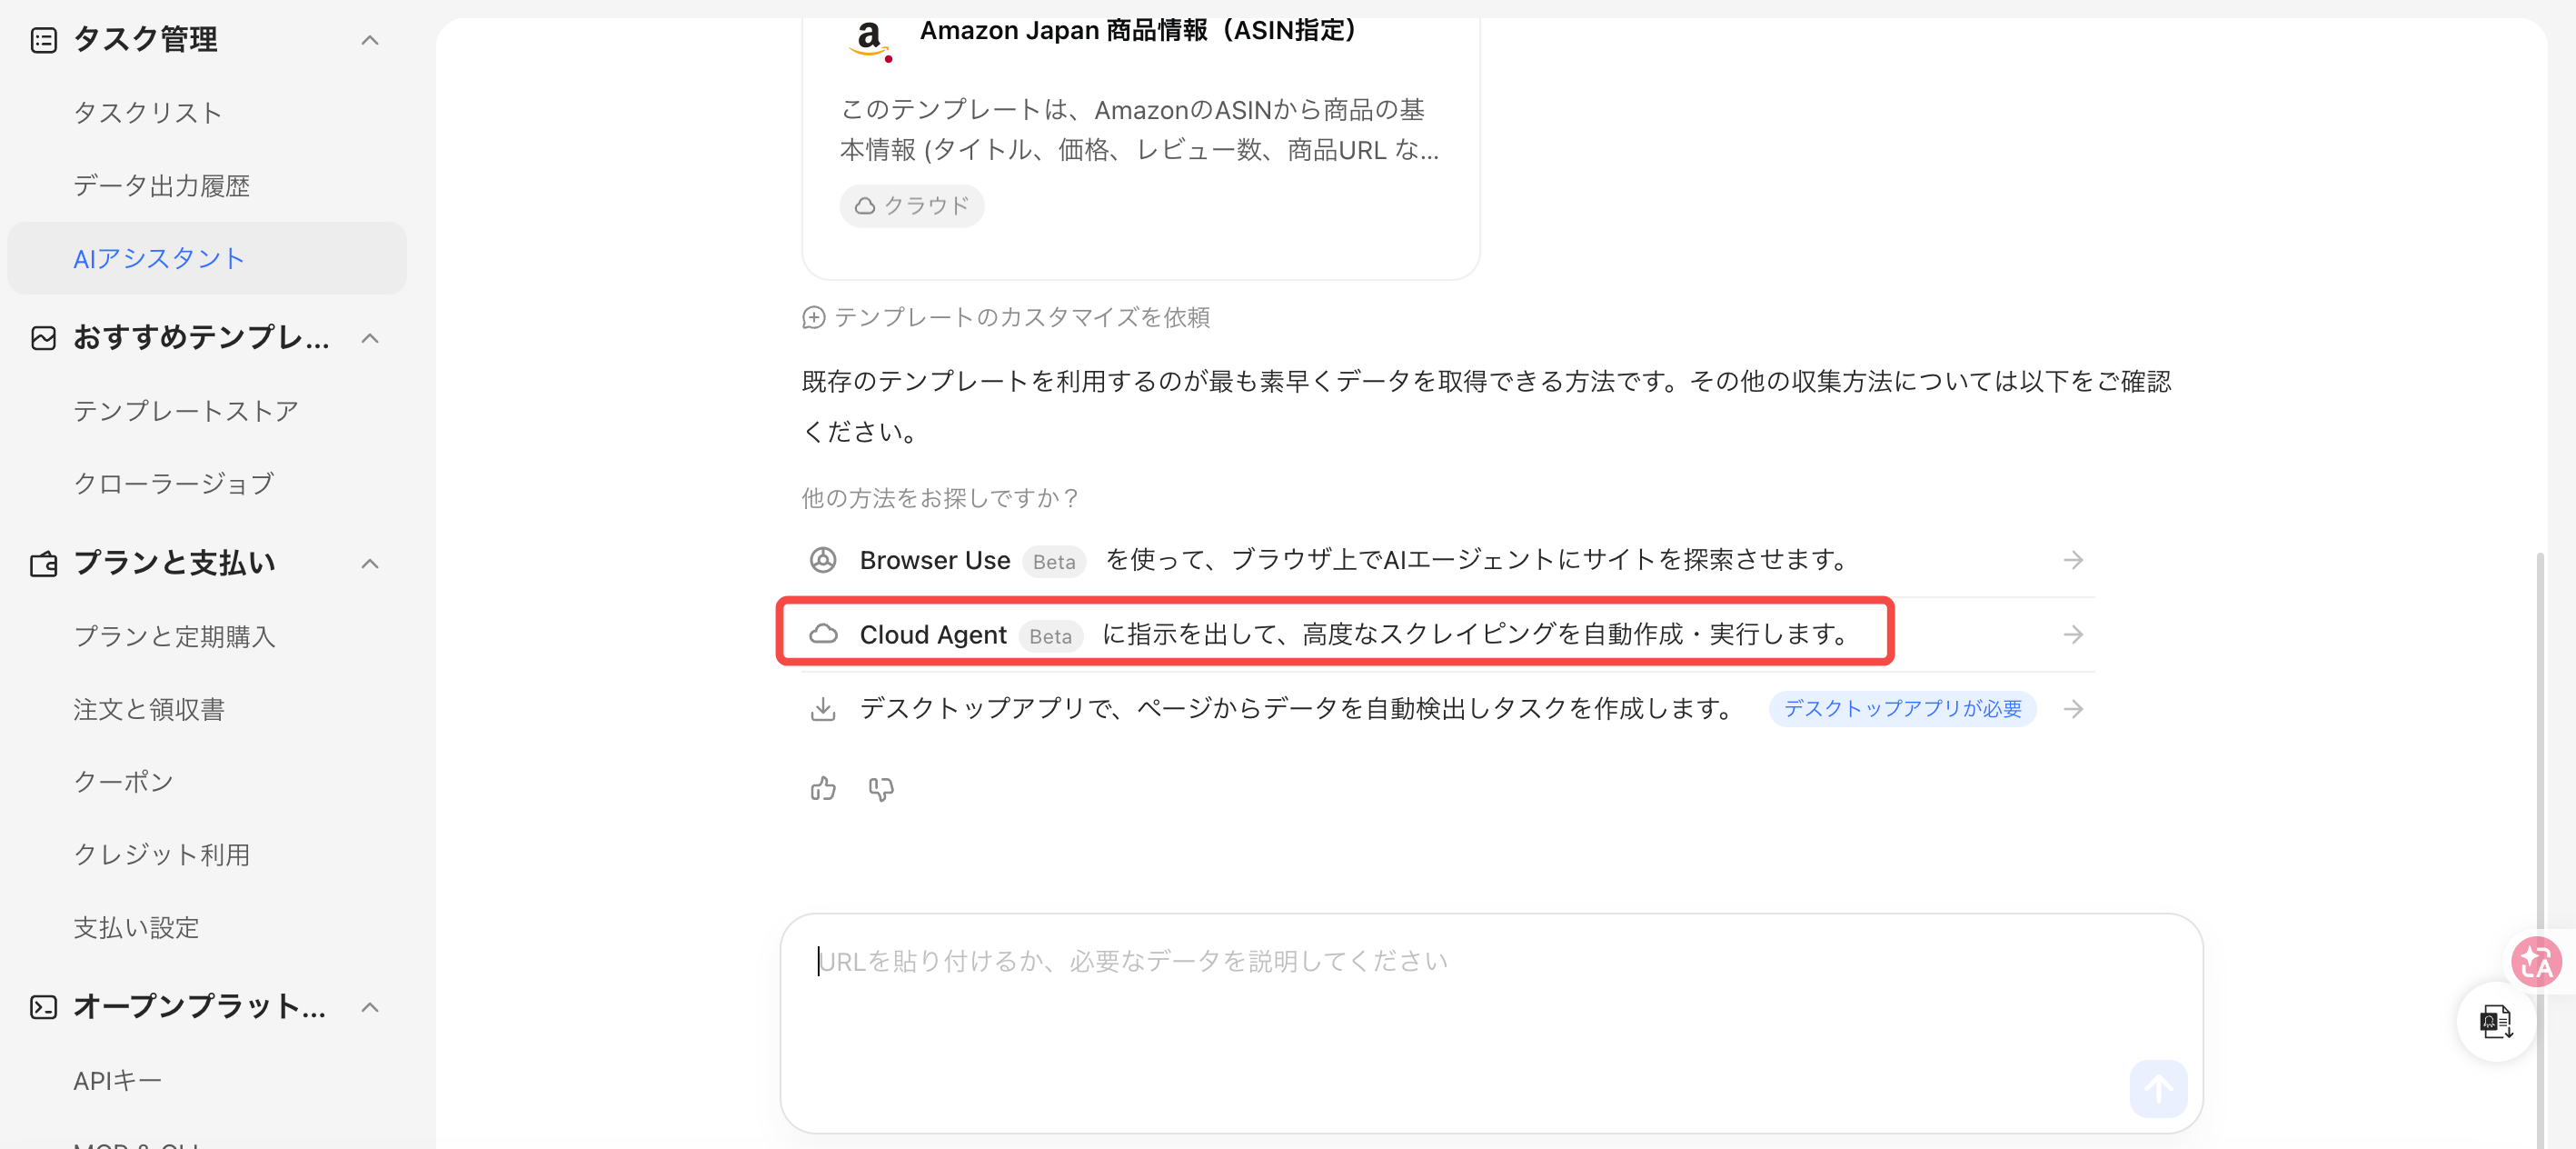
Step 1:データの収集を開始
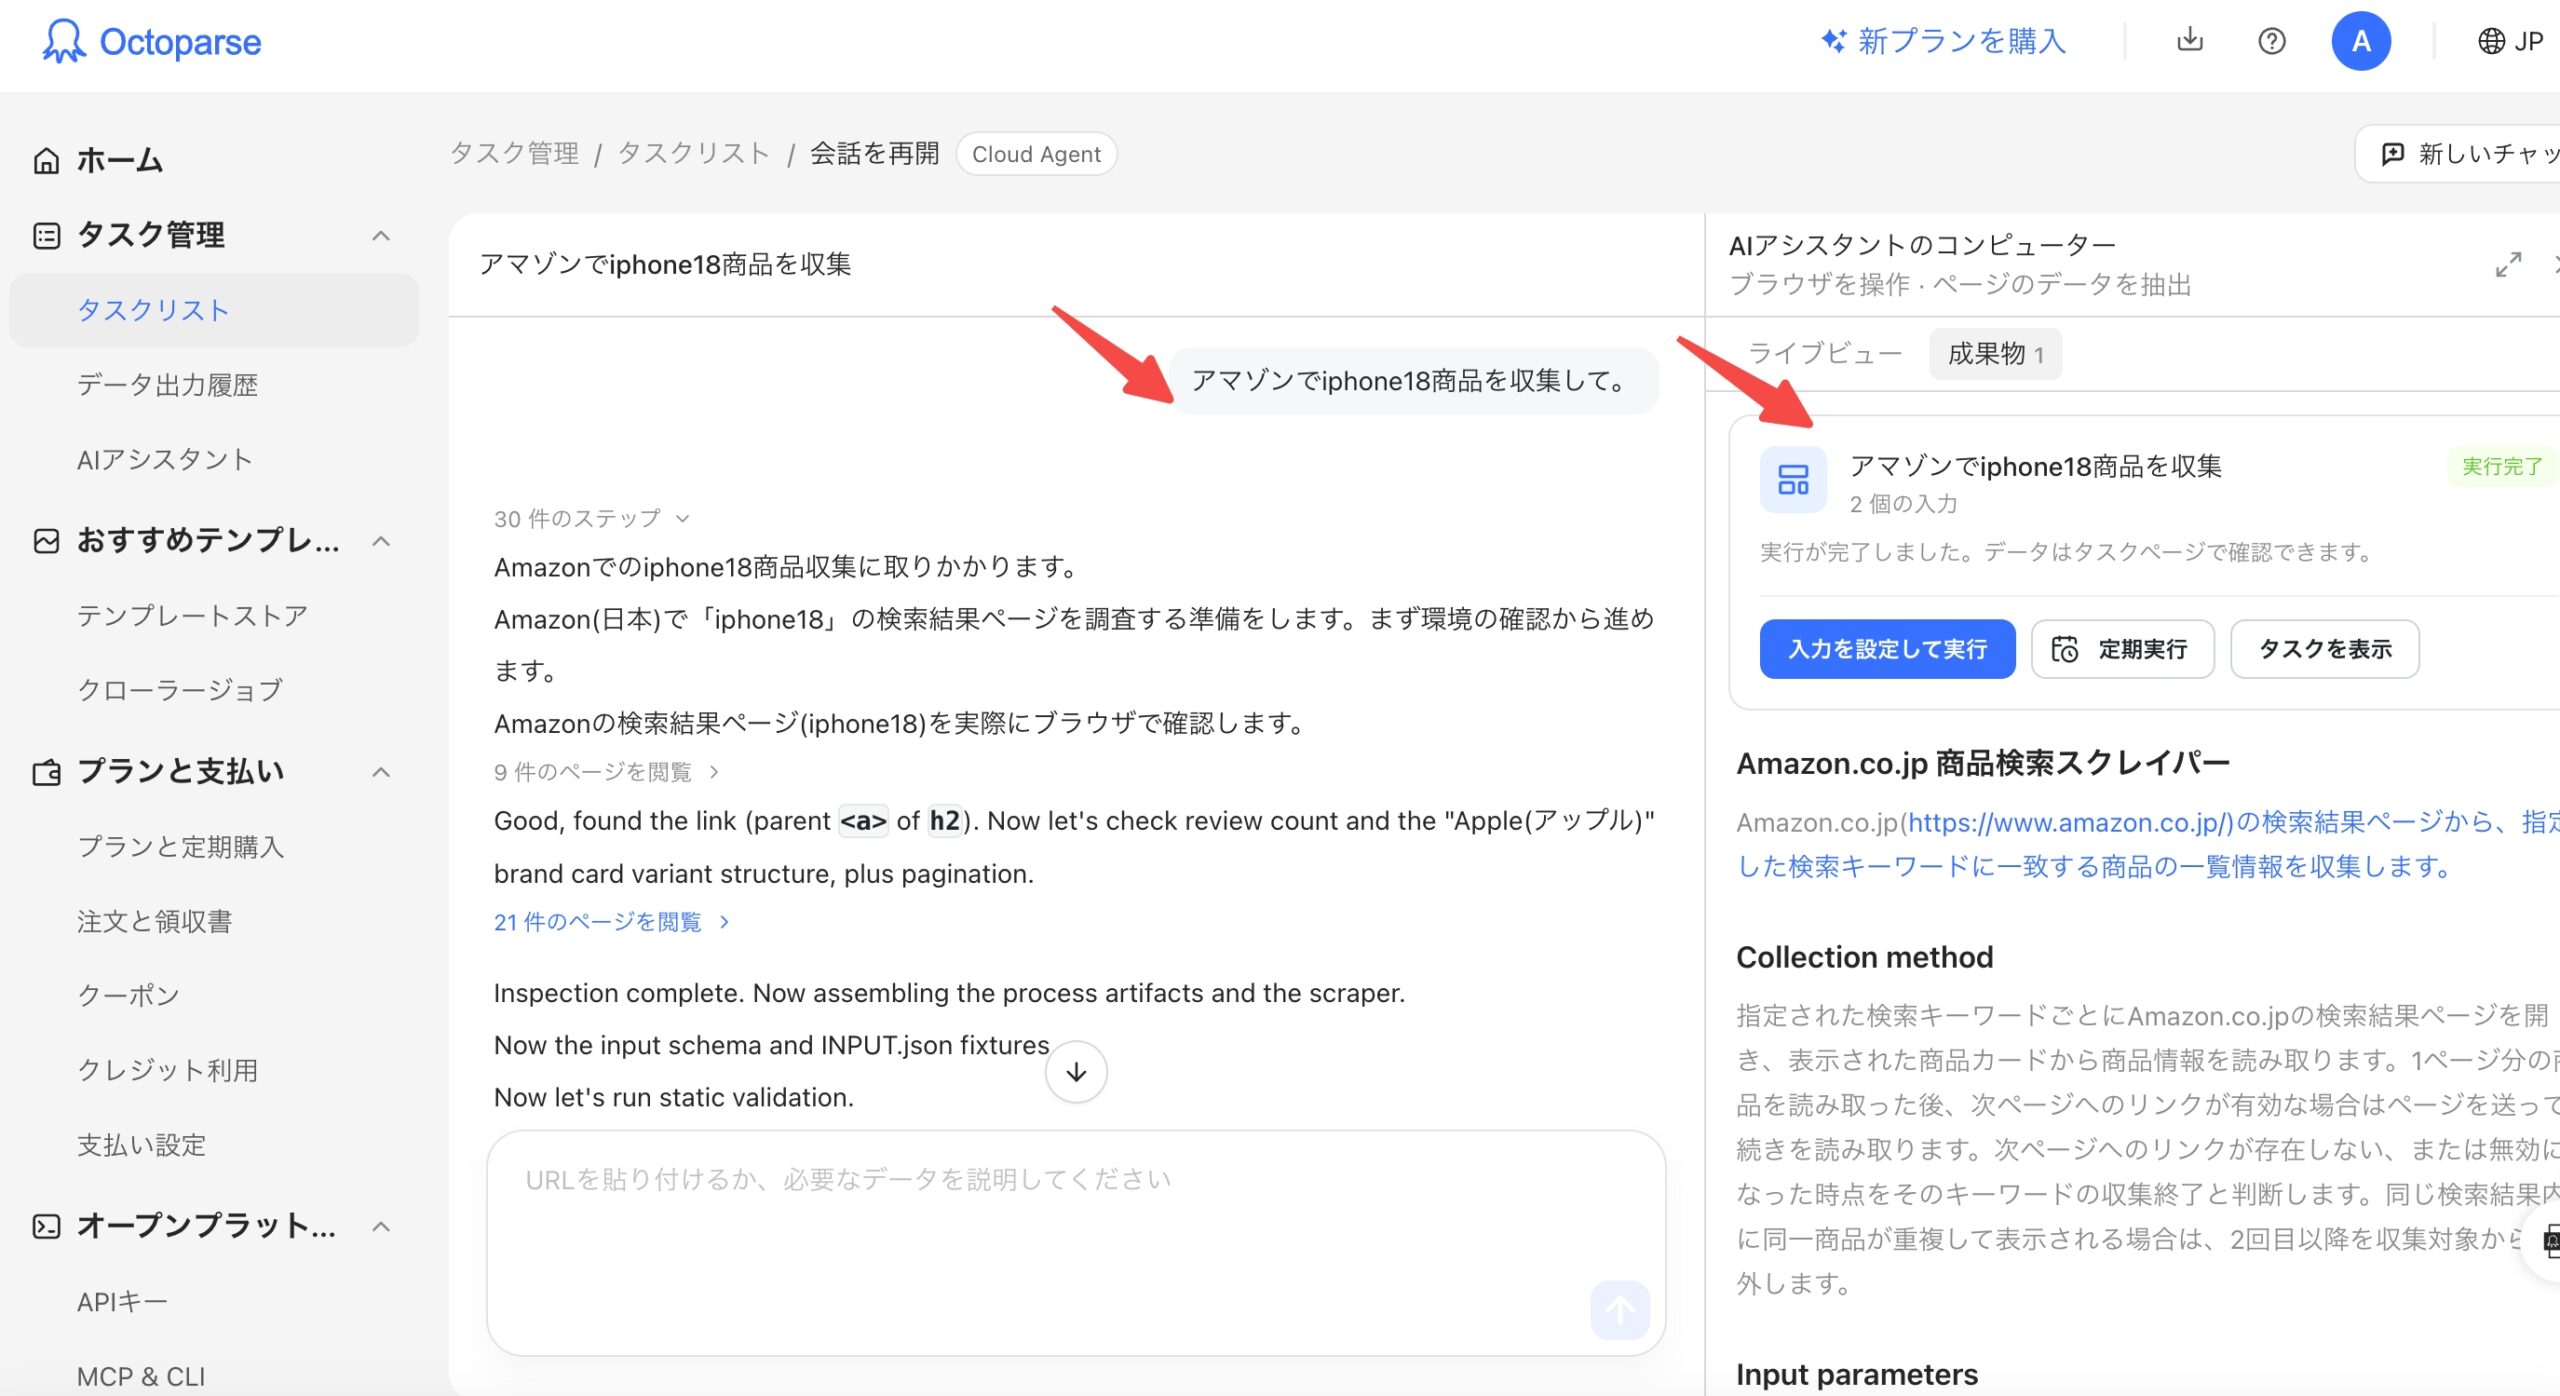
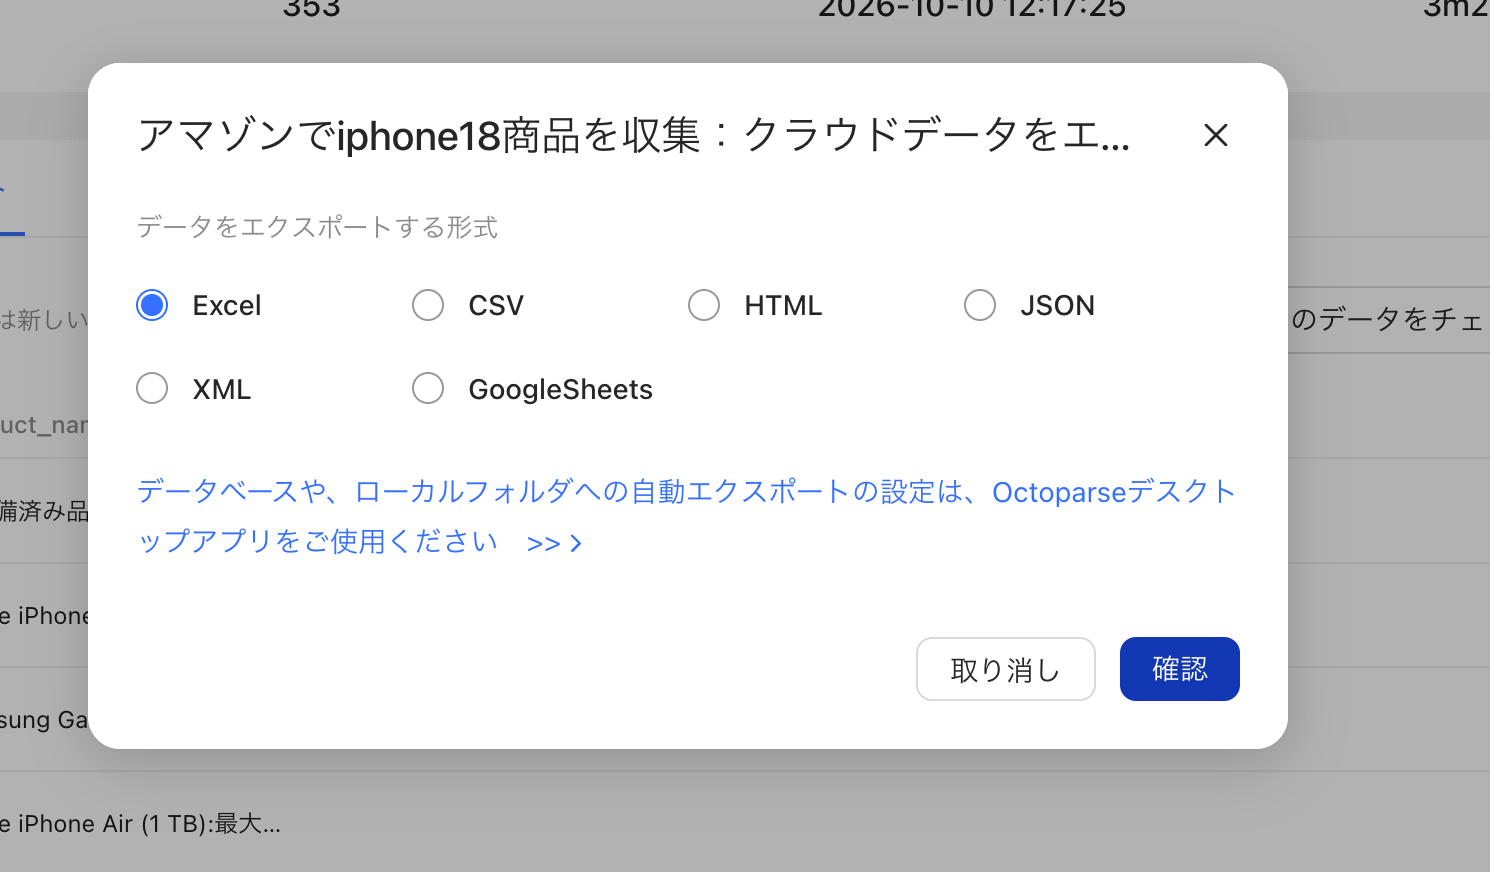
その後「Cloud Agent」モードを選んでデータの自動収集をご利用いただけます。タスクの実行が完了したら、「タスク表示」をクリックし、データの確認とエクスポートを進められます。
ScrapingBeeとOctoparseはどちらを選ぶべき?
アプリケーションへWeb取得機能を組み込みたい開発者にはScrapingBee、業務担当者が必要な項目を画面で選び、表形式のデータを継続収集したい場合にはOctoparseが向いています。両者には重なる機能がありますが、同じ成果物を同じ方法で提供する製品ではありません。
| 比較項目 | ScrapingBee | Octoparse |
|---|---|---|
| 製品の中心 | 開発者向けWebスクレイピングAPI | ノーコードのWebデータ収集ツール |
| 主な利用者 | 開発者、データエンジニア、SaaSチーム | 業務担当者、アナリスト、マーケター、開発者 |
| 入力 | URL、API Key、リクエストパラメータ | URL、画面上の操作、カスタムタスク |
| データ範囲 | 任意ページのHTML、テキスト、Markdown、スクリーンショット、抽出JSONなど | 画面上で指定した商品名、価格、会社名、所在地などの表形式データ |
| JavaScript | ヘッドレスブラウザで実行可能 | 内蔵ブラウザ上で動的ページやクリックを設定可能 |
| 継続実行 | 自社コード、スケジューラー、外部連携からAPIを呼び出す | ローカル収集、対応プランのクラウド収集とスケジュール |
| 出力・活用 | HTTPレスポンスを自社DBやアプリへ組み込む | CSV、Excel、JSON、Google Sheetsなどへ出力 |
| 費用単位 | プランのAPI Creditsと機能別消費倍率 | プラン、タスク、クラウド実行など |
| 主な制限 | Credit消費と解析・巡回・保存処理の設計が必要 | 大規模なHTTP取得基盤だけが必要な場合は過剰になることがある |
| 適した場面 | API組み込み、既存パーサー、コード中心の運用 | ノーコード設定、業務データ、直接エクスポート |
開発者・プロダクトチームにはScrapingBeeが向く
すでにURLキュー、HTML解析、データベース、監視の仕組みがあり、ページ取得部分だけを外部化したい場合はScrapingBeeが自然です。HTTPリクエストとして呼び出せるため、自社アプリの機能やバックエンド処理へ組み込みやすく、ブラウザやプロキシの運用を減らせます。
非エンジニア・業務部門にはOctoparseが向く
EC商品の価格、求人、物件、店舗、企業情報などを表にし、Excelで分析したい場合は、Octoparse(オクトパース・オクトパス)が候補です。対象ページを表示しながら必要な列を指定できるため、「HTMLを取得した後に何をすればよいか分からない」という問題を減らせます。
API型とノーコード型は最終成果物で比較する
筆者がツールを比較するときは、月額料金より先に最終成果物を確認します。自社システムへHTMLを渡すならScrapingBee、業務担当者へ毎週Excelを渡すならOctoparseというように、出口から逆算すると判断しやすくなります。料金だけで比較すると、ScrapingBee側の解析コードや保守時間、Octoparse側のタスク設計やクラウド実行条件が抜け落ちます。
ScrapingBeeとOctoparseの具体的な選び方
| 利用場面 | 判断 | 理由 |
|---|---|---|
| 自社アプリにWeb取得機能を組み込む | ScrapingBeeを先に検討 | APIとして呼び出し、既存の解析・保存処理へ渡しやすい |
| EC価格や求人をExcelで分析する | Octoparseを先に検討 | 必要な列を画面で指定し、表形式で出力できる |
| 業務担当者が取得項目を変更する | Octoparseを先に検討 | コード修正を減らし、画面上で結果を確認しやすい |
| 大量URLを既存パイプラインで処理する | ScrapingBeeなどAPI型を比較 | キュー、解析、DBが既にある場合は取得層だけを置き換えやすい |
| AIへWeb文章を渡す | 出力形式で比較 | ScrapingBeeのMarkdown/APIとOctoparseの構造化業務データでは用途が異なる |
AIからWebデータ収集を動かしたい場合、ScrapingBeeにはMCP Serverがあり、OctoparseにもOctoparse MCPがあります。ただし、AI連携という名称だけで選ばず、必要なのがWebページ本文なのか、価格や企業名などの構造化された業務データなのかを先に決めてください。Octoparse MCPの基本は公式のMCP利用ガイドで確認できます。
Webスクレイピングを安全に行うには?
ScrapingBeeやOctoparseで技術的に取得できることと、そのデータを取得・保存・利用してよいことは同じではありません。実行前に公式API、CSV、RSSなどの提供手段がないか確認し、利用規約、robots.txt、著作権、個人情報、アクセス負荷、取得後の利用目的をまとめて確認します。Webスクレイピングの基本的な仕組みは、Webデータを自動収集する仕組みの解説も参考になります。
利用規約と公式の取得方法を確認する
対象サイトの規約、開発者ページ、API、データダウンロード、問い合わせ窓口を確認します。公式手段で同じ目的を達成できる場合は、その仕様と条件に従う方が安定します。ログイン後、有料コンテンツ、アクセス制御のある領域は、明確な権限なしに自動取得しないでください。
著作権・個人情報・保存目的を確認する
商品価格のような事実情報と、説明文、画像、レビュー、データベースの構成は同じ扱いではありません。氏名、連絡先、位置情報などを含む場合は、取得だけでなく保存期間、共有範囲、営業利用、削除方法まで検討します。判断が難しい商用案件は法務または専門家へ相談してください。
アクセス頻度と失敗時の動作を制御する
必要以上の並列実行や短時間の再試行を避け、少量テストから始めます。403、429、CAPTCHAなどが増えた場合は、設定を強くする前に処理を止め、規約、権限、アクセス頻度を見直してください。技術的な回避手段があることは、利用許可を意味しません。
ScrapingBeeについてよくある質問
質問1:ScrapingBeeとは何ですか?
ScrapingBeeとは、対象URLをAPIへ送り、JavaScriptの実行、プロキシ管理、ページ取得などをクラウド側で処理するWebスクレイピングAPIです。HTML、JSON、Markdown、スクリーンショットなどを自社アプリやデータ処理へ組み込みたい開発者に向いています。
質問2:ScrapingBeeは無料で使えますか?
2026年10月10日の公式ページでは、クレジットカード不要で1,000 API Creditsを試せると案内されています。1 Creditが必ず1ページになるわけではなく、JavaScript、Proxy、AI機能によって消費量が増えます。
質問3:ScrapingBeeを使うにはPythonが必要ですか?
Pythonだけに限定されません。cURL、Node.jsなどからも利用でき、n8n、Make、Zapier、MCPなどの連携もあります。ただし、API Key、Credits、出力確認、エラー処理の基礎知識は必要です。
質問4:ScrapingBeeからExcelへ直接出力できますか?
ScrapingBeeは主にAPIレスポンスを返すサービスです。取得結果をExcelへ保存する処理は、自社コードや連携ツールで組み立てるのが基本です。画面上で項目を選び、ExcelやCSVへ直接出力したい場合はOctoparseの方が適することがあります。
質問5:ScrapingBeeとOctoparseはどちらが初心者向けですか?
プログラミング経験が少なく、Webページから必要な列を選んで表を作りたい場合はOctoparseが始めやすいでしょう。APIを使ったことがあり、自社アプリやデータパイプラインへ組み込む場合はScrapingBeeの方が目的に合います。
質問6:ScrapingBeeを使ったWebスクレイピングは違法ですか?
ScrapingBeeやWebスクレイピングという技術自体を一律に違法とはいえませんが、対象、取得方法、利用規約、アクセス負荷、著作権、個人情報、取得後の利用方法によって問題になる可能性があります。対象サイトごとに条件を確認してください。
まとめ
この記事では、ScrapingBeeの使い方、料金、代替ツールについて詳しく紹介しました。ScrapingBeeとは、Webページ取得に必要なブラウザとプロキシの運用をAPIへまとめ、自社コードから利用できるサービスです。JavaScriptページ、複数の出力形式、AI抽出、外部連携に対応し、開発者が既存アプリやデータ基盤へ組み込む用途に適しています。一方、Credit消費は設定によって大きく変わり、解析、巡回、保存、データ検証を自社で設計する場面があります。
Octoparse(オクトパース・オクトパス)は、HTML取得APIの完全な置き換えではありません。コードを書かずに必要項目を選び、一覧、詳細、ページ送りを設定し、ExcelやCSVまで取得したい業務に向く別タイプの選択肢です。ScrapingBeeとOctoparseを比較するときは、月額だけでなく、誰が保守するか、何を出力するか、正しいデータ1,000件を得るまでにどの程度の作業が必要かを基準にしてください。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール