APIがないWebサイトからデータを取得するには、公式のCSV・RSS・ダウンロード機能を先に確認し、利用できない場合に手作業、Webスクレイピングツール、またはPythonなどの自作プログラムを選びます。少量なら手作業、プログラミングなしで繰り返し収集するならOctoparse、複雑な制御やシステム連携が必要なら自作開発が候補です。ただし、画面に表示されているデータでも、利用規約・著作権・個人情報・アクセス負荷を確認せずに取得してよいとは限りません。
この記事では、APIが提供されていないWebサイトからデータを取得する方法を4つに整理し、目的に合う方法の選び方を解説します。ぜひ最後までご覧ください。
| 状況 | 最初に検討する方法 | 向いている用途 |
|---|---|---|
| 公式API・CSV・RSSがある | 公式の取得手段 | 安定したデータ連携、継続運用 |
| 数件だけ一度取得したい | コピー&ペースト、ブラウザの保存機能 | 単発調査、少量の確認 |
| 同じ構造のページを繰り返し取得したい | Octoparseなどのノーコードツール | 価格調査、求人・物件・店舗情報の整理 |
| 独自ロジックや高度な連携が必要 | Python、Scrapy、Playwrightなど | 開発チームによる専用システム |
| 可用性保証や利用許諾が重要 | データ提供会社、正式な提携、委託開発 | 重要業務、大規模・長期運用 |
APIがないWebサイトからデータを取得する方法は?
APIがない場合でも、手作業、ノーコードのWebスクレイピングツール、自作プログラム、データ提供サービスという4つの方法があります。データ量、更新頻度、ページ構造、技術力、利用条件を基準に選ぶことが重要です。
方法1:手作業またはブラウザ機能で取得する
数件の情報を一度だけ確認するなら、コピー&ペースト、印刷、PDF保存、表計算ソフトへの貼り付けで十分な場合があります。自動化の設定時間が不要で、取得対象を目視できる点がメリットです。一方、件数が増えると入力ミスや重複が発生しやすく、更新作業にも時間がかかります。
方法2:ノーコードのWebスクレイピングツールを使う
商品一覧、求人一覧、物件一覧のように同じ構造が繰り返されるページでは、ノーコードのWebスクレイピングツールが候補になります。画面上で必要な項目を選び、ページ送りや詳細ページへの移動を設定し、ExcelやCSVに出力できます。プログラムを一から作るより着手しやすい一方、サイトの構造が変わった場合は設定の確認や修正が必要です。
方法3:Pythonやブラウザ自動化で取得する
静的HTMLから必要な項目を取得する場合はRequestsとBeautiful Soup、大量のURLを継続的に巡回する場合はScrapy、JavaScriptで表示されるページやクリック操作が必要な場合はPlaywrightやSeleniumが候補です。独自の処理や社内システムとの連携には向きますが、実装、エラー処理、監視、サイト変更への保守を担当できる人が必要です。
方法4:データ提供会社や取得代行を利用する
重要業務で可用性、正式な利用許諾、サポート、品質保証が必要なら、データ提供会社、対象サイトとの提携、または取得代行サービスを検討します。料金はかかりますが、社内でクローラーを維持する負担やデータ利用条件の不確実性を下げられる場合があります。
どの方法を選ぶ?データ取得前の判断基準
「APIが見つからない」という理由だけで、すぐにスクレイピングを始めるべきではありません。公式API、CSV、RSS、オープンデータ、データ販売ページがないか確認し、その後にデータ量と更新頻度を基準として方法を選びます。
| 確認項目 | 判断 | 推奨される対応 |
|---|---|---|
| 公式APIや一括ダウンロードがある | 公式手段を優先 | 仕様、料金、保存条件を確認して利用する |
| 必要なのは数件だけ | 自動化の効果が小さい | 手作業またはブラウザ機能を使う |
| 一覧と詳細ページが同じ構造 | 定型処理にしやすい | ノーコードツールまたはクローラーを検討する |
| JavaScriptで後から表示される | 単純なHTTP取得では不足する場合がある | ブラウザ型ツール、Playwright、Seleniumを検討する |
| ログイン・CAPTCHAがある | 権限と技術の両面で注意が必要 | 許可された公式手段または運営者への相談を優先する |
| 個人情報や有料コンテンツを含む | 高リスク | 取得・保存・利用の適法性を専門家と確認する |
| 毎日・毎週更新したい | 継続運用が必要 | スケジュール、監視、再実行、重複管理を設計する |
Webスクレイピングとは?APIがない場合に使える理由
Webスクレイピングとは、WebページのHTMLやブラウザ上に表示された内容から、必要な情報を抽出して表形式などへ整える技術です。APIがデータ提供用の決められた窓口であるのに対し、スクレイピングは人が閲覧するWebページを取得対象にします。基本的な仕組みやクローリングとの違いは、Webデータを自動収集する仕組みの解説で詳しく確認できます。
APIとWebスクレイピングの違い
APIはJSONなどの機械処理しやすい形式でデータを返し、認証、利用量、取得項目が仕様として示されることがあります。Webスクレイピングは、APIが提供されていない項目にも対応できる可能性がありますが、ページ構造の変更に影響されやすく、取得可否と利用条件を利用者自身で確認する必要があります。詳しい比較は、APIとWebスクレイピングを選ぶ基準を参照してください。
静的ページと動的ページでは取得方法が異なる
最初のHTMLに商品名や価格が含まれる静的ページは、HTTPリクエストとHTML解析で取得できる場合があります。スクロールやクリック後にJavaScriptでデータが表示される動的ページは、ブラウザを実際に動かす仕組み、読み込み待機、ページ送り、クリック操作などが必要です。
表示されているデータでも自由に取得・利用できるとは限らない
技術的に取得できることと、規約上・法律上・契約上利用できることは別です。公開ページであっても、利用規約で自動取得が制限されている場合、著作物や個人情報を含む場合、アクセスによってサーバーへ過度な負荷を与える場合があります。取得前だけでなく、保存期間、共有先、営業利用、再配布の条件も確認してください。
APIがないサイトのデータ取得にOctoparseをおすすめする理由
APIが公開されていないWebサイトからデータを取得する場合、課題となるのは「データを取得できるか」だけではありません。取得ツールの設定に時間がかかる、途中で収集が止まる、運用コストが読みにくいといった問題もあります。
こうした課題を解決する選択肢としておすすめなのが、ノーコードのWebスクレイピングツール「Octoparse」です。公式APIがなくてもWebページから必要な情報を抽出でき、600種類以上の既成テンプレートを使えば、対応サイトではURLまたはキーワードを入力するだけでデータ収集を始められます。 ゼロから収集ルールを構築する手間が少なく、初心者でも商品情報や企業リストなどを効率よく取得できます。
また、単にデータを取得するだけでなく、クラウド実行や定期収集、IPローテーションなどを活用して、継続的なデータ収集を安定して運用しやすい点も強みです。料金面では、無料プランで実際の取得結果を試してから、必要に応じて有料プランへ移行できます。月額プランを基準に予算を立てやすく、データ収集を始めるために高額な開発費をかける必要もありません。
「APIがないから諦める」のではなく、「まず無料で試し、必要なデータを無理なく継続収集する」。 Octoparseは、データ収集の準備や管理に費やす時間を減らし、分析や営業、マーケティングといった本来の業務に集中したい方に適したツールです。
クラウド収集とスケジュールで更新作業を自動化できる
対応する有料プランでは、クラウド上でタスクを実行し、日次・週次・月次などのスケジュールを設定できます。PCを起動し続けずに定期収集できる点は、価格や求人など更新されるデータの監視に適しています。無料プランはローカル実行が中心となるため、検証と継続運用を分けて考えてください。
関連記事:
Octoparseの使い方【2026年版】初心者がゼロから5分でデータ収集できる完全ガイド
Octoparseはどのような人・用途に向いている?
Octoparseは、プログラミングを使わず、繰り返し構造を持つ公開Webページから必要な項目を表形式で取得したい人に向いています。特に、手作業のコピー&ペーストが定期業務になっている場合は、小規模なテストで削減できる作業量を確認する価値があります。
| データ源 | 代表的なフィールド | 意思決定への利用例 | 主な制限 |
|---|---|---|---|
| ECサイト | 商品名、価格、在庫、評価、URL | 価格調査、品揃え比較 | サイト規約、価格の取得時刻、商品対応付け |
| 求人サイト | 職種、企業名、勤務地、給与、掲載日 | 採用市場と競合求人の分析 | 重複求人、掲載終了、利用規約 |
| 不動産サイト | 物件名、価格、面積、所在地、URL | 地域別相場と供給状況の確認 | 同一物件の重複、更新頻度 |
| 店舗・企業ページ | 名称、所在地、カテゴリ、Webサイト | 市場調査、候補リスト作成 | 個人情報、営業利用、情報の正確性 |
Octoparseを選ばない方がよいケース
公式APIや正式なデータ販売があり、それで必要な項目を取得できる場合は公式手段を優先します。取得件数が少ない単発作業、ミリ秒単位のリアルタイム処理、厳格なSLAが必要な基幹業務、高度な独自ロジックを持つシステムにも、手作業、API、データ提供会社、または自作開発の方が適する場合があります。
Octoparseの使い方は?
Octoparseでは、テンプレート、カスタムタスク、MCPによるデータ収集方法などがあります。ここでは、Google Maps向けのテンプレートを使って、その操作方法を詳しく紹介します。
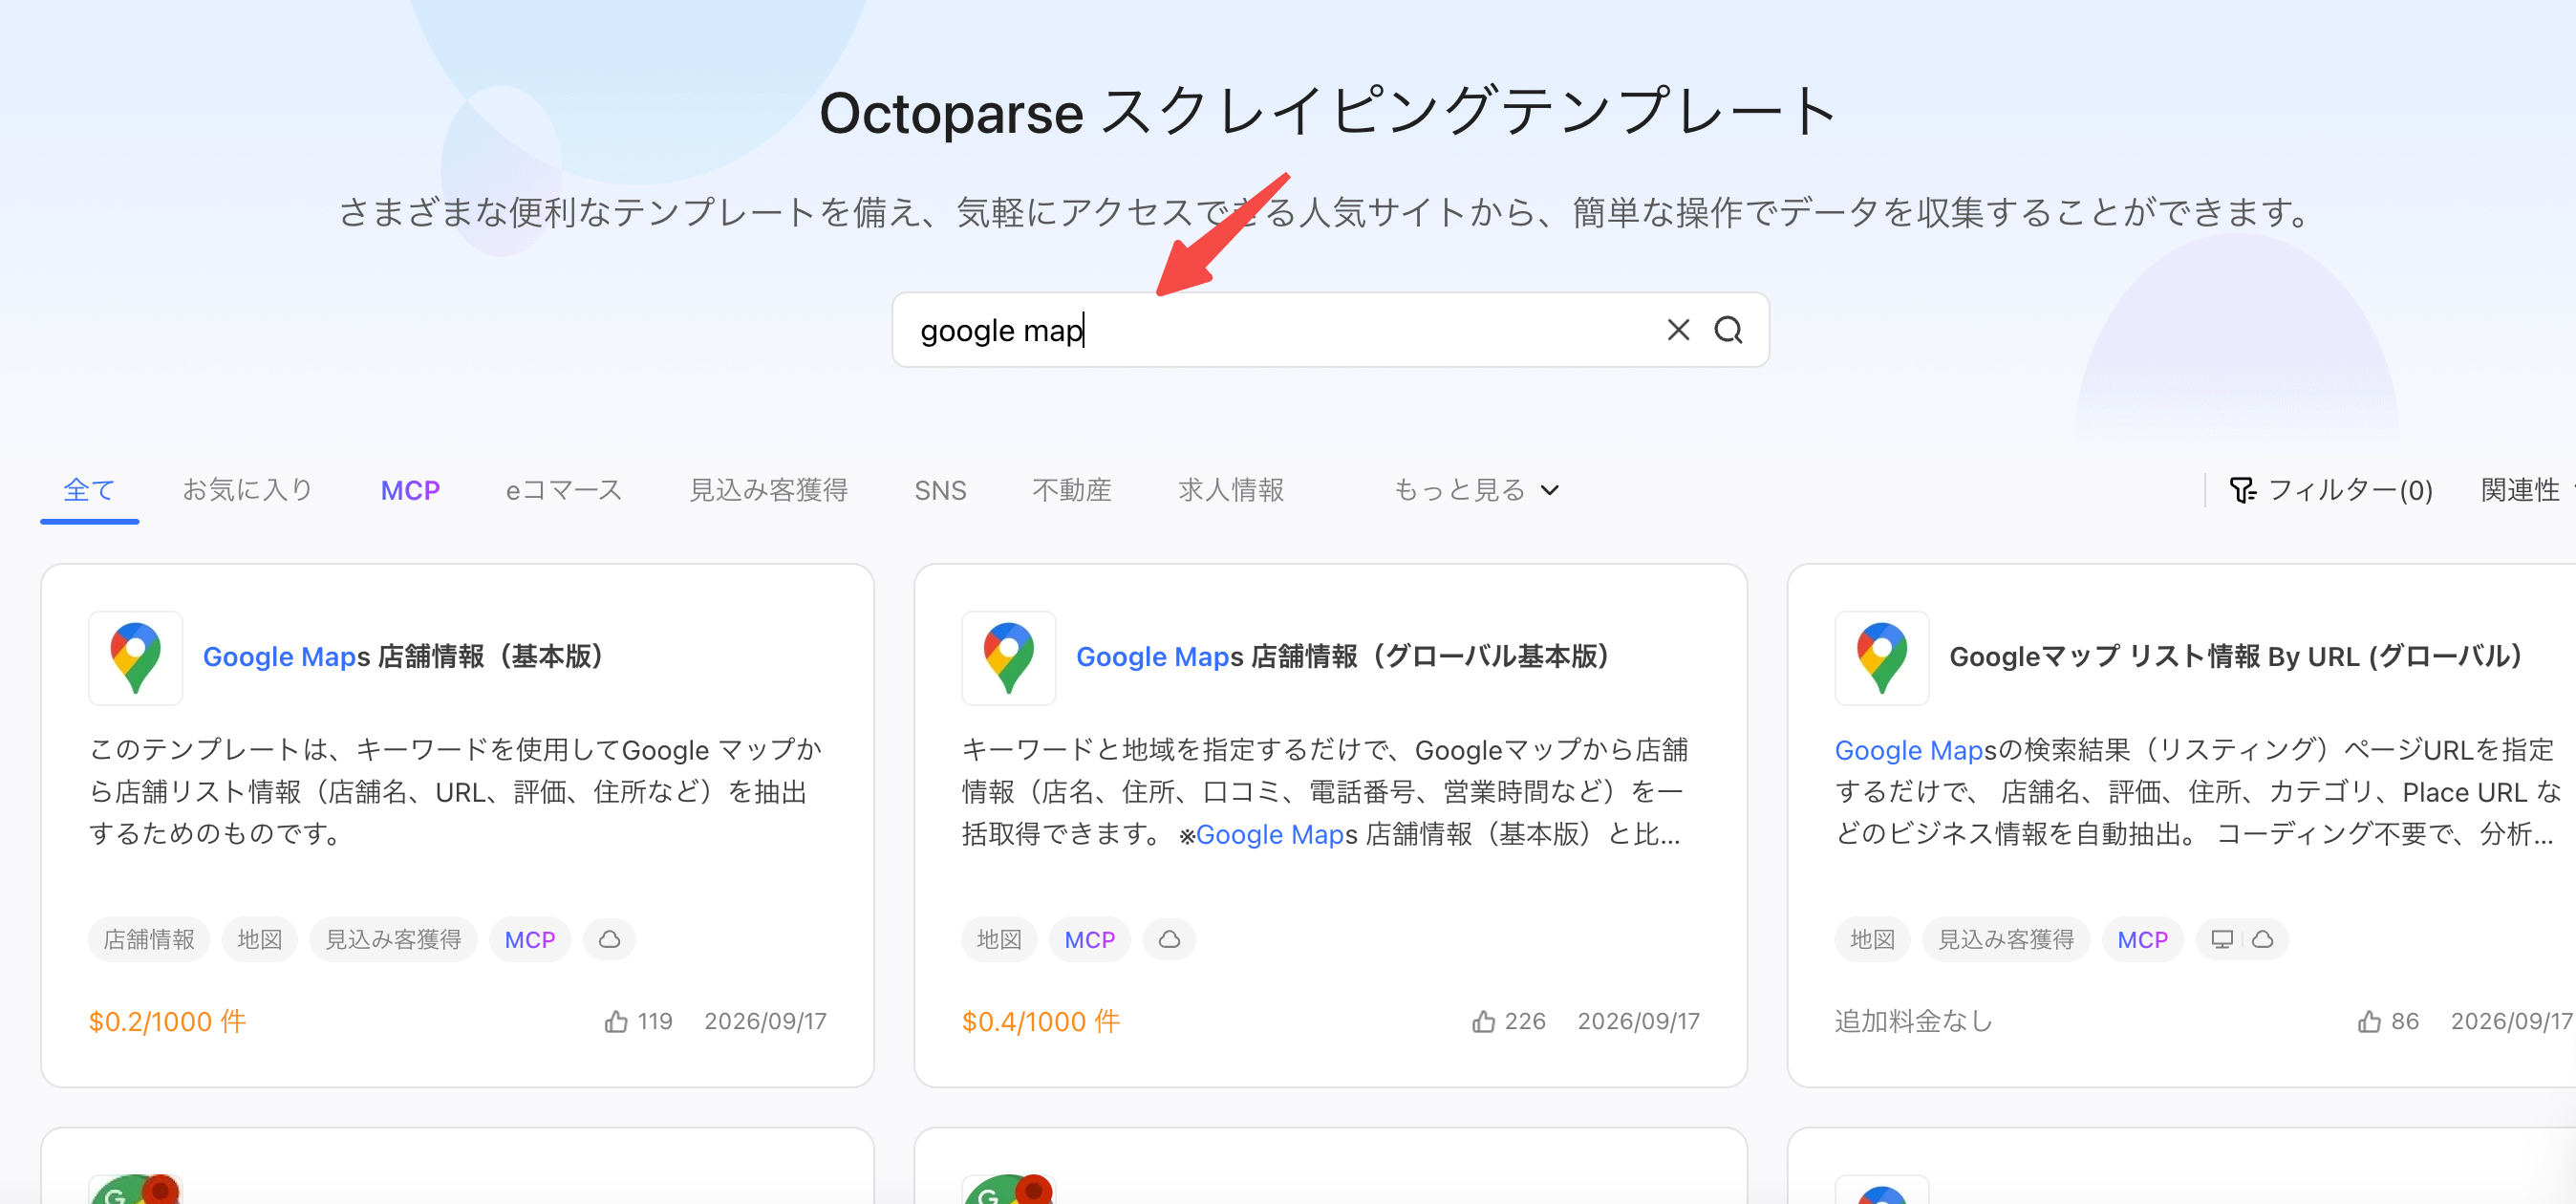
Step 1:Google Maps用テンプレートを選択する
Octoparseへログインし、ホーム画面またはテンプレートギャラリーで「Google Maps」を検索します。店舗一覧、レビュー、連絡先など目的によってテンプレートが異なるため、必要なフィールドと実行条件を確認して選択します。この例では、Google Maps 店舗情報(基本版)を候補とします。
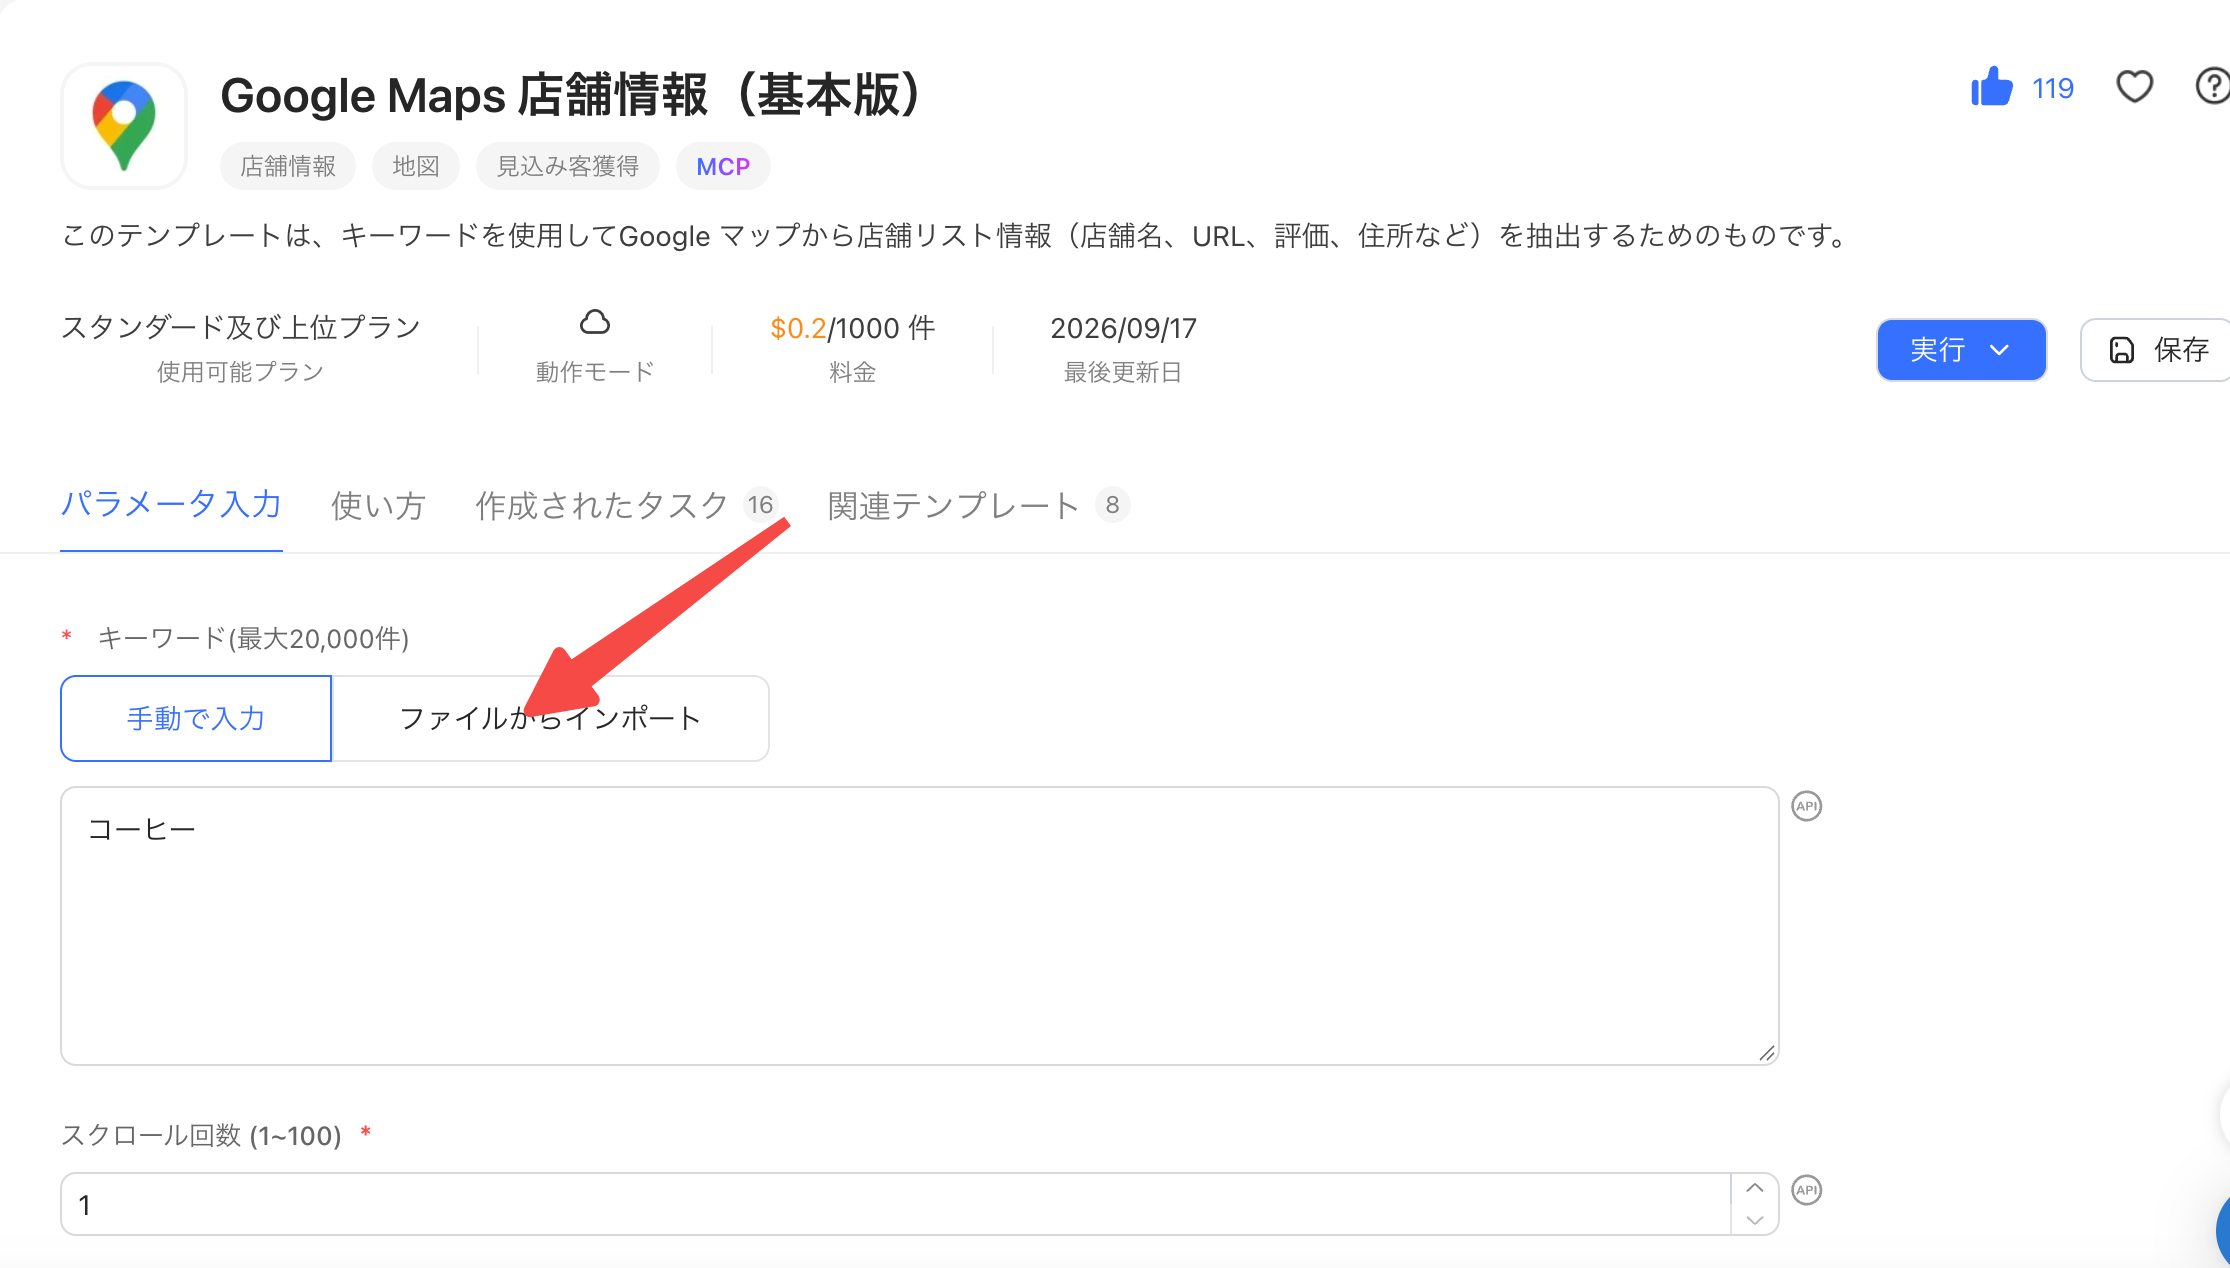
Step 2:検索キーワードを入力する
選択したテンプレートにフィールドなどを入力します。ここでは、キーワードを「コーヒー」と設定し、スクロール回数を1回と設定しました。
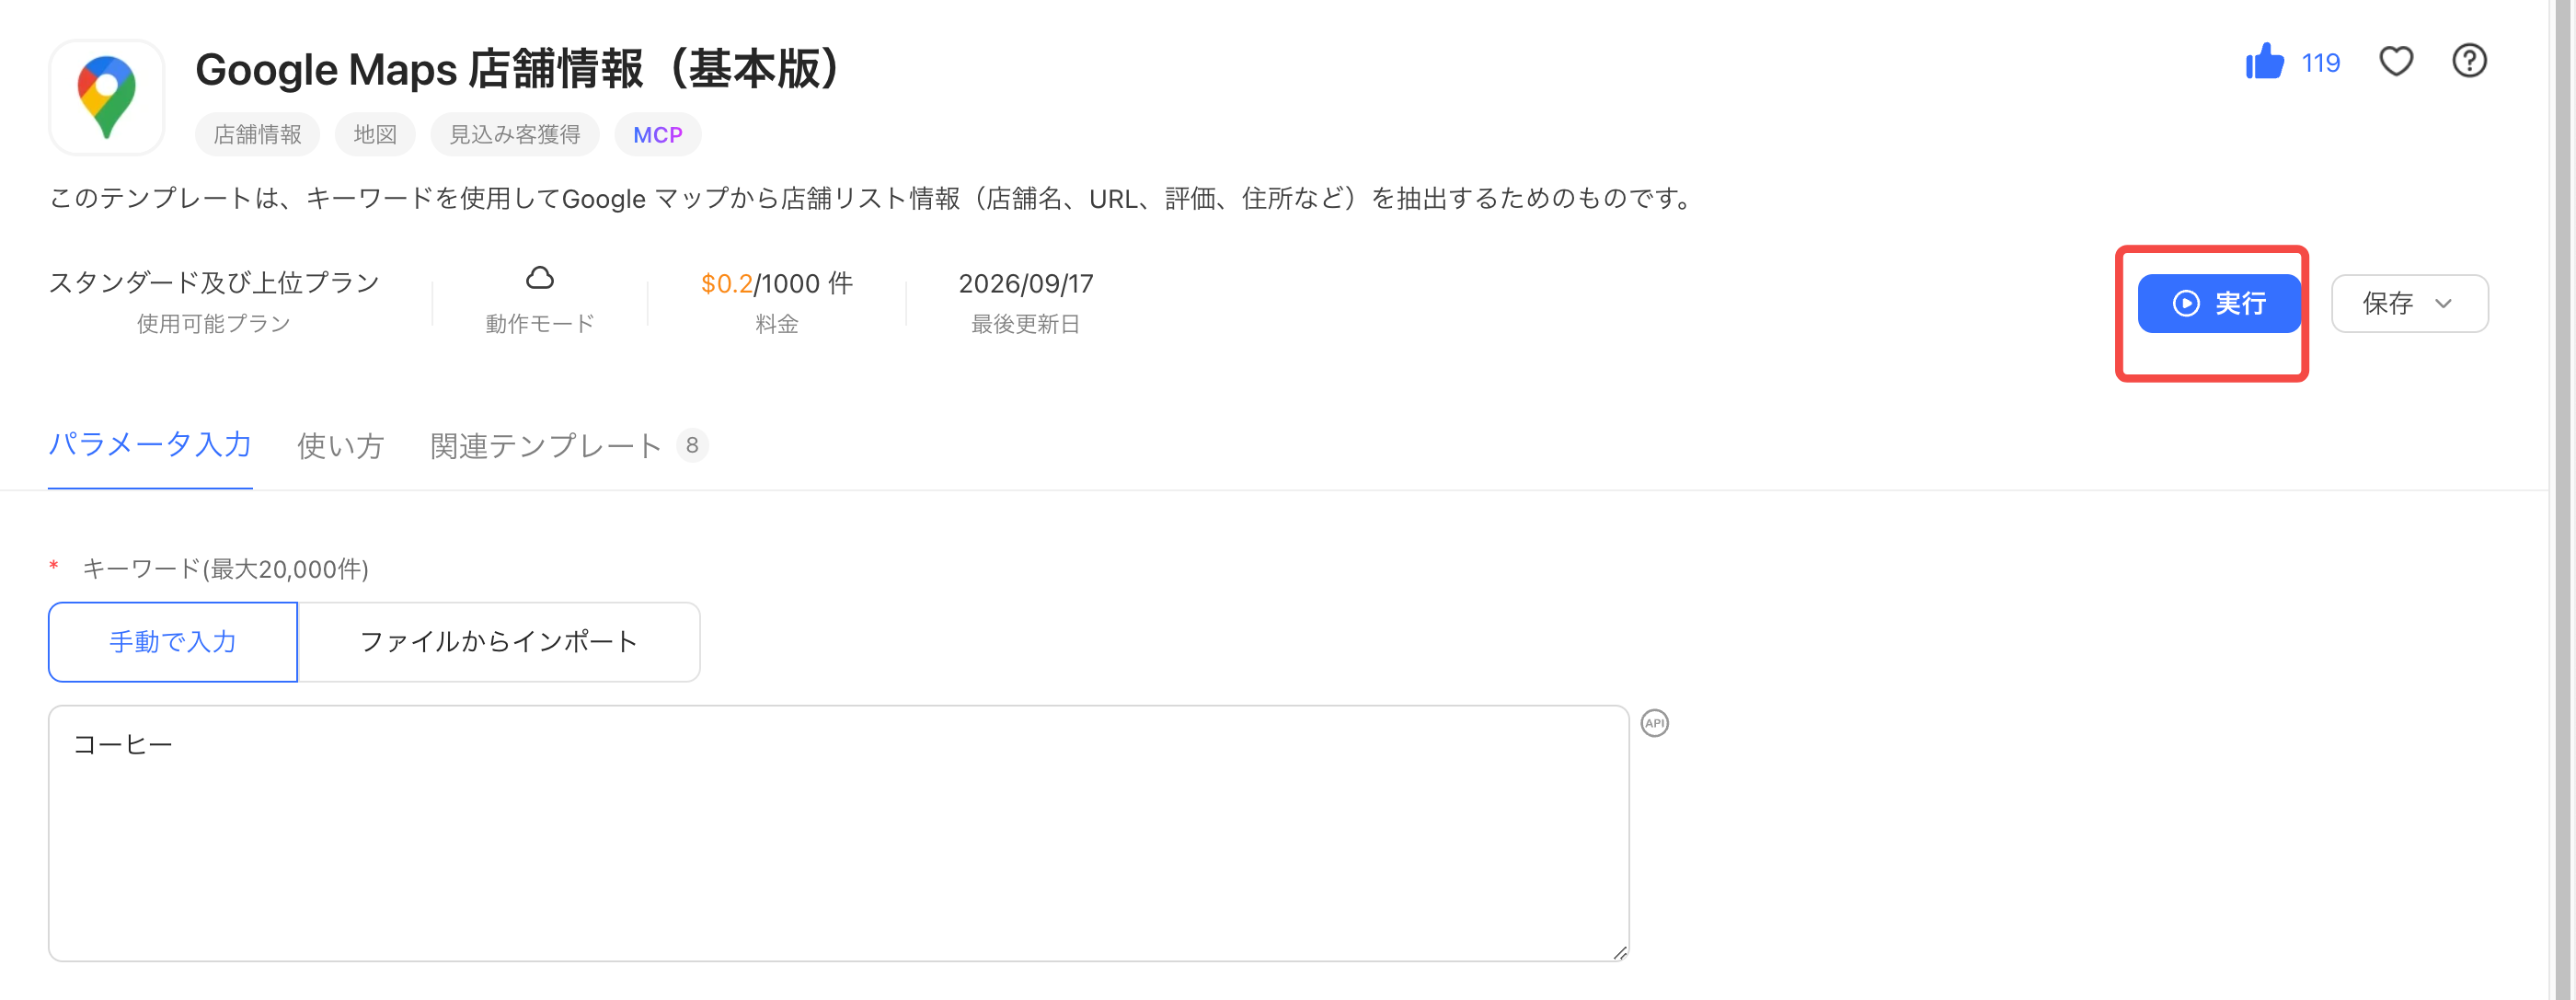
Step 3:データの収集を始める
「実行」をクリックし、データの収集を始めます。
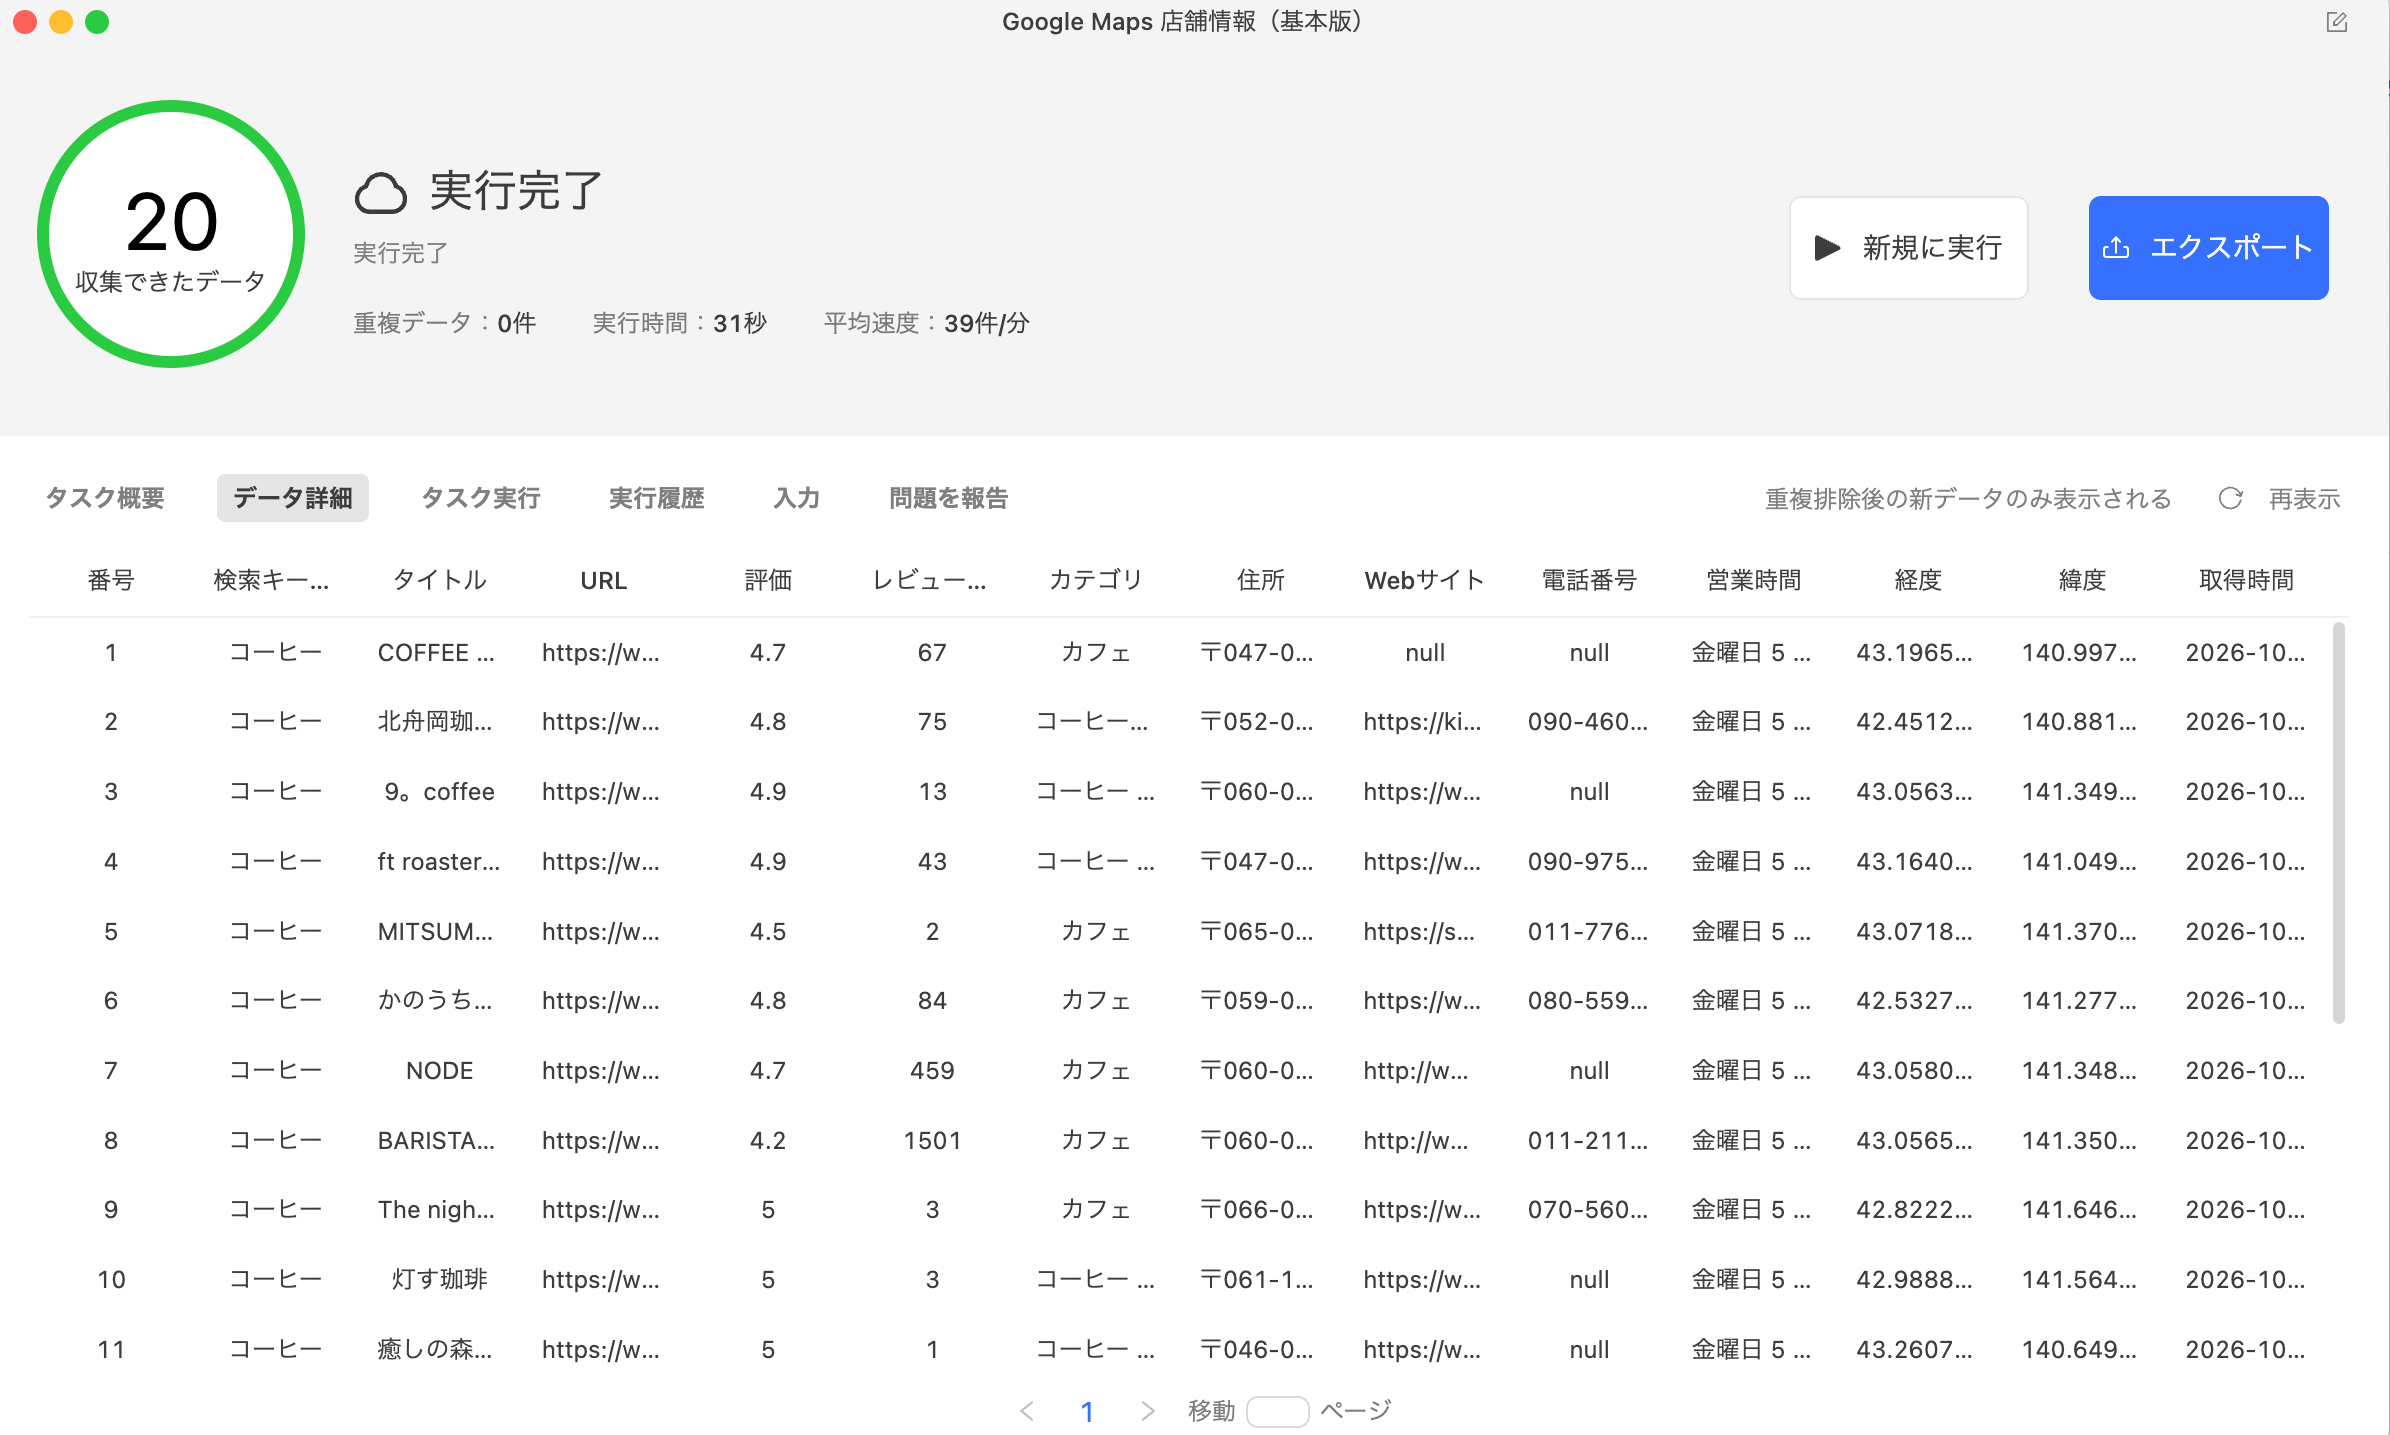
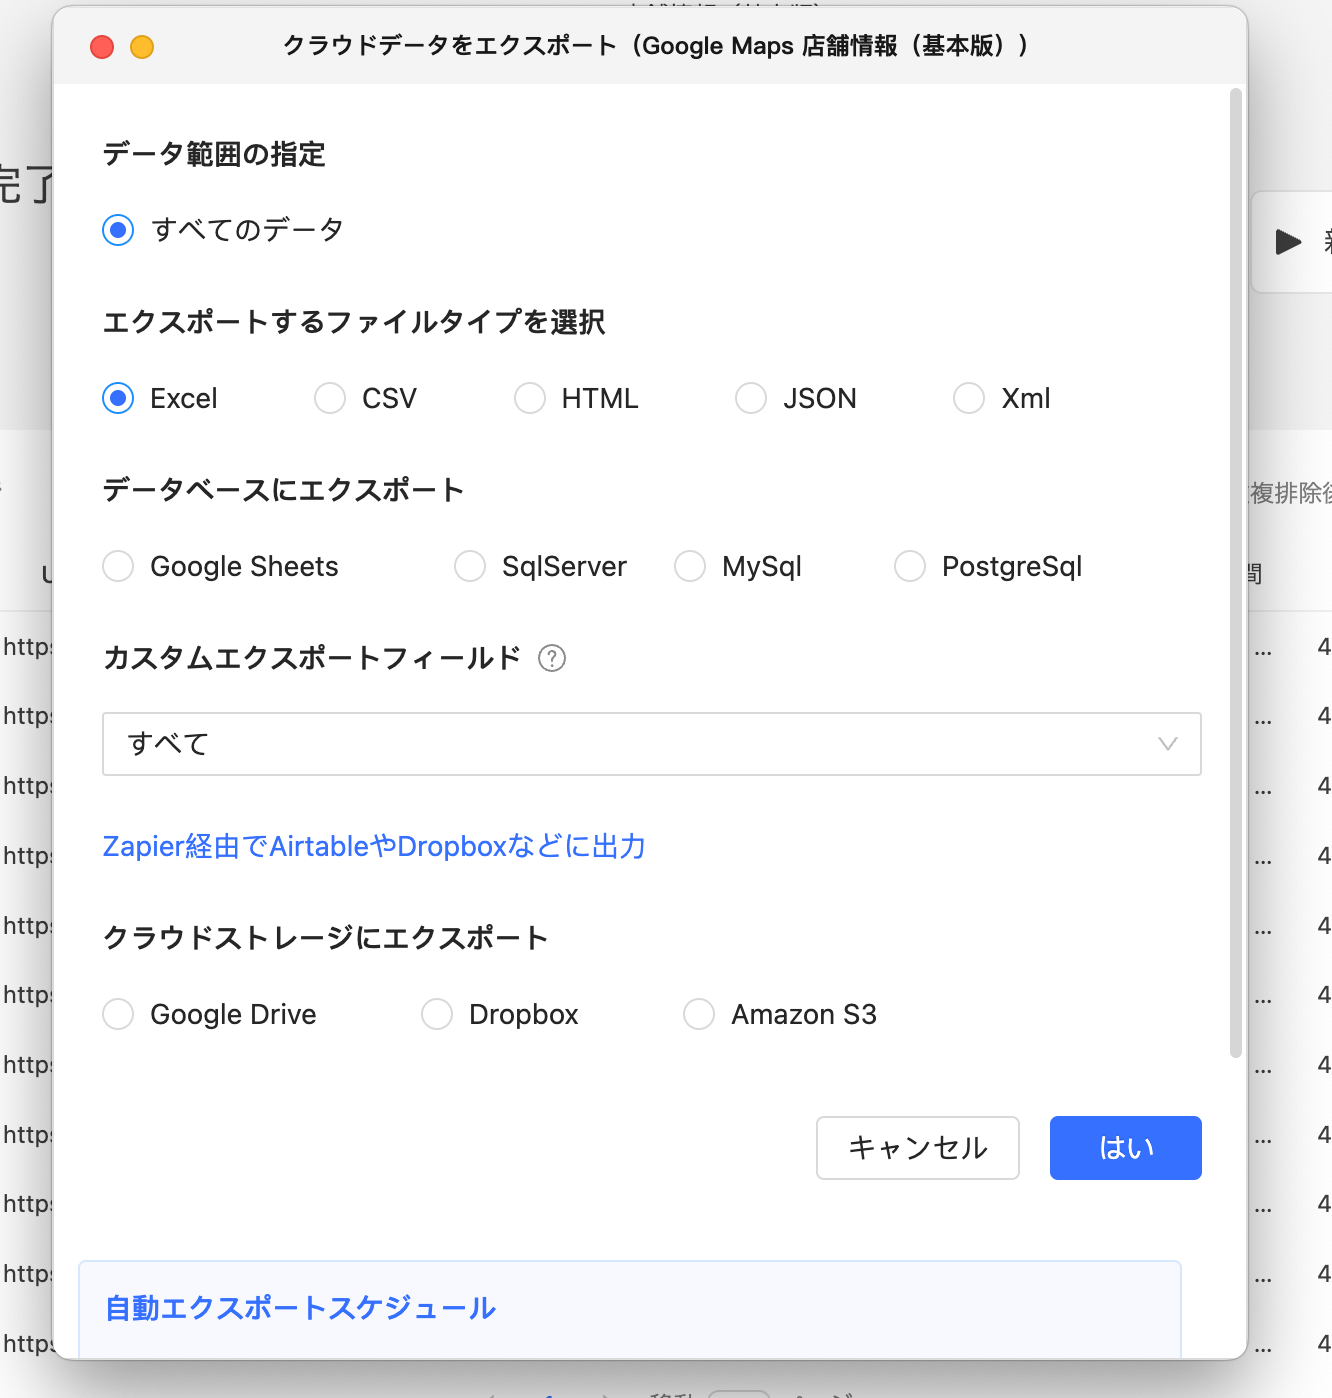
Step 4:データをExcelまたはCSVへエクスポートする
取得した結果を確認し、必要な範囲をExcelまたはCSVへエクスポートします。取得日時、検索キーワード、対象地域、テンプレート名も別列または管理台帳に記録すると、再実行時に比較しやすくなります。Google Mapsの規約上、取得データの保存や外部利用が認められるかは、エクスポート前に改めて確認してください。Google Mapsに特化した方法と注意点は、店舗情報を収集する方法の解説も参照してください。
テンプレートがないWebサイトをカスタムタスクで取得する手順
テンプレートがないサイトでは、Octoparseのデスクトップ版で対象URLを開き、取得項目、繰り返し、ページ送り、詳細ページをカスタムタスクとして設定します。いきなり全件を実行せず、数ページでフィールドとワークフローを検証するのが安全です。
Step 1:取得したいデータと利用条件を整理する
対象URL、必要なフィールド、取得件数、更新頻度、出力形式を決めます。利用規約、robots.txt、著作権、個人情報、アクセス負荷も確認し、取得しない項目を先に決めます。
Step 2:Octoparseクライアントで対象URLを開く
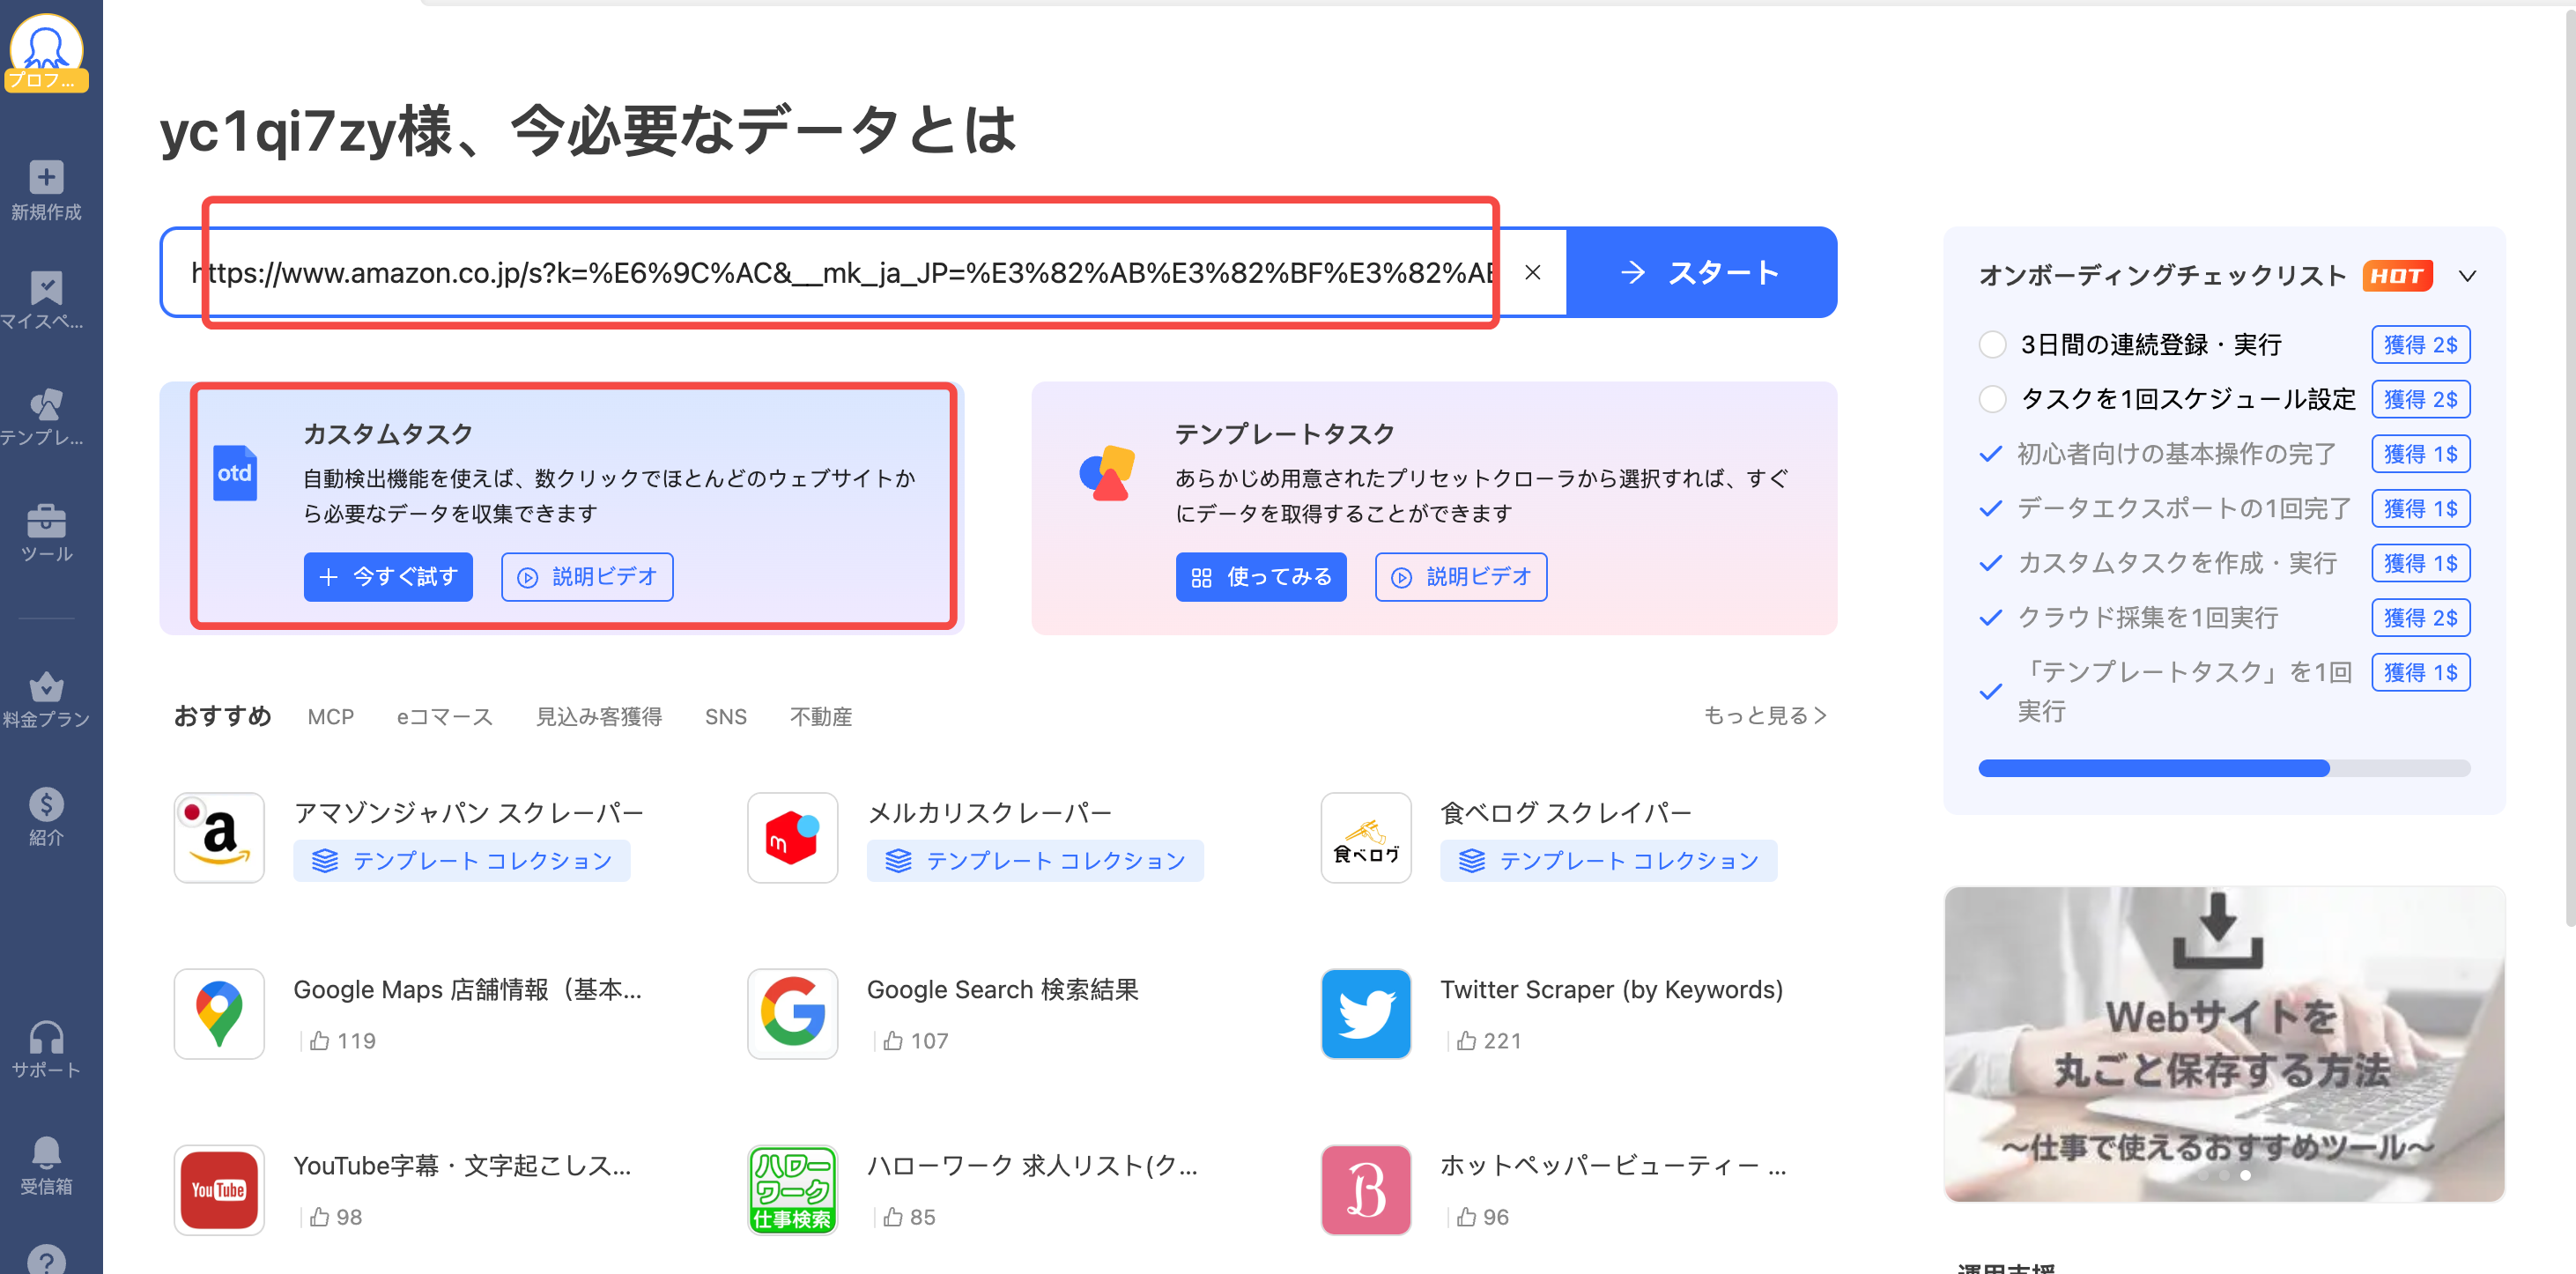
Octoparseのデスクトップアプリを起動し、ホーム画面へ対象ページのURLを入力して開始します。または「新規作成」から「カスタムタスク」を選択します。カスタムタスクの編集はWeb版ではなくクライアントで行います。
Step 3:自動検出の候補を確認する
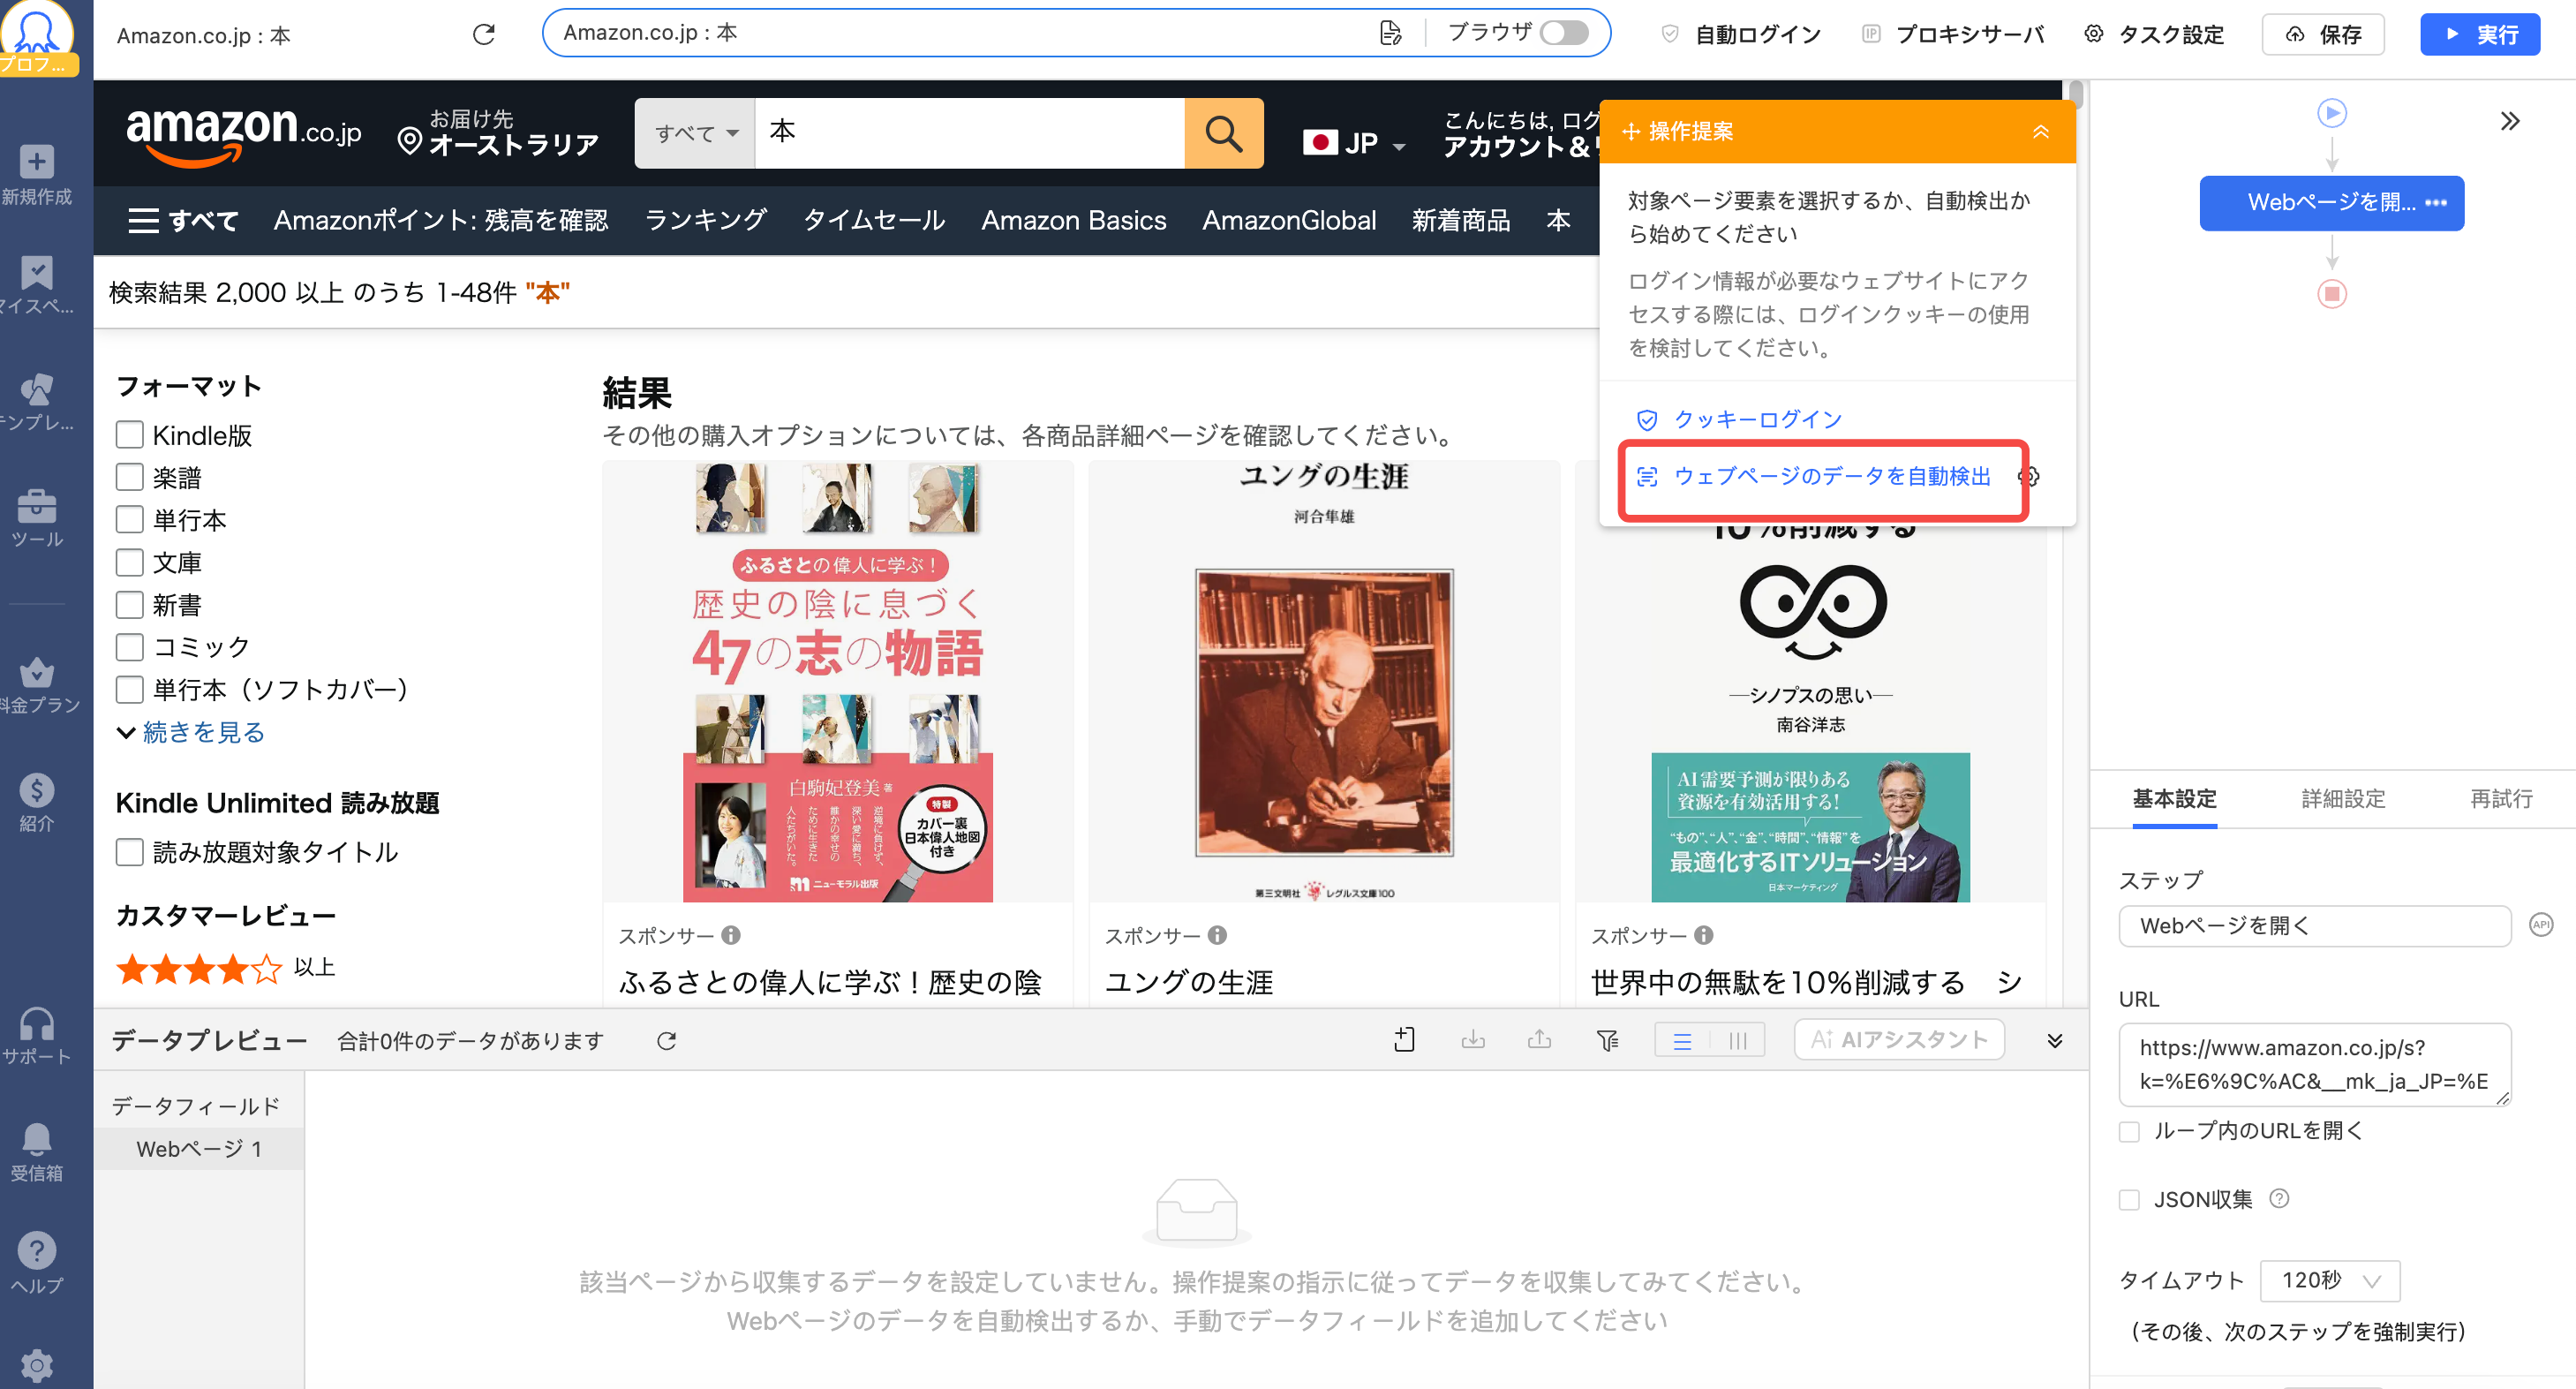
ページが読み込まれたら、自動検出が提案する一覧、ページ送り、詳細ページなどの処理を確認します。提案されたフィールドが目的と一致しない場合は、そのまま全件実行せず、必要な要素を手動で選択します。
Step 4:必要な項目をクリックして抽出フィールドを作る
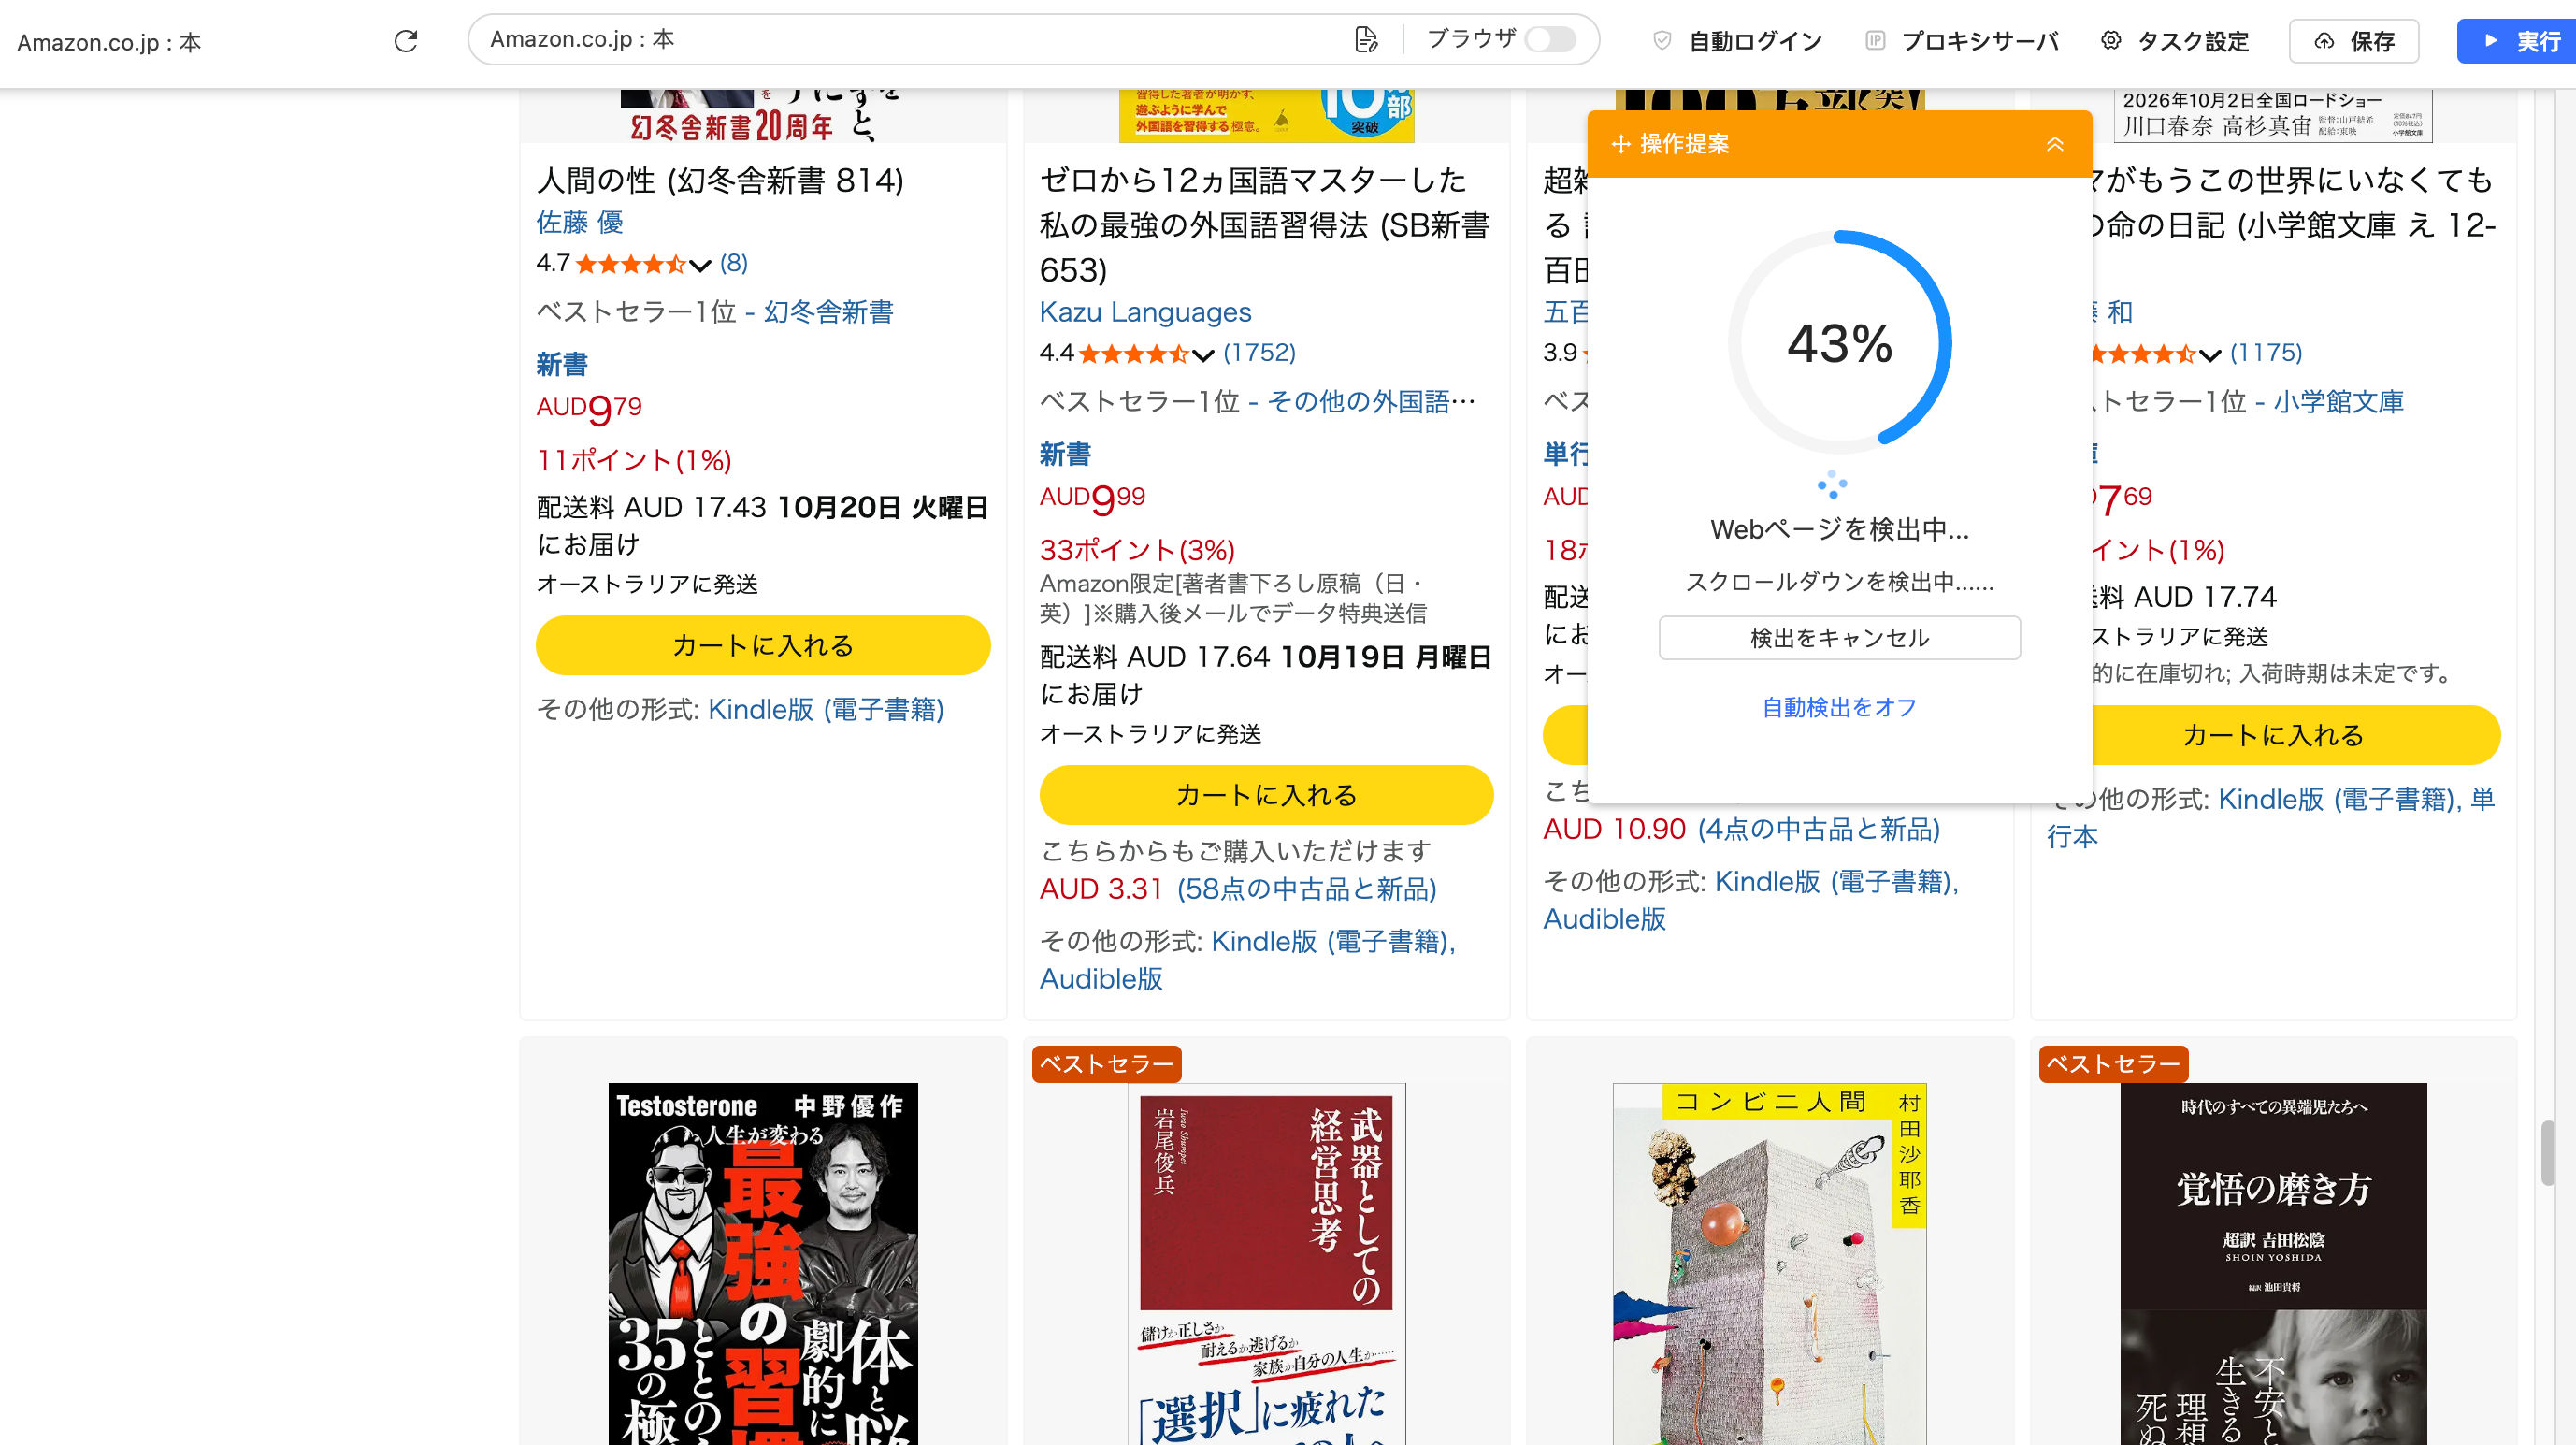
自動検出が完了したら、フィールド名とデータプレビューを確認してください。もし問題がなければ、「ワークフローを生成」をクリックし、その後、「実行」をクリックします。
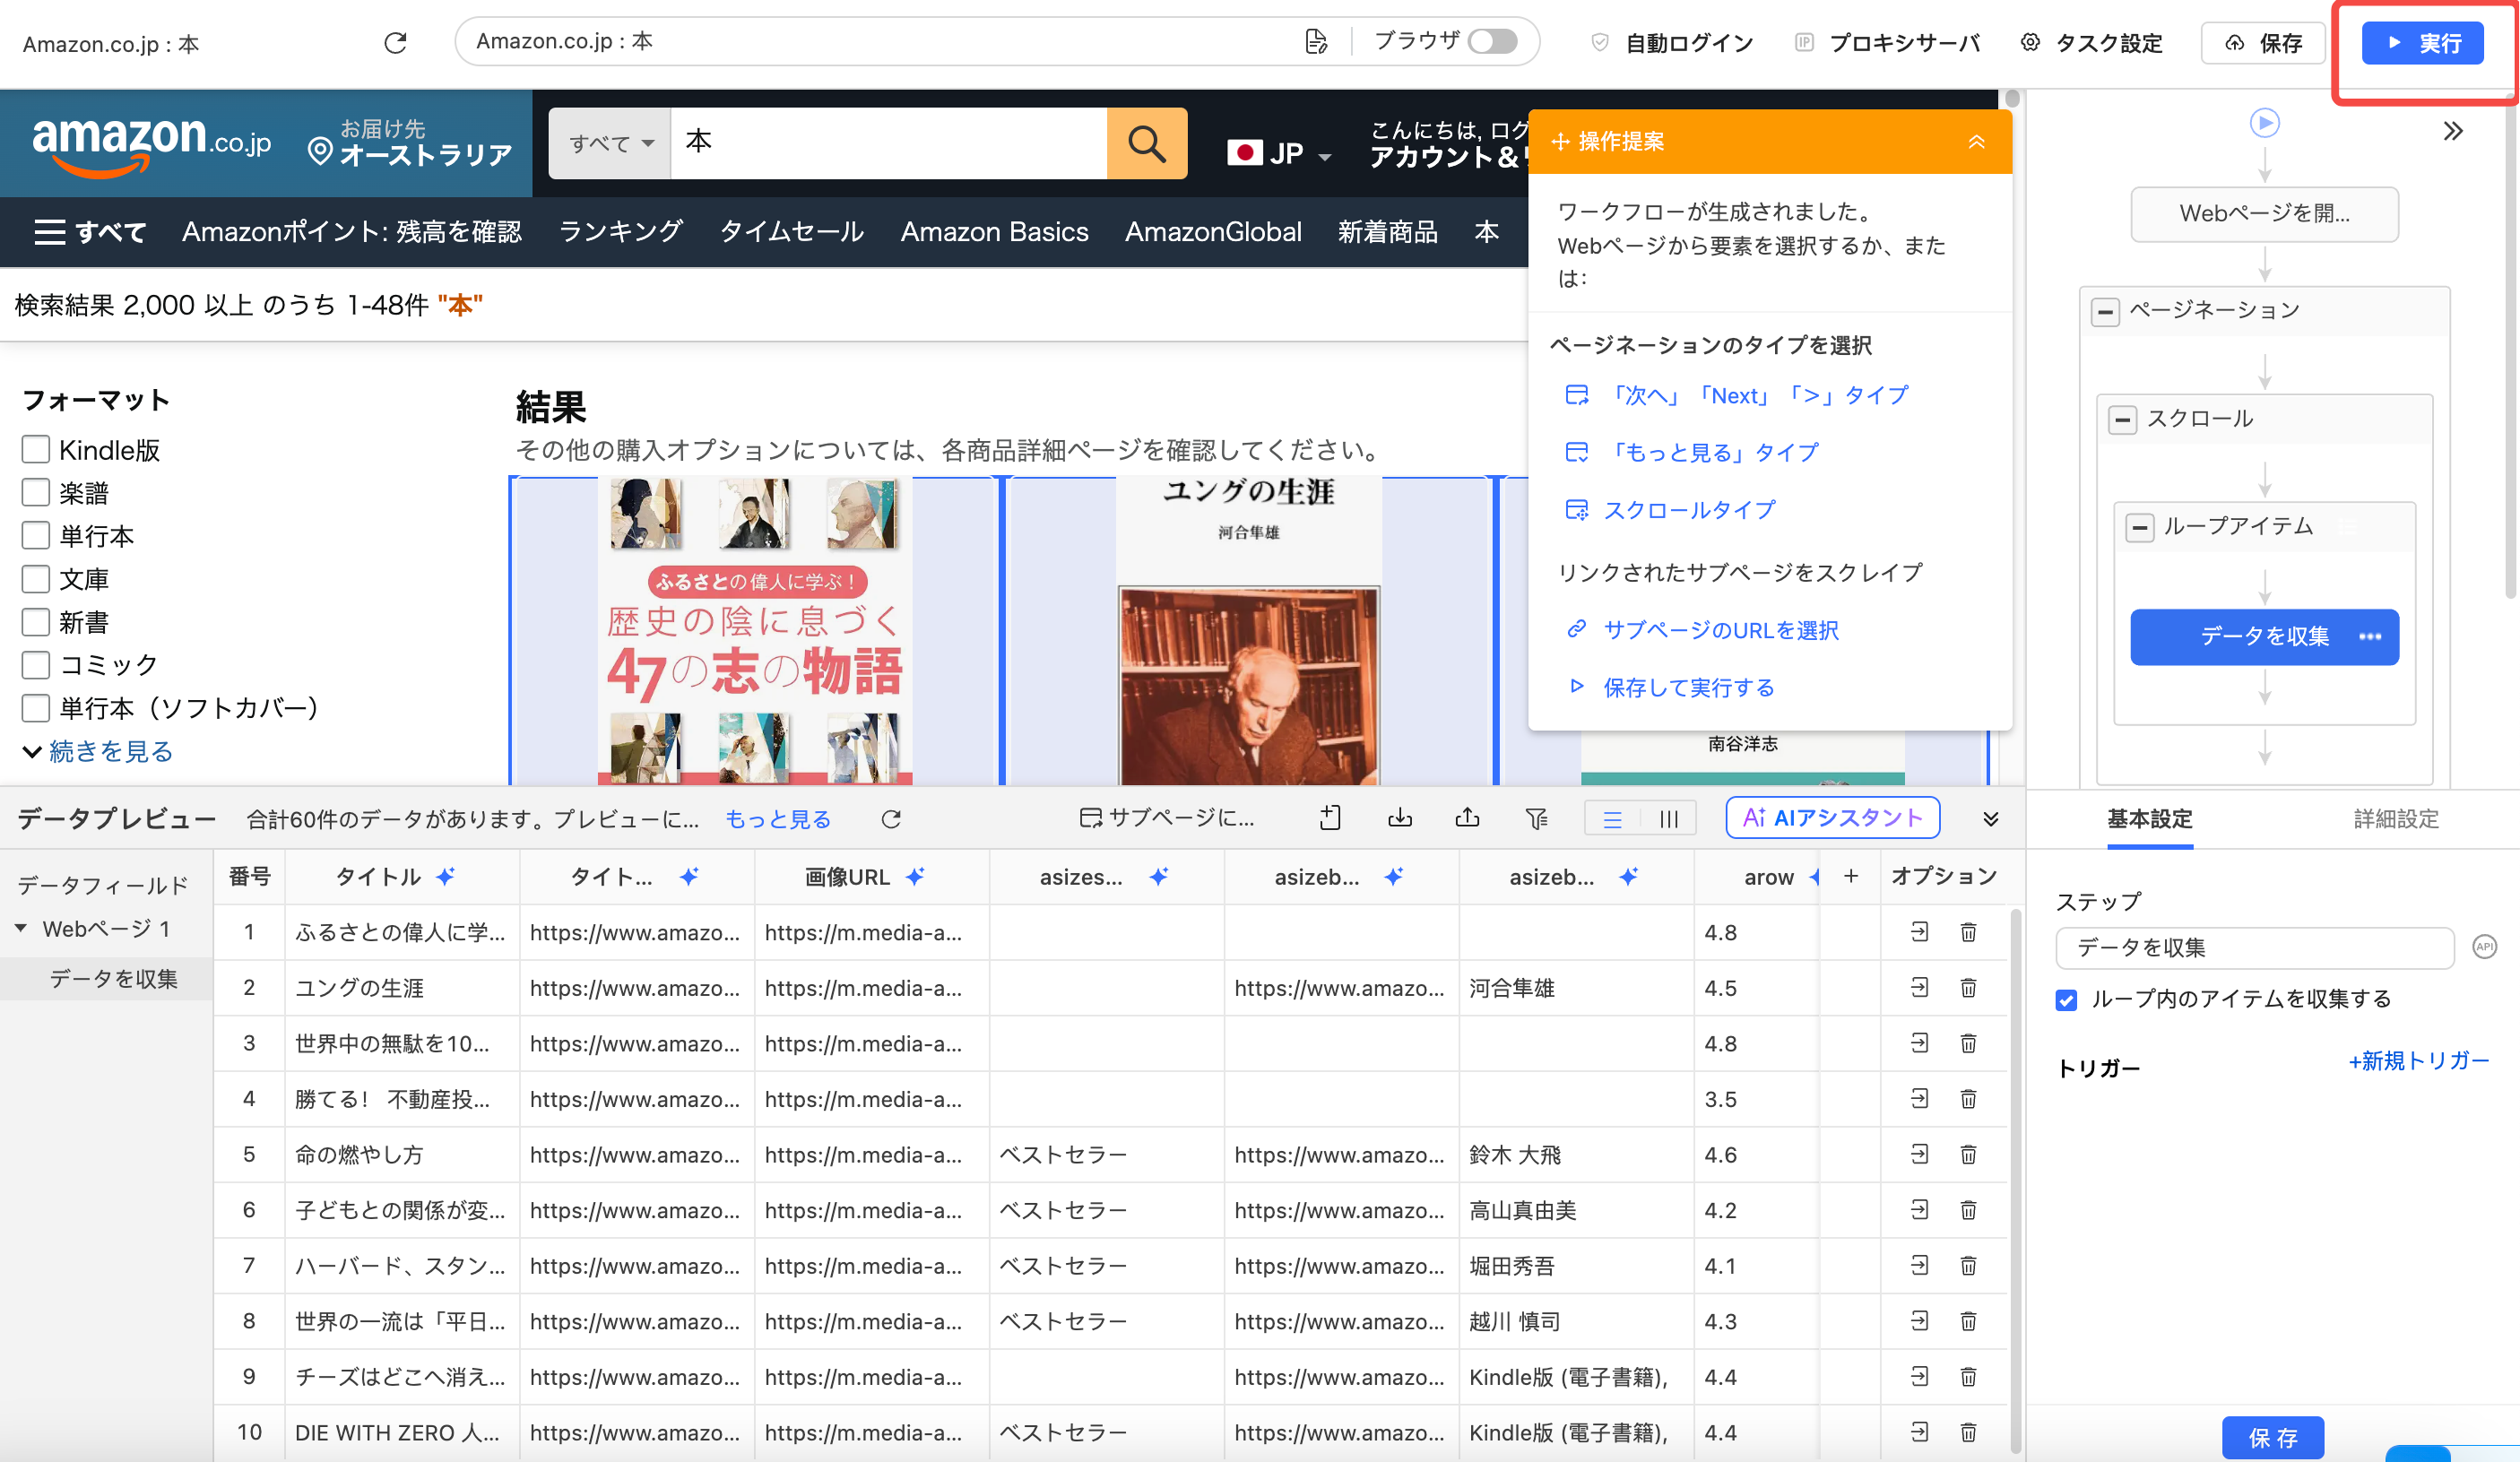
Step 5:ローカルまたはクラウドで実行する
利用可能な実行方式を選びます。ローカル実行では動作を観察しやすく、対応する有料プランのクラウド実行ではPCを起動し続けずにスケジュール運用できます。
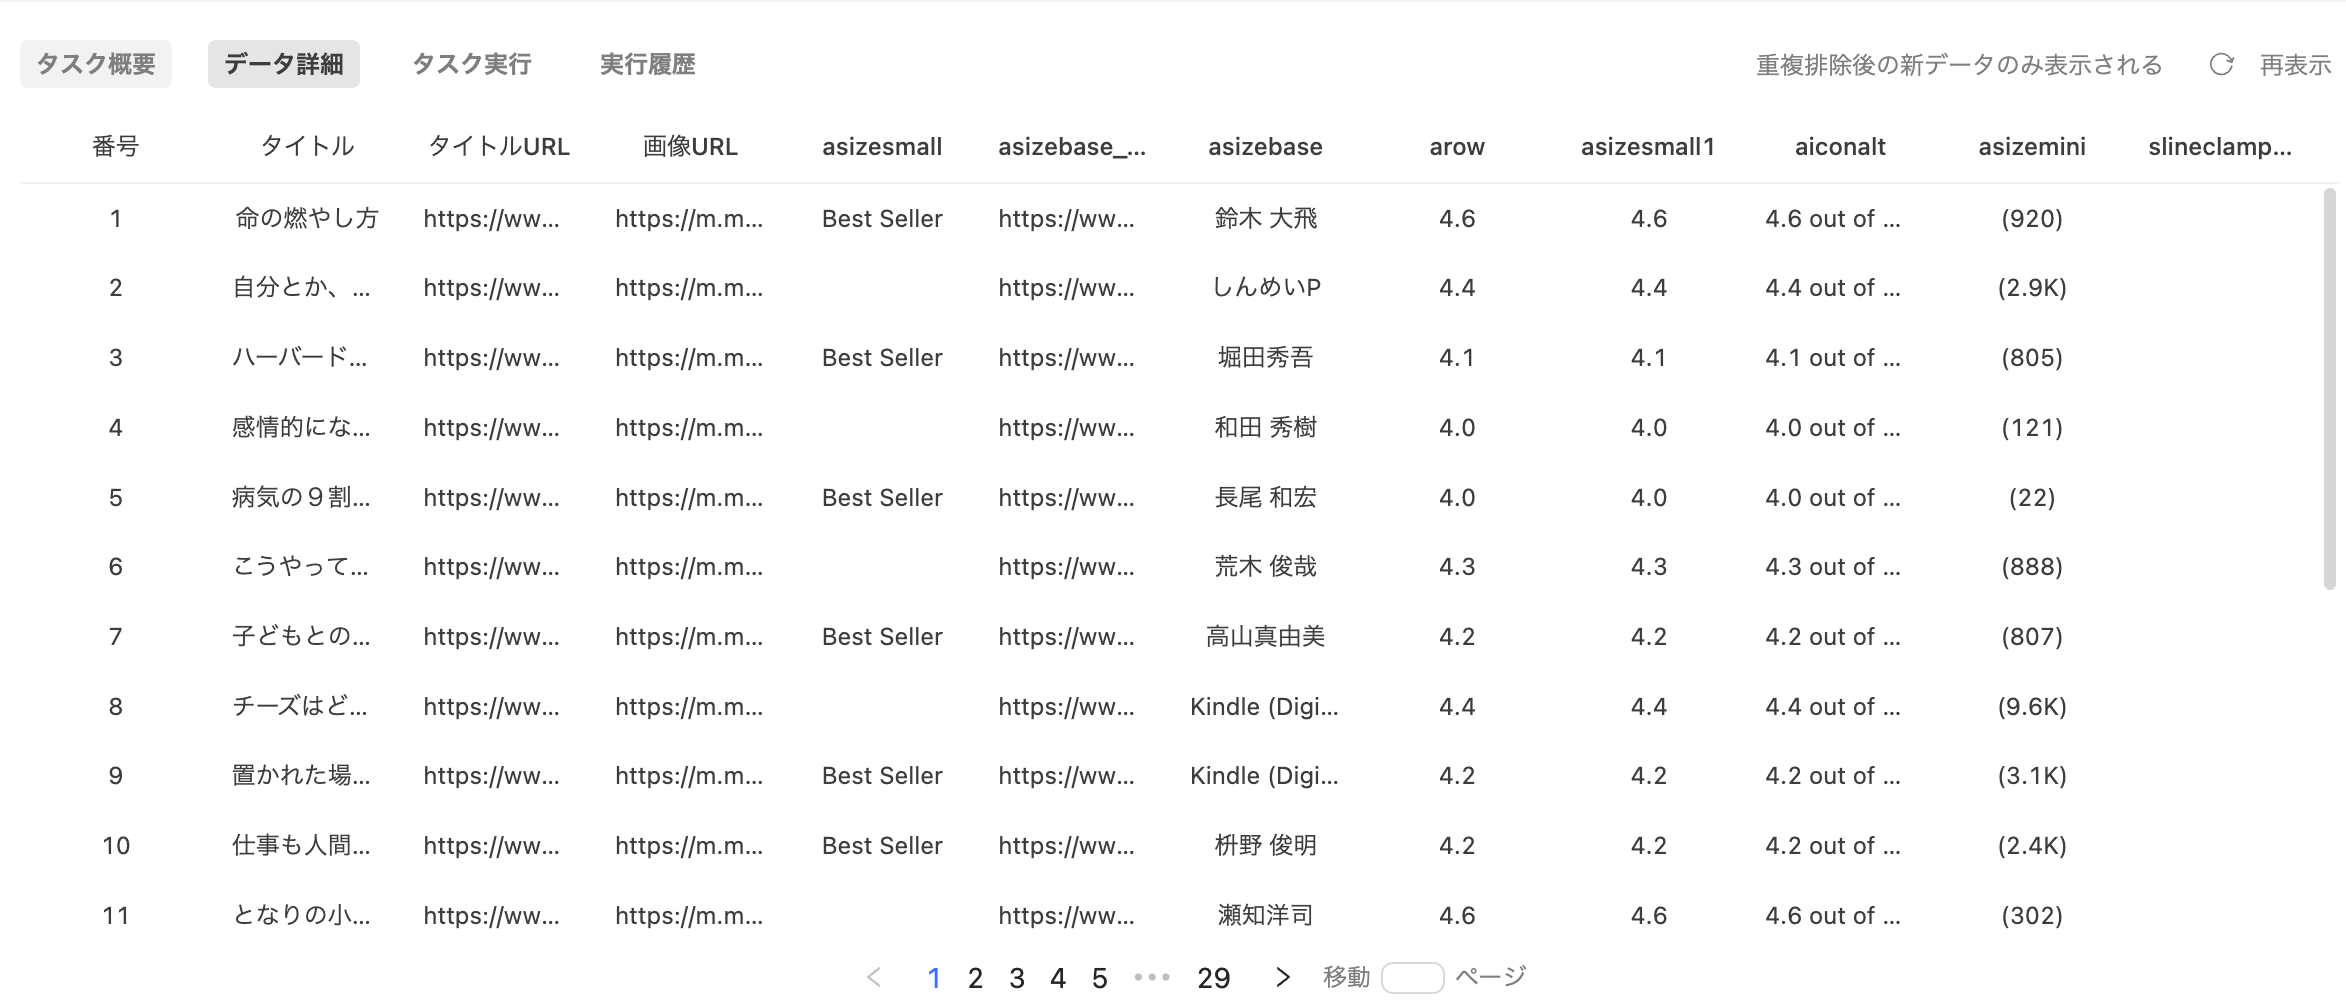
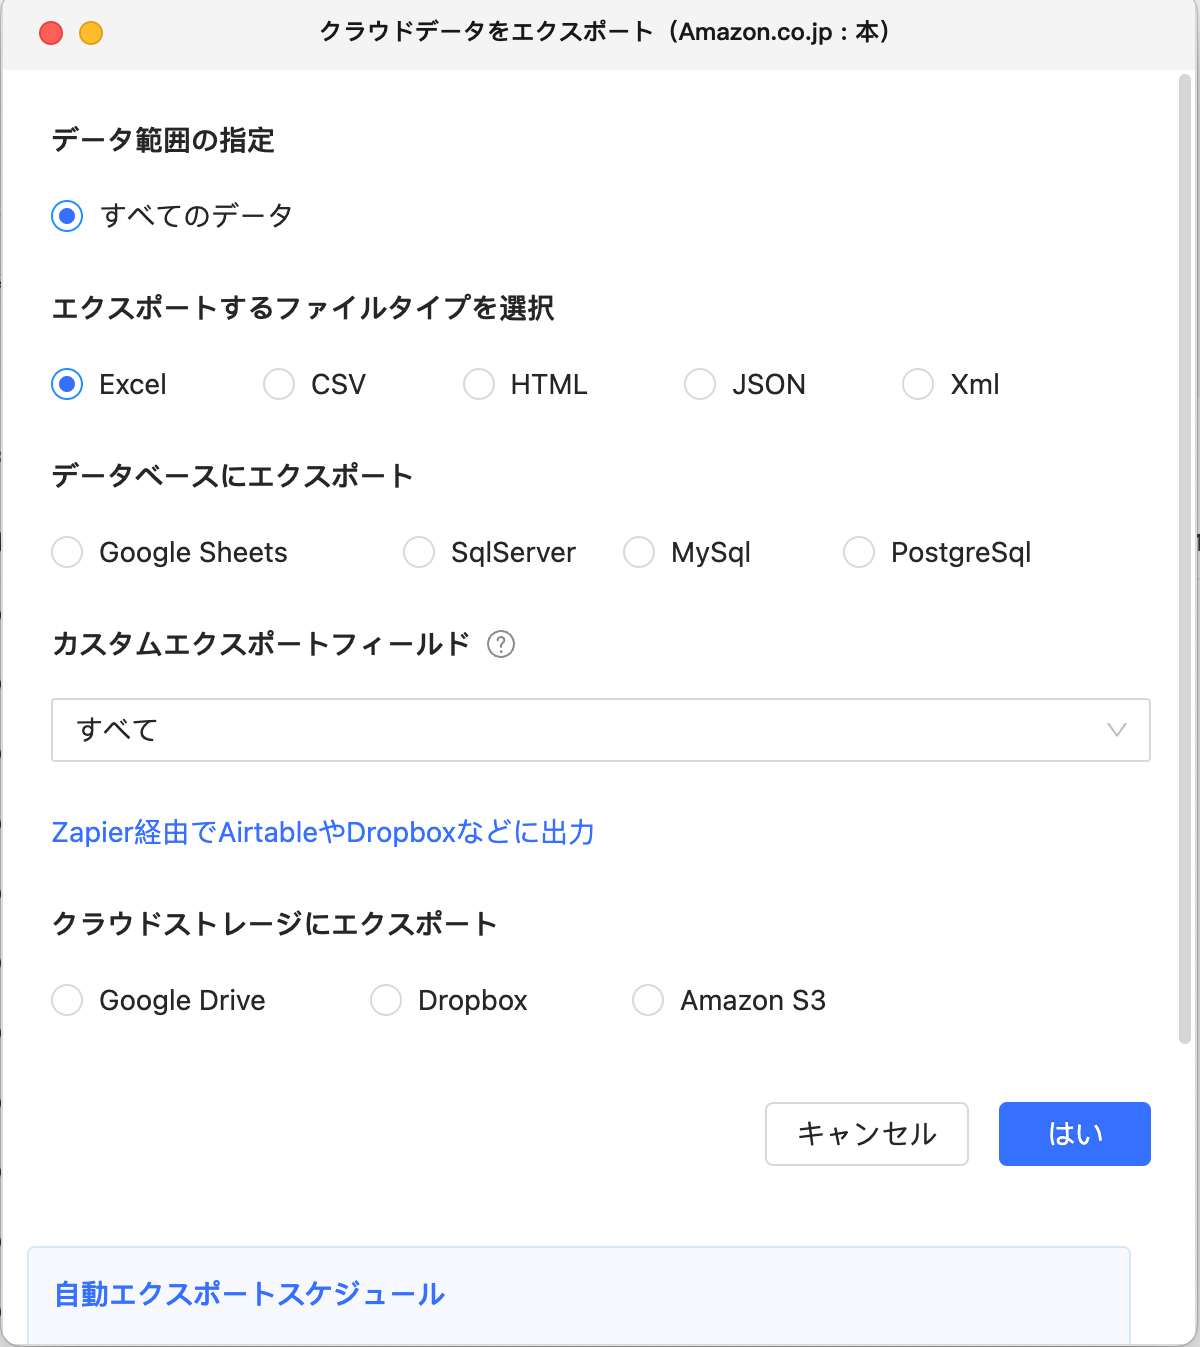
Step 6:データを検証してエクスポートする
実行後に行数、重複、空欄、主要フィールドのサンプルを確認し、Excel、CSV、JSONなど必要な形式へ出力します。更新データを継続保存する場合は、取得日時と一意のIDまたはURLを持たせ、前回分との重複を管理します。
Octoparseの料金と無料版で確認できること
Octoparseは無料版でローカル収集を試し、定期実行やクラウド収集が必要になった段階で有料プランを検討できます。以下は2026年10月9日に確認した日本市場向けの価格です。契約時にはOctoparse日本版の料金ページで最新情報と機能範囲を再確認してください。
| プラン | 年払い時の月額 | 月払い時の月額 | 主な位置付け |
|---|---|---|---|
| Free | 0 USD / 0 JPY | 0 USD / 0 JPY | 10タスク、ローカル実行、月最大50,000行のエクスポート |
| Standard | 99 USD/月 | 119 USD/月 | 定期的なクラウド収集を行う小規模チーム |
| Professional | 249 USD/月 | 299 USD/月 | より大規模・高度な運用 |
| Enterprise | 個別見積もり | 個別見積もり | 要件に応じた企業向け構成 |
上表では、年度総額、年間の節約額、為替換算、税込価格を計算していません。また、テンプレートによってはサブスクリプションとは別の利用料金やクレジットが必要な場合があります。実行前の画面に表示される費用と条件を確認してください。
APIがないサイトから取得できないときの原因
データを取得できない原因は、URLの誤りだけでなく、JavaScriptの読み込み、ページ送り、ログイン、アクセス制限、サイト変更、フィールド設定に分かれます。いきなり回避策を増やすのではなく、どの工程で期待したデータがなくなるかを切り分けます。
| 症状 | 考えられる原因 | 最初に確認すること |
|---|---|---|
| 画面にはあるがプレビューが空欄 | JavaScriptの読み込み待機不足、要素選択の誤り | 読み込み完了後の要素と取得属性を確認する |
| 最初のページしか取得できない | ページ送りや無限スクロールが未設定 | ループと終了条件を確認する |
| 途中で403・429になる | アクセス制限、頻度過多 | 実行を止め、規約とアクセス頻度を見直す |
| ログイン後のページが取得できない | セッション、権限、認証の問題 | 自動取得が許可されているか確認する |
| 以前のタスクが動かない | ページ構造やセレクタの変更 | 現在のページとワークフローを比較する |
| 件数は多いが品質が低い | 重複、広告行、空欄、誤った対応付け | 一意キー、必須列、サンプル行を検証する |
Webサイトからデータを取得する前に確認すべき注意点
安全な運用には、利用規約、公式の取得方法、著作権、個人情報、アクセス負荷、取得後の利用目的をまとめて確認する必要があります。robots.txtはクローラーへの技術的な意思表示として参考になりますが、それだけで適法性や契約上の可否が決まるわけではありません。
利用規約と公式の取得手段を確認する
対象サイトの利用規約、開発者ページ、API、CSV、RSS、オープンデータ、問い合わせ窓口を確認します。公式手段が同じ目的を満たす場合は、仕様と利用条件が明確な公式手段を優先します。
著作権・個人情報・データベースの権利を確認する
事実そのものと、文章、画像、レビュー、データベースの構成は同じ扱いではありません。氏名、連絡先、位置情報などを含む場合は、取得時点だけでなく利用目的、保管、第三者提供、削除対応も検討します。判断が難しい商用案件では、法務または専門家へ相談してください。
アクセス頻度とサーバー負荷を抑える
必要以上の並列実行や短い間隔での再取得を避けます。少量テストから始め、待機時間、再試行回数、実行時間帯、差分取得を設計してください。エラーが増えた場合は、回避を試みる前にタスクを停止して原因を確認します。
取得後の保存・共有・営業利用も確認する
閲覧が認められていても、長期保存、社外共有、再配布、AI学習、営業メールへの利用が同じ条件で認められるとは限りません。取得元、取得日時、利用目的、削除期限、共有範囲を管理台帳へ記録すると監査しやすくなります。
APIがないサイトのデータ取得でよくある質問
質問1:APIがない場合、スクレイピングしか方法はありませんか?
いいえ。CSV、RSS、ブラウザの保存機能、オープンデータ、データ販売、運営者への提供依頼なども候補です。必要なデータ量が少なければ手作業の方が合理的な場合もあります。
質問2:Webスクレイピングは違法ですか?
Webスクレイピングという技術自体を一律に違法とはいえませんが、対象、取得方法、アクセス負荷、契約、著作権、個人情報、取得後の使い方によって問題になる可能性があります。対象サイトの条件を個別に確認してください。
質問3:無料でWebサイトのデータをExcelに保存できますか?
少量ならコピー&ペーストやブラウザ拡張、技術があればPython、ノーコードで試すならOctoparseのFreeプランが候補です。無料範囲、出力上限、対象サイトの条件を確認してください。
質問4:動的なWebサイトからもデータを取得できますか?
取得できる場合があります。JavaScriptの実行、読み込み待機、クリック、スクロールが必要なページでは、Octoparseの内蔵ブラウザ、Playwright、Seleniumなどのブラウザ型の方法を検討します。
質問5:PythonとOctoparseはどちらを選ぶべきですか?
短期間でノーコードの検証を行い、業務担当者が運用するならOctoparseが候補です。独自ロジック、ソース管理、テスト、自社システムへの深い統合が必要で、開発・保守を担当できるならPythonが適しています。
質問5:Googleマップのデータは自由に保存・利用できますか?
自由に利用できるとは限りません。Google MapsのコンテンツにはGoogleの利用規約とサービス固有条件が適用され、抽出、保存、再利用などが制限される場合があります。最新の公式条件を確認し、必要に応じてPlaces API、OpenStreetMap、政府オープンデータ、企業自身が公開する情報などを比較してください。
まとめ
いかがでしょうか。この記事では、「APIがないWebサイトからデータを取得するには?」について詳しく紹介しました。APIがないWebサイトからデータを取得するときは、公式の代替手段を確認し、データ量、更新頻度、ページ構造、運用体制、利用条件に応じて方法を選びます。少量なら手作業、ノーコードで定型データを繰り返し収集するならOctoparse、複雑な処理ならPythonやブラウザ自動化、保証が必要なら正式なデータサービスが候補です。
Octoparseを使う場合も、最初は少量のURLでテストし、取得行数、空欄、重複、フィールドの対応、実行時間を記録してください。ツールの機能とデータ利用の許可は別に判断し、対象サイトとデータ提供者を尊重した運用を行うことが重要です。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール