大量データを安定して取得するには、件数の上限だけでなく、定期実行、失敗時の再取得、データ品質、保守体制でツールを選びます。業務担当者が継続運用するならOctoparse(オクトパース・オクトパス)、Actorを活用する開発チームならApify、Pythonで細かく制御するならScrapy、既存コードの取得基盤を補うならScraperAPIが候補です。必要な項目と利用条件を満たす公式APIがある場合は、先に検討してください。
ここで扱うのは、公開Webページの商品・価格・企業・求人などを表形式で繰り返し集める業務です。重要なのは「一度に何行取れたか」だけではありません。必要な範囲を期限内に集め、欠損や重複を確認し、次回も使える状態で届けられるかを評価します。基礎から確認したい方は、Webスクレイピングの仕組みとAPIとの違いをご覧ください。
大量データの収集は「件数・頻度・納期」から選ぶ
「大量」に共通の件数基準はありません。同じ1万行でも、一覧から取得できる場合と、1万件の詳細ページを開く場合では処理量が異なります。選定前に、対象URL、取得項目、実行頻度、納期、運用担当者を決めましょう。
| 収集の条件 | 最初に検討する方法 | 選定時の確認事項 |
|---|---|---|
| 必要なデータが公式に提供されている | データ源の公式API/ダウンロード | 提供項目、配信時刻、利用上限、保存・再利用条件 |
| 業務部門が複数ページを定期収集したい | Octoparse | 対象テンプレート、AI アシスタントの実行方式、クラウド運用条件 |
| 既存の収集プログラムを利用・拡張したい | Apify | Actorの対象範囲、保守、出力、利用料金 |
| 独自の解析・更新判定を細かく設計したい | Scrapy | Python担当者、実行環境、監視と保守の工数 |
| 自社コードはあるが、リクエスト基盤を補いたい | ScraperAPI | 非同期処理、対象サイト、解析・保存の担当範囲 |
取得行数とアクセス回数は同じではない
例えば、1ページ50商品を掲載する一覧から1万商品を取得するなら、一覧は計算上200ページです。各商品の詳細も必要なら、さらに1万ページの取得が加わります。これは設計用の仮定で、特定ツールの性能実測ではありません。画像などの読み込みや再試行もあるため、行数だけで所要時間を見積もらないことが重要です。
初回の全量取得と、その後の更新を分ける
初回は対象範囲を網羅し、その後は必要な更新頻度に応じて取得範囲を設計します。新着だけなら日付や掲載順を使えるか、価格監視なら対象IDの一覧を保てるかを確認してください。ただし新着だけの収集では、既存商品の価格変更や掲載終了を見落とす場合があります。更新の追跡と定期的な全体確認を組み合わせます。
大量データの継続収集に向く4つのツールを比較
以下は速度順位ではなく、誰が取得処理と運用を担当するかの比較です。同じサイト・項目・取得範囲で検証してから選んでください。
| ツール | 向いている人 | 大量収集で評価したい点 | 弱点・自社で担うこと |
|---|---|---|---|
| Octoparse | 収集開発の負担を抑えたい業務チーム | 公式テンプレート、AI アシスタント、クラウド実行とAPI/MCPを一つの運用にまとめやすい | プランの確認 |
| Apify | ActorとAPIを利用するチーム | 既存Actorの再利用、URLキュー、実行結果のシステム連携 | Actorごとの保守状況と費用を確認。独自要件では開発も必要 |
| Scrapy | Pythonで内製できるチーム | リクエストの制御、節流、状態保存、自社データ処理への組み込み | 実行環境、監視、対象サイトの変更対応を自社で設計 |
| ScraperAPI | 既存の収集コードを持つ開発者 | 非同期APIへの複数URLの一括投入 | 汎用HTML取得では解析・項目定義・品質管理・入庫を別途実装 |
Octoparse(オクトパース)は、大量のWebデータを継続的に収集したい企業やデータ分析チームに適したWebスクレイピングツールです。 AIによるスクレイパー作成から、クラウドでの並列実行、定期収集、データ出力まで、一つのプラットフォームで管理できます。
単発のデータ抽出だけでなく、数万〜数十万件規模のデータ収集や、複数サイトの継続的なモニタリングにも対応できる実行基盤が特徴です。
大量データの収集でOctoparseを選ぶメリット
- クラウド並列実行で大量データを効率よく収集:Octoparse Cloudでは、複数の収集タスクを同時に実行できます。Professionalプランは最大20件、Enterpriseプランは40件以上のクラウド同時実行に対応し、収集規模に応じて運用を拡張できます。
- IPローテーションで収集の中断リスクを軽減:クラウドIPの自動切り替えに加え、プロキシやCAPTCHA対策機能も利用でき、アクセス集中やブロックによる収集失敗のリスクを抑えられます。
- 定期実行で大量データを継続的に蓄積:PCを起動したままにする必要がなく、毎日・毎週などのスケジュールで収集を自動化。対応するタスクでは増分抽出も利用でき、更新データの収集を効率化できます。
- AIと既成テンプレートで構築・保守の負担を削減:680種類以上の既成スクレイパーに加え、AIアシスタントが自然言語の指示から収集方法を提案し、必要に応じて再利用可能なスクレイパーの構築を支援します。一度構築したタスクは繰り返し実行でき、毎回収集フローを作り直す必要がありません。
例えば、ECサイトの商品価格や在庫情報、Googleマップの店舗情報、求人サイトの募集情報などを、複数の地域・条件に分けて収集し、継続的な分析に活用できます。取得結果はCSV・Excel・JSON形式で出力でき、APIを通じた自社システムとの連携も可能です。
大量収集を始める際は、まず対象サイトで少量のデータをテストし、取得精度や実行時間を確認してから、クラウド並列実行や定期収集へ拡張する方法がおすすめです。 実際の収集速度や成功率はサイトの構造・アクセス制限・契約プランによって異なります。
次はOctoparseのAI アシスタントでデータを収集する方法について詳しく紹介します。
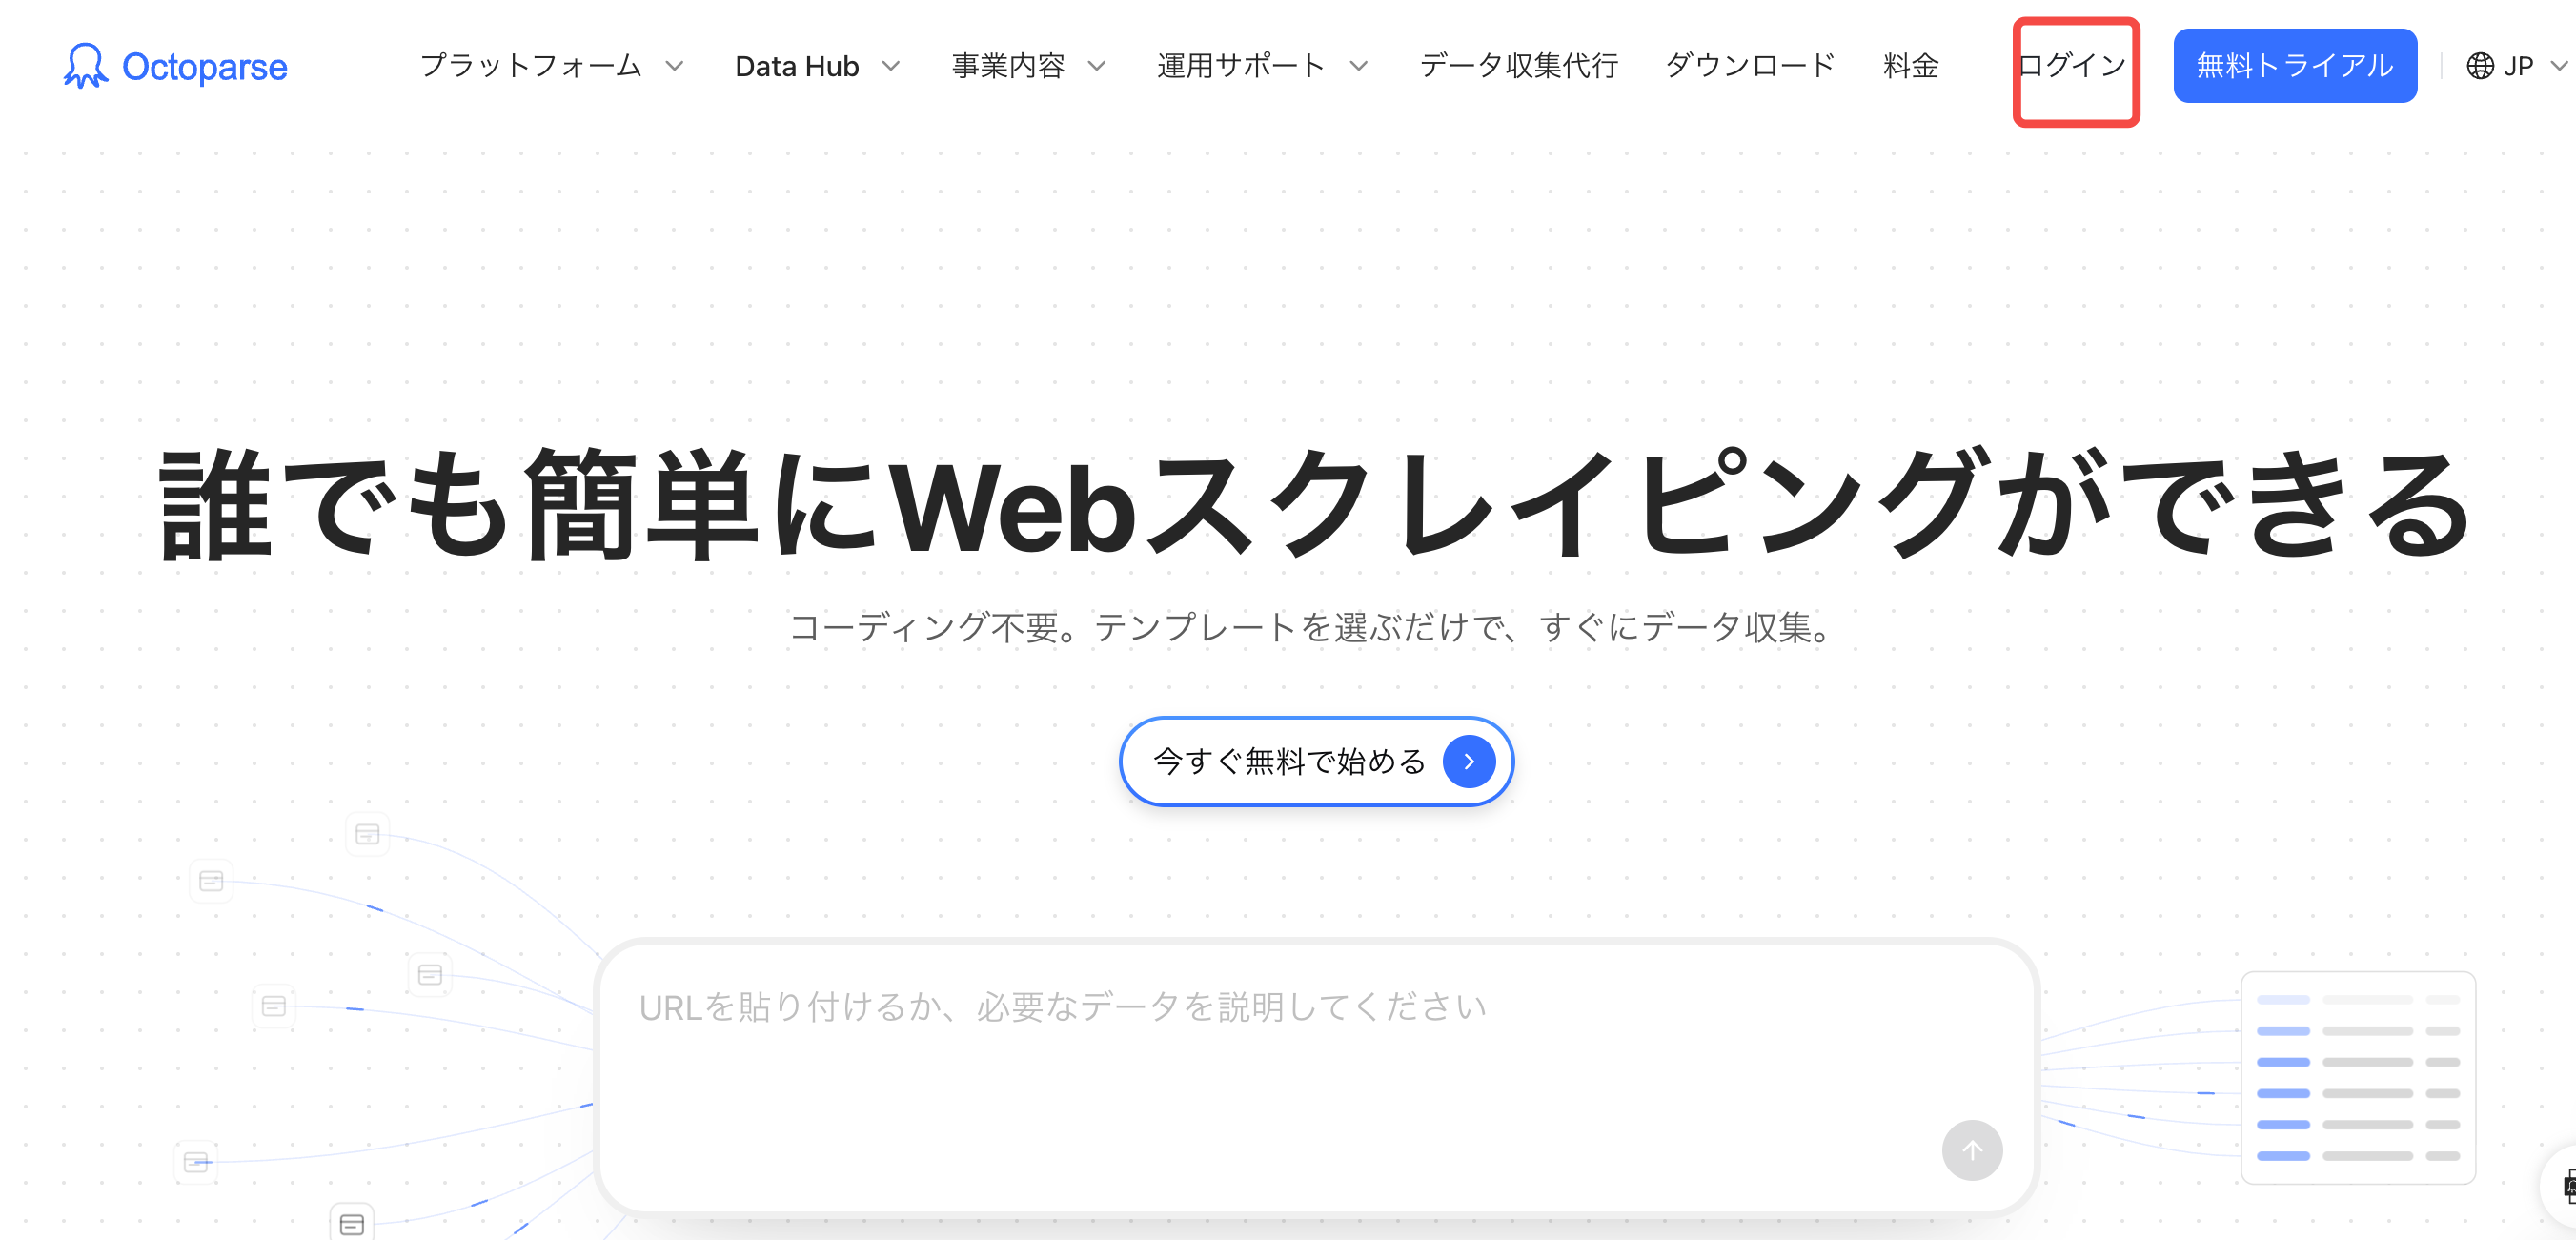
Step1:Octoparseのアカウントを作成
Octoparseでアカウントがない場合、まずは新規アカウントを作成し、ログインします。
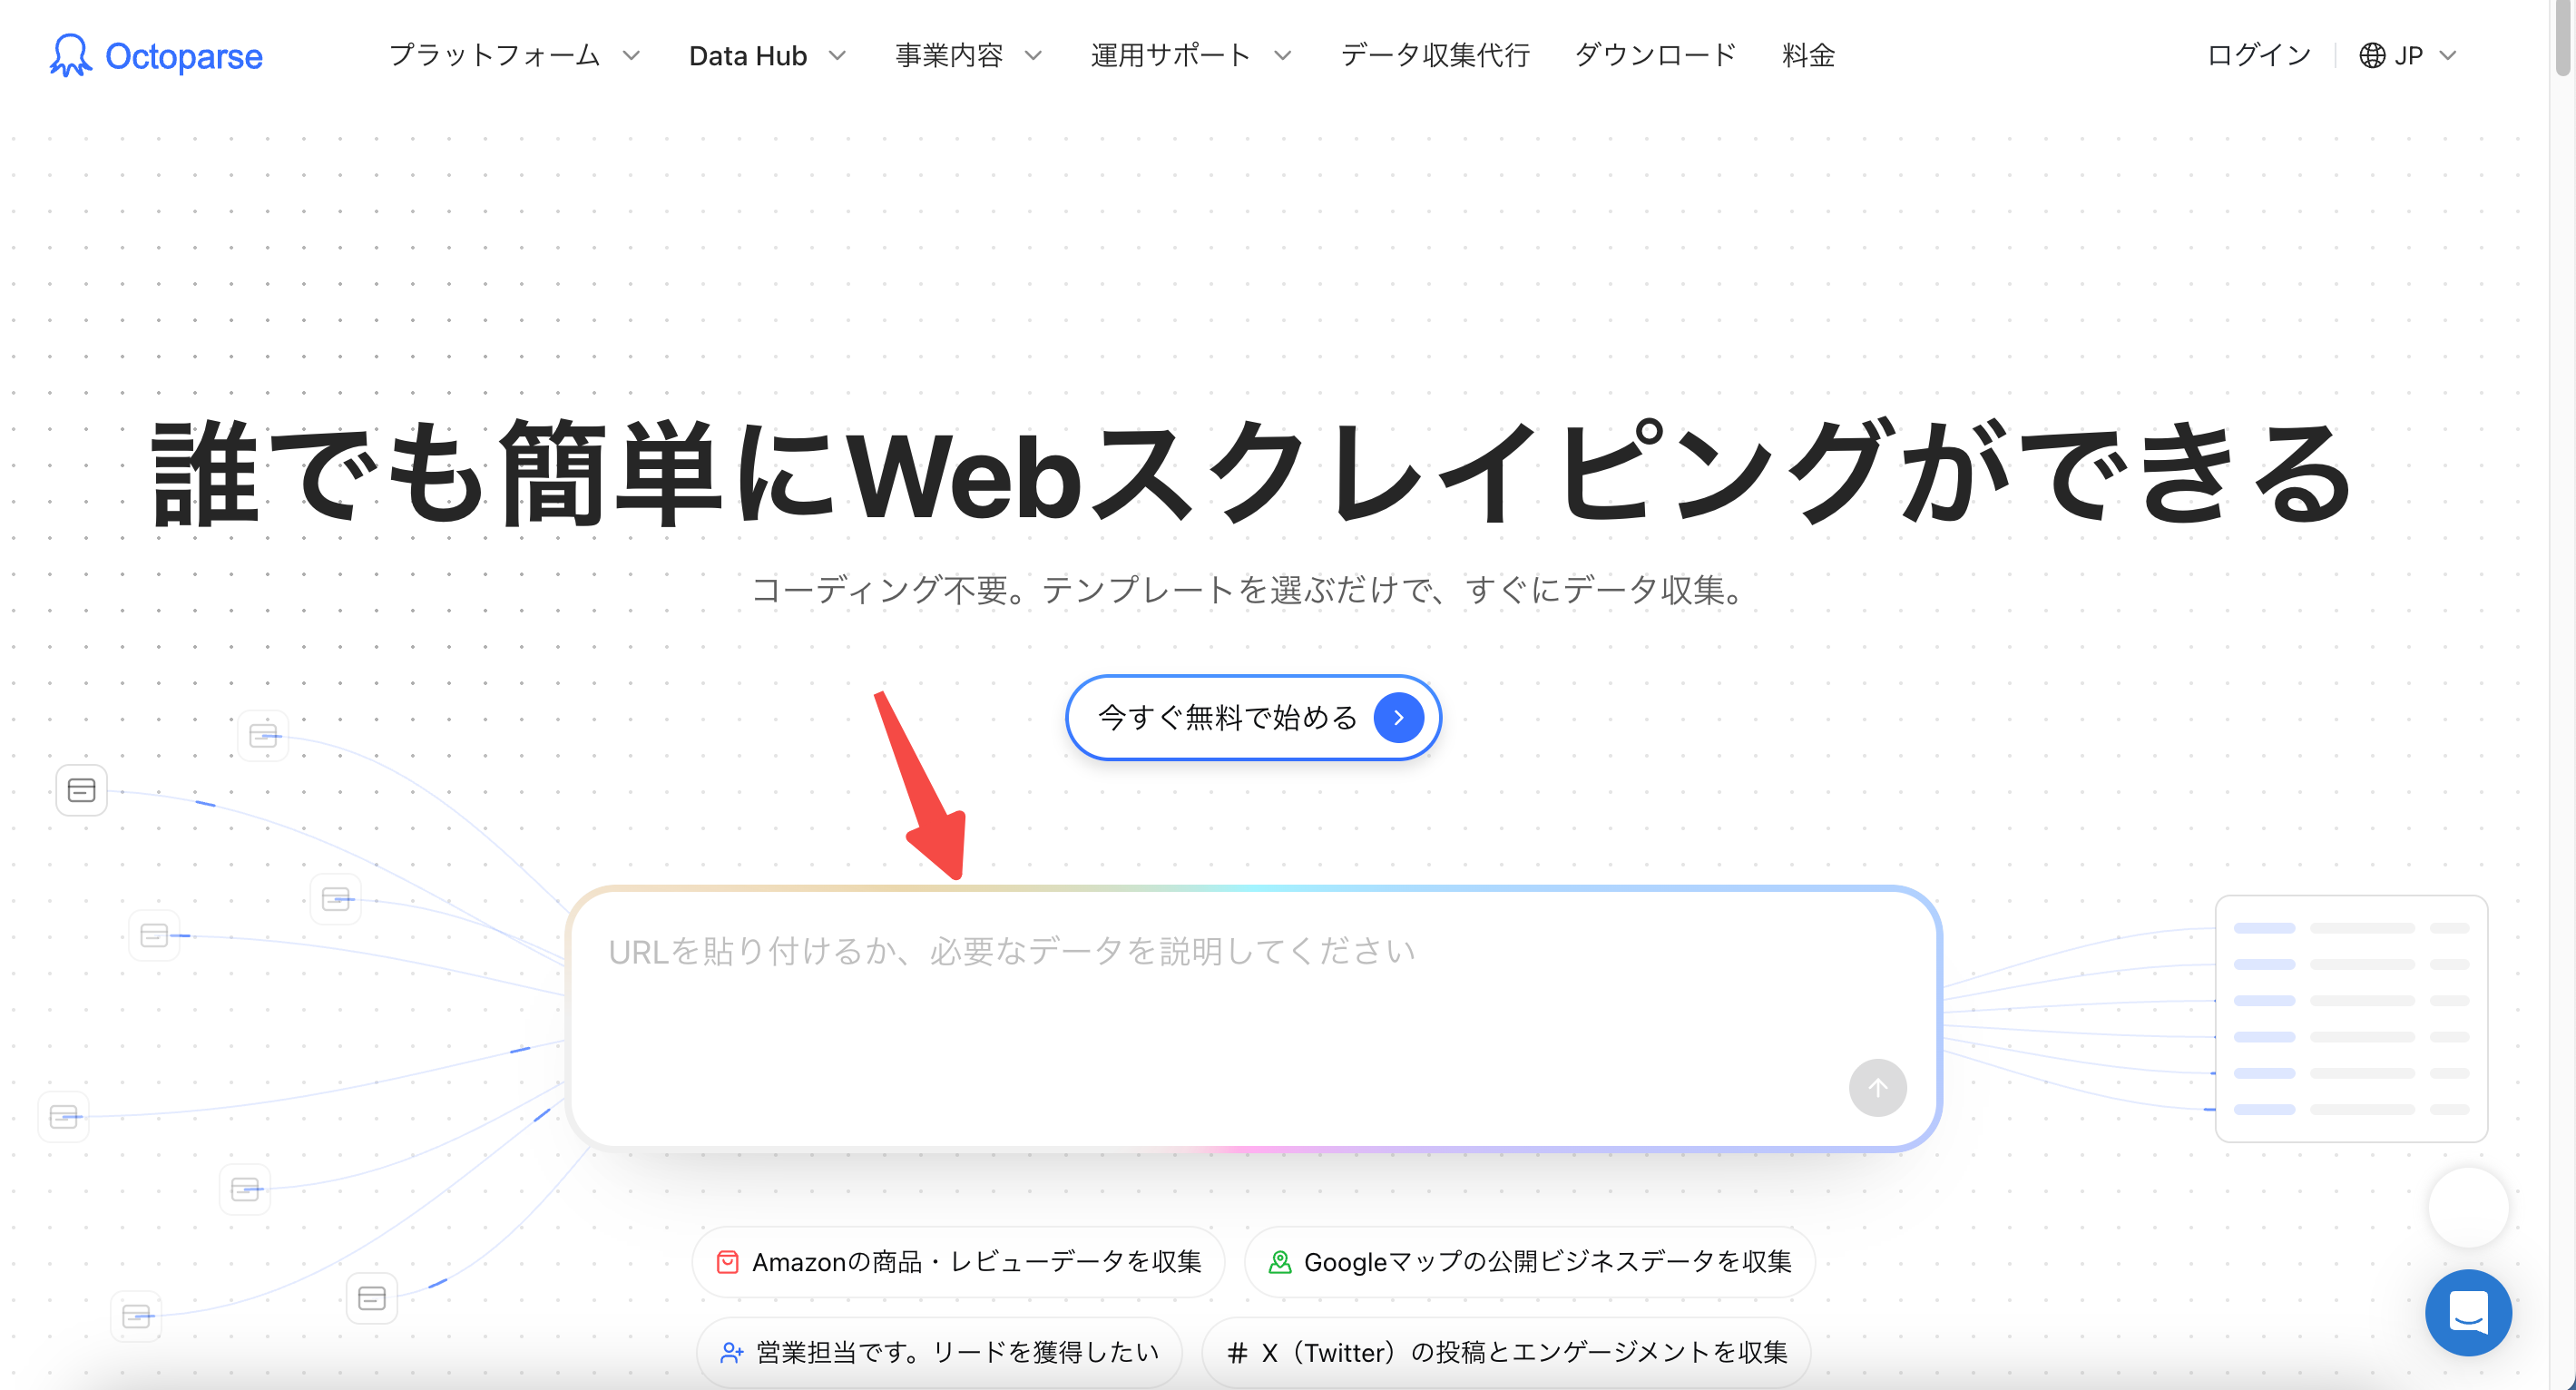
Step2:AIアシスタントを開く
octoparse.jp/console/task/agenticにアクセスするか、Octoparseのホームページにあるチャット欄にリクエストを入力します。
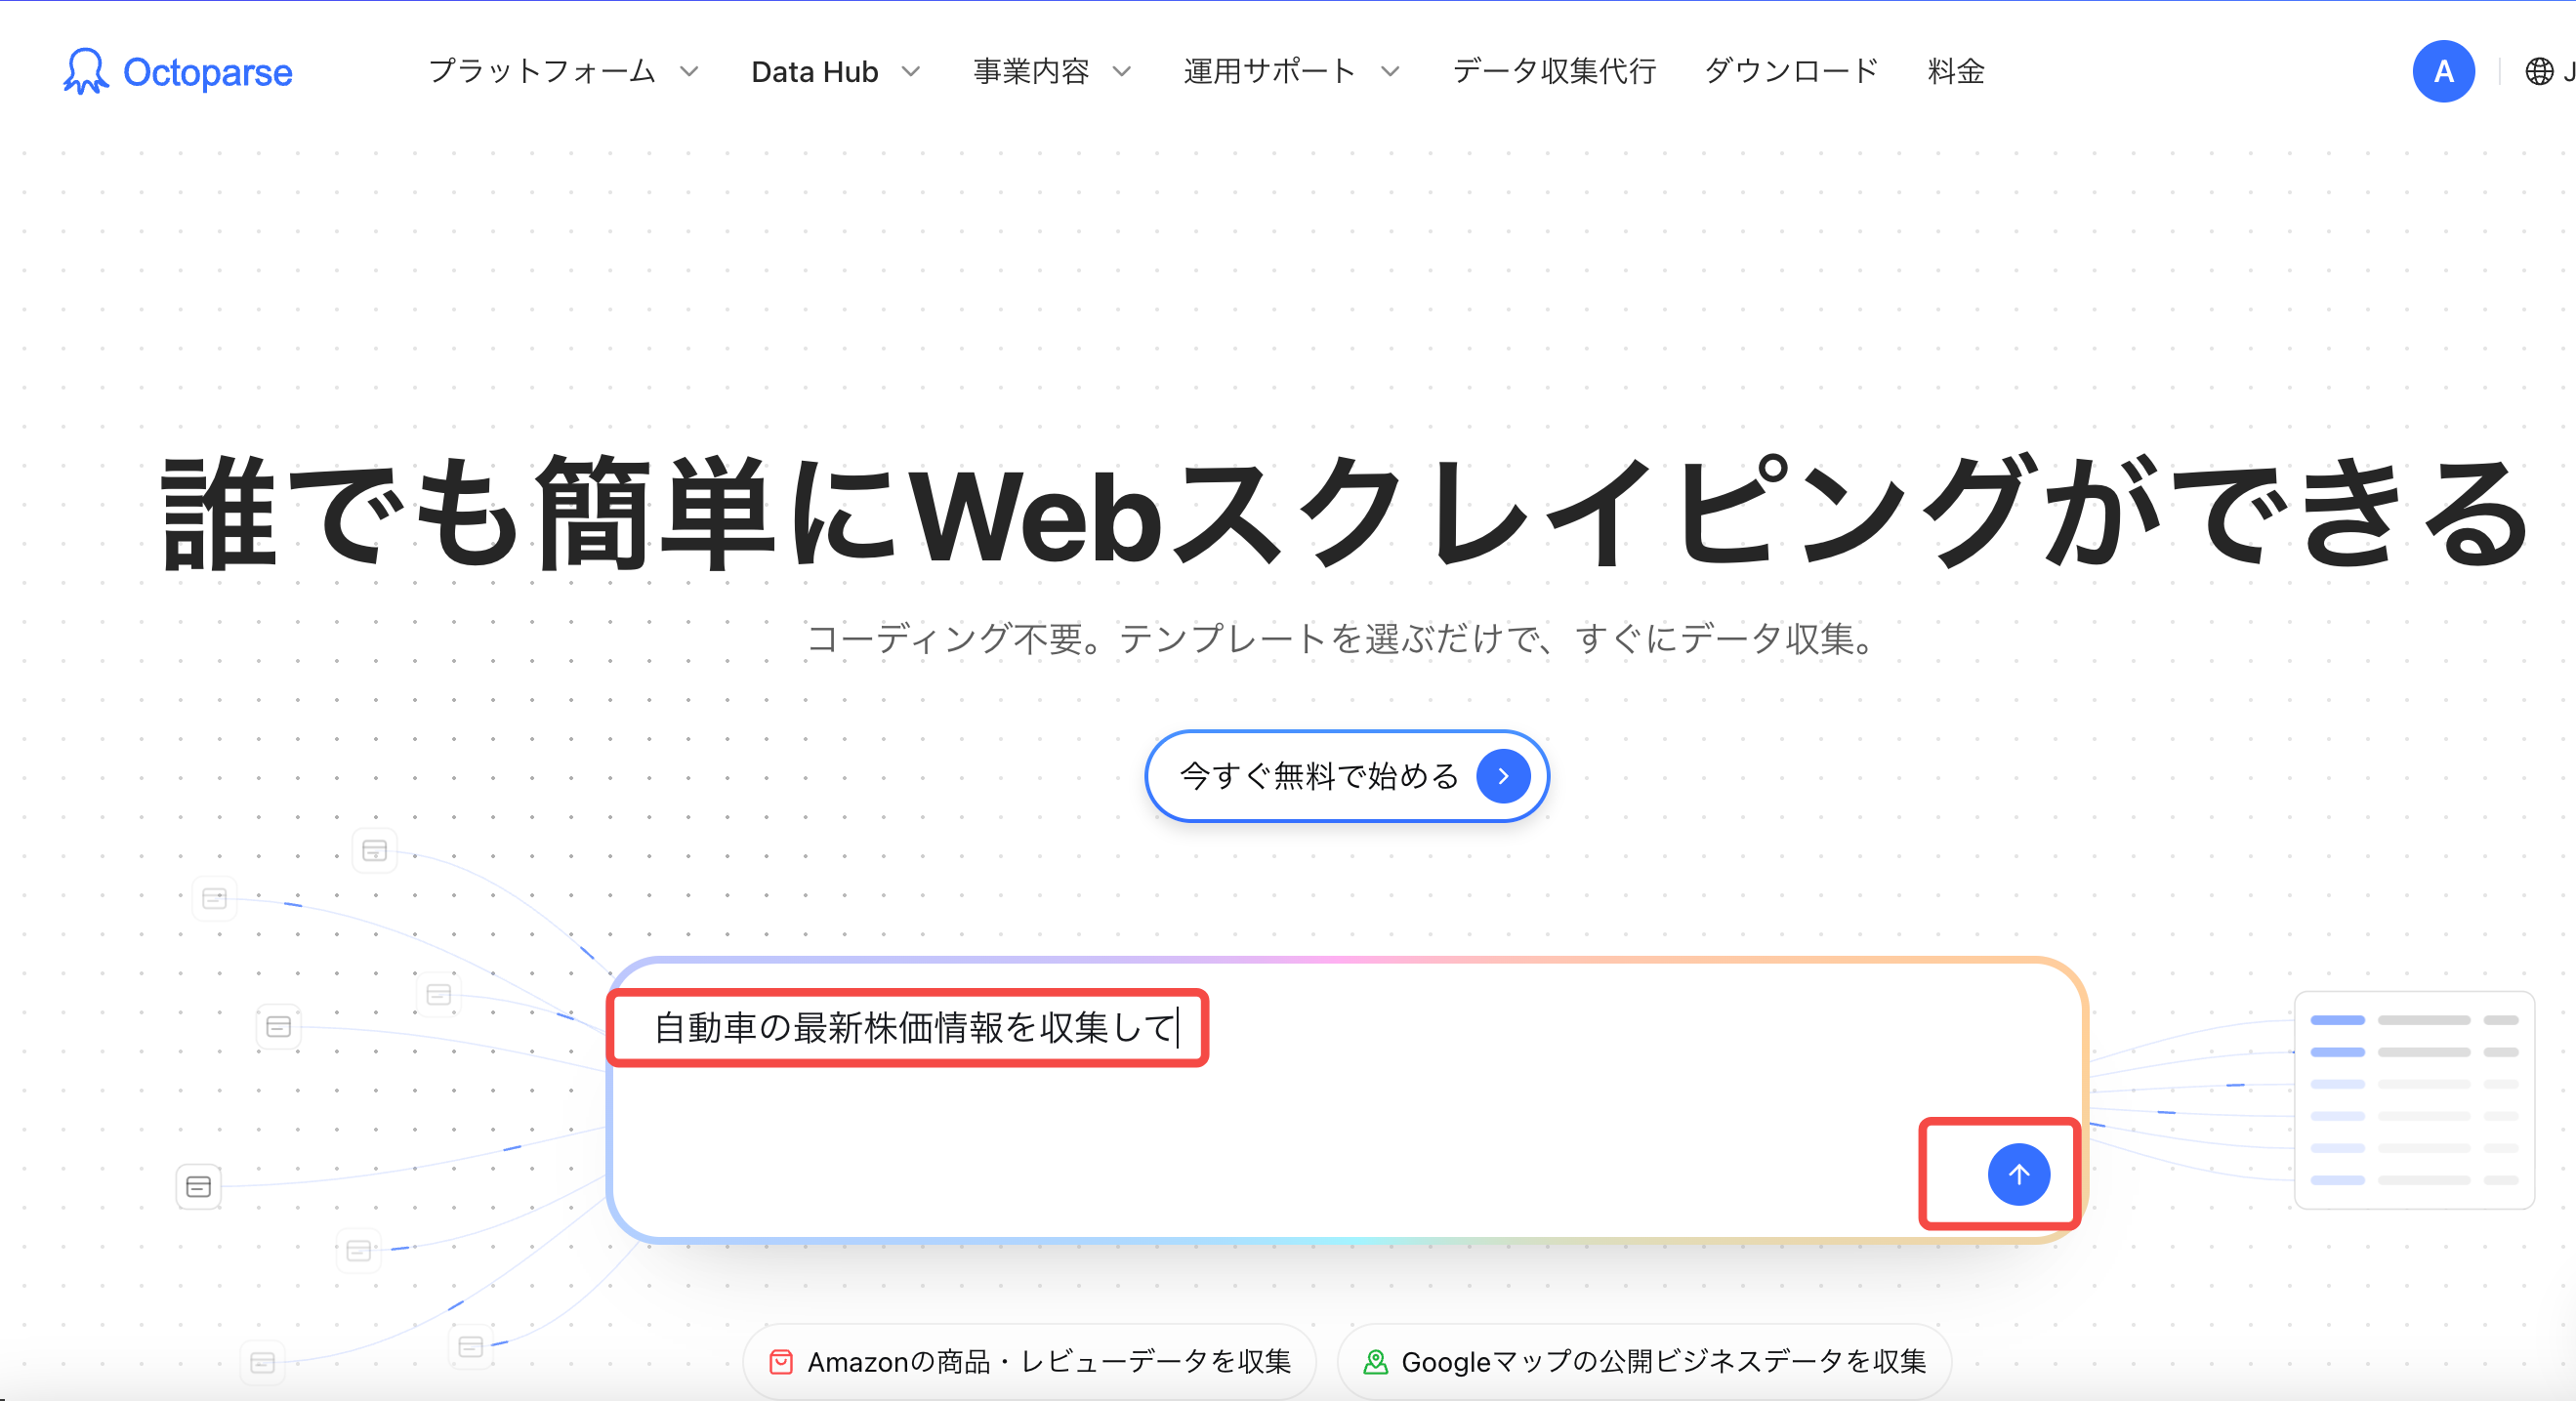
Step3:取得したいデータを伝える
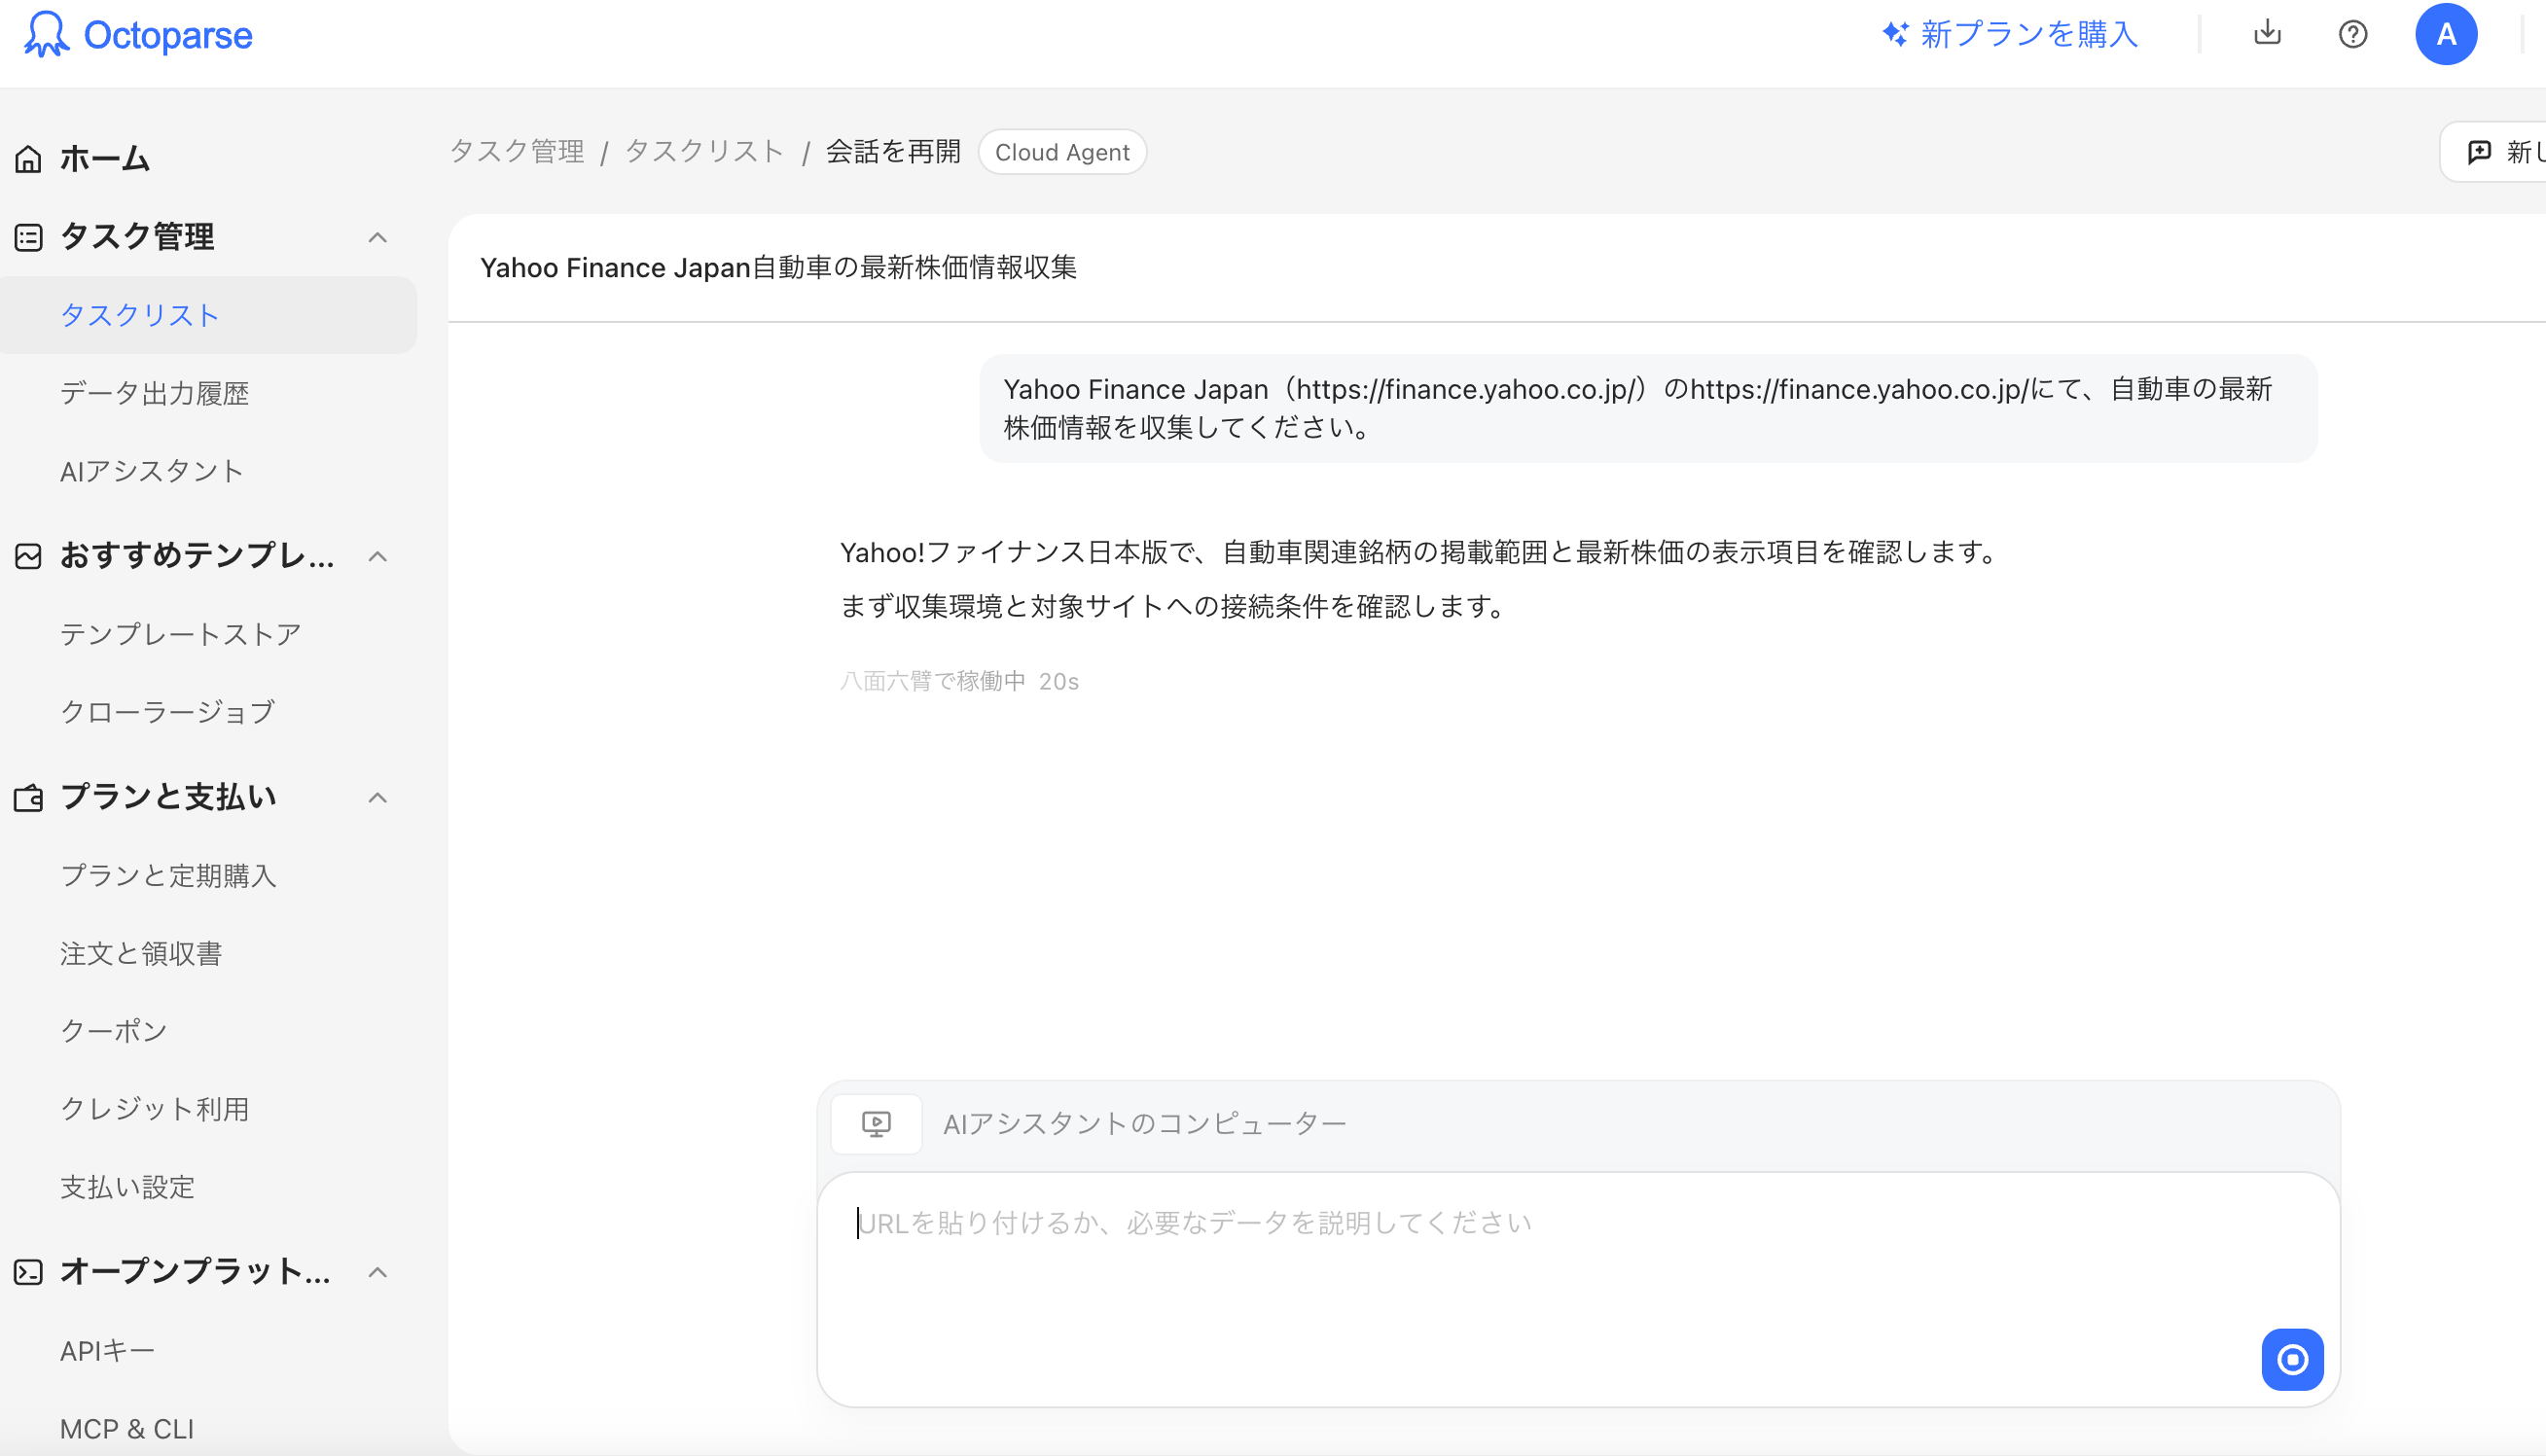
対象サイト、必要なフィールド、フィルターを、好きな言語で普段どおりに伝えます。URLを貼り付けても構いません。ここでは、「自動車の最新株価情報を収集して」を入力した。
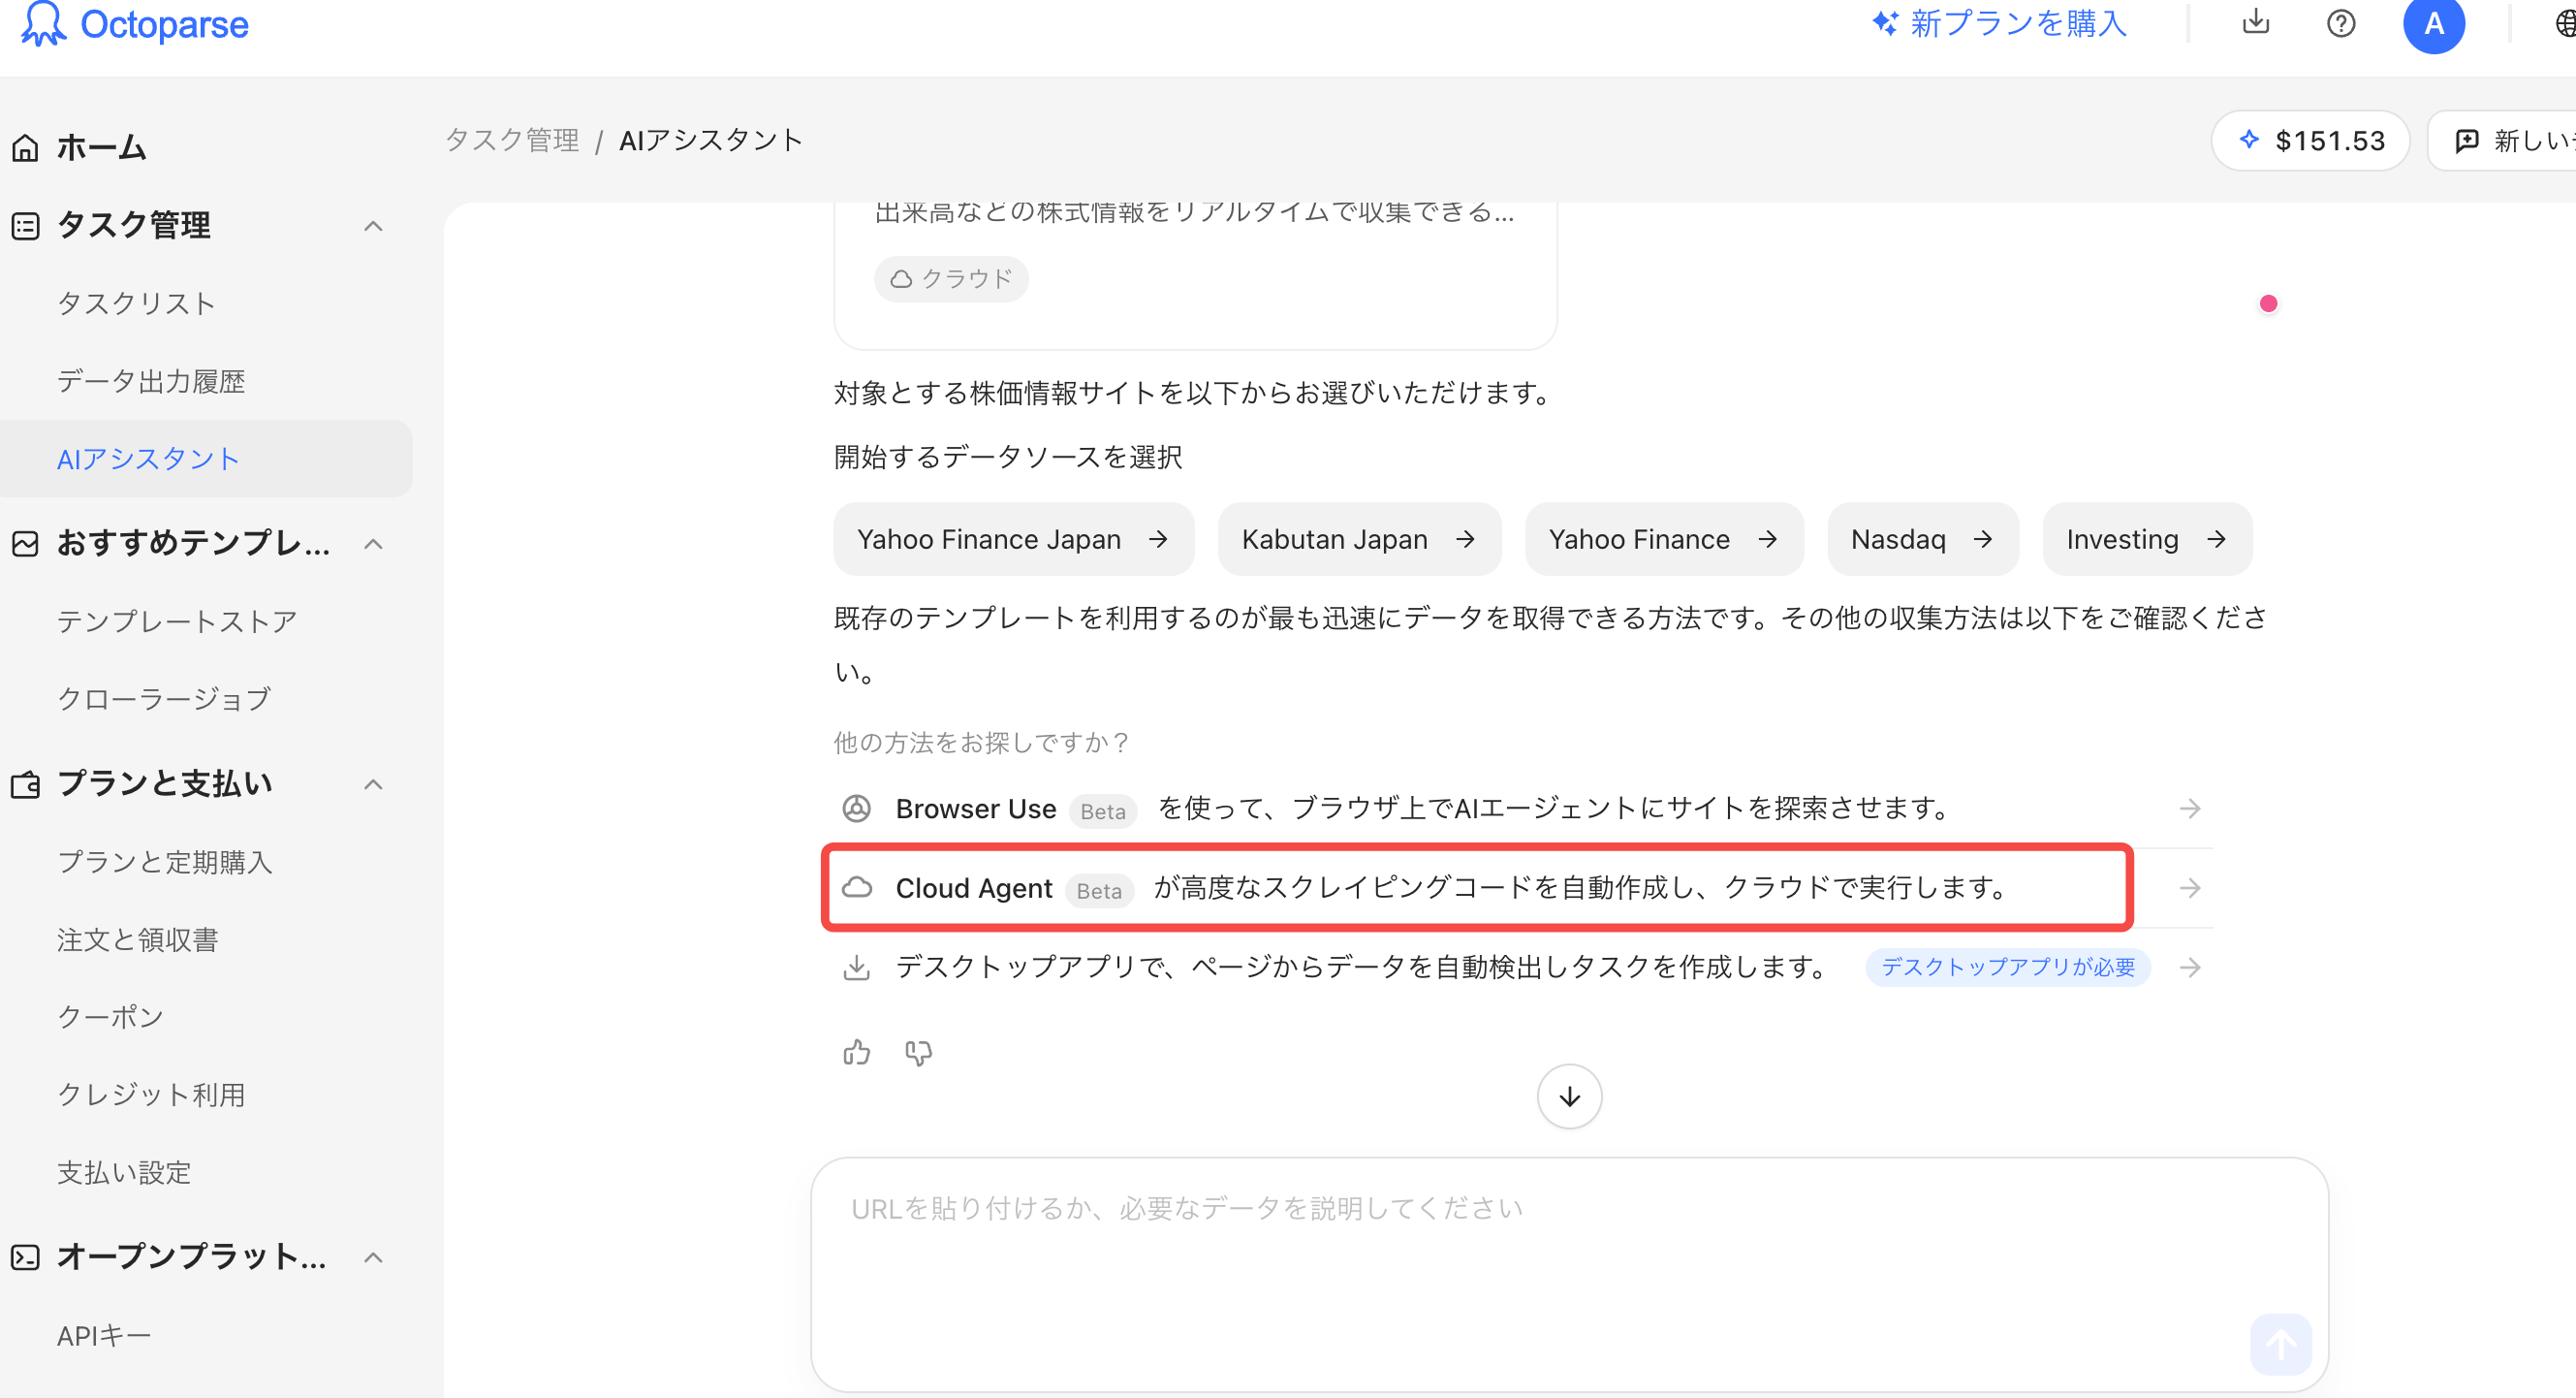
Step4:AIアシスタントが理解した内容を確認する
AIアシスタントは 「理解した要件」に、サイト、目的、制約条件としてリクエストをまとめます。内容が違う場合は、「編集」 を選択して修正し、「保存」 を選択します。
また、AIがユーザーのニーズに応じて利用できる収集方法を提案します。ここでは、テンプレート、Browser Use、Cloud Agent、自動検出などいずれも利用できるので、例としてCloud Agentを選択した。
Step5:タスクを作成・実行する
AIアシスタントは選択された方法でタスクを作成し、実行します。
Step6:取得したデータの確認・エクスポート
AIがタスクの実行が完了したら、「タスクを表示」をクリックし、データの確認とエクスポートを進められます。もし今後も定期的にデータを収集した場合は、定期実行も設定できます。ただし、定期実行の設定はスタンダードプラン以上で利用できます。
APIとMCPで、取得したデータを業務へ渡す
大量のWebデータを継続的に収集する場合、重要なのは取得することだけでなく、集めたデータを毎回手作業で整理せず、業務システムへ効率よく連携できることです。
Octoparseは、APIとMCP Serverの両方に対応し、既存のデータ分析環境やAIワークフローにWebデータ収集機能を組み込めます。
- OpenAPIでデータ収集を業務システムに統合:Octoparse APIを使えば、対応するテンプレートや既存タスクをプログラムから実行し、取得結果をJSON・CSV形式で取得できます。商品価格や求人情報などを定期的に収集し、データベースやBIツールへ自動連携する仕組みを構築できます。
- MCP ServerでAIエージェントから直接データ収集:Octoparse MCP Serverを使えば、ChatGPT、Claude、CursorなどのAIツールから自然言語で収集を依頼できます。対応するテンプレートの検索・実行から結果取得までをAIワークフローに組み込み、市場調査や競合分析に活用できます。
例えば、複数のECサイトから商品価格を毎日収集し、API経由で自社の価格分析システムへ取り込めば、手動でのデータ更新を減らし、継続的な価格モニタリングを実現できます。
大量データの収集・実行はOctoparse Cloudに任せ、取得後の保存・分析・業務活用は自社システムやAIに接続する。 この役割分担によって、大規模なデータ収集ワークフローの構築・運用負担を軽減できます。
Apify:ActorとAPIを組み合わせて運用したいチーム向け
Apifyは、既存のActorを利用したり、自作の処理を実行したりするプラットフォームです。公式のRequest queueの説明では、待ちURLの管理や既出URLの識別を扱っています。URLが増えるクロールを設計し、結果をAPI経由でシステムへ渡したいチームに向きます。
利点は、目的に合うActorを見つければ開発量を減らせることです。一方、Actorごとに入力・出力・保守担当・課金条件が異なります。Actorの公式料金モデルを確認し、結果単位の料金と基盤利用料がどう計算されるかを見ます。既成Actorの利用に必ずコードが必要というわけではありませんが、複雑なデータ統合には実装が必要になる場合があります。
Scrapy:収集処理をコードで管理したいチーム向け
ScrapyはPythonのクローリングフレームワークです。項目の抽出、URLの追跡、保存処理を自分たちで管理したい場合に向きます。AutoThrottleは応答遅延をもとにアクセス間隔を調整し、JOBDIRを使う状態保存は正常な停止後の再開に利用できます。
利点は、独自のデータ処理や運用ルールを実装できることです。反面、サーバー、依存関係、ログ、監視、サイト変更への対応は自社の仕事になります。JavaScriptを実行するページでは追加の仕組みも検討します。ソフトウェアの利用料だけでなく、保守できる担当者の時間を見込む必要があります。
ScraperAPI:既存の収集コードへ取得基盤を追加する
ScraperAPIは、URLへのリクエスト処理を外部基盤へ任せたい開発者の候補です。非同期APIの一括リクエストでは、複数URLを配列で投入できます。ジョブ管理の公式仕様に従い、実行状態と結果を取得する処理を設計します。
利点は、既存の取得コードを活かしながらリクエスト基盤を補えることです。ただし、汎用のHTML取得を使う場合、商品名などの解析、フィールドの検証、重複排除、保存は別途必要です。返却結果の保持条件もあるため、投入しただけで運用完了とせず、結果を確実に回収する仕組みまで作ります。
大量収集で失敗を増やさないための運用設計
URLを分割し、同時実行数と待機時間を調整する
入力URLを地域・カテゴリ・日付などで分割し、バッチごとに実行IDを付けます。分割は処理の管理と再取得を容易にするための方法で、サイト側の表示制限を回避して全件を取得できる保証ではありません。条件の重複や取得漏れも確認します。
同時実行数は、契約上の上限まで増やせばよいわけではありません。まず少量で所要時間とエラーを測り、対象サイトへのアクセス頻度を抑えながら調整します。429などの制限応答が増えた場合は、回数を増やして押し切らず、案内された待機条件や取得方法を見直します。
失敗した範囲を記録し、必要な部分だけ再取得する
再取得の単位をURLまたはバッチとして残します。失敗したURLだけを再送できるか、サブタスク全体の再実行になるかは製品とタスクで異なります。前回の成功データと追加取得の結果を統合するときは、同じ商品を重ねて登録しない仕組みが必要です。
価格履歴を残すなら「商品ID+店舗ID+観測時点」、最新リストを更新するなら「商品ID+店舗ID」など、保存目的に合うキーを決めます。価格監視で日付を無視して重複排除すると、必要な履歴まで消す場合があります。
終了ステータスではなく、データの中身で合否を決める
タスクが完了しても、最終ページに到達していない、価格だけ空欄、前回データの再取得といった問題は残り得ます。「何件なら合格か」「どの列が必須か」「取得時刻はいつか」を先に定義してください。症状別の確認には、欠損・重複・ページ送りのトラブル診断が役立ちます。
| 記録するもの | 確認方法 | 大量収集での意味 |
|---|---|---|
| 取得範囲と実際のURL | 入力一覧と処理結果を照合 | 行数が多くても、特定範囲が抜けていないか確認 |
| 一意キーと取得時刻 | ID・URL・店舗・観測日時を保存 | 最新リストと時系列の履歴を区別 |
| 必須項目の欠損率 | 必須列が空の行数÷対象行数 | 任意項目の空欄と抽出失敗を区別 |
| 重複と期待範囲 | 業務上のキーで照合 | 再実行や検索条件重複による水増しを防ぐ |
| 所要時間と失敗範囲 | 実行IDごとに開始・終了・失敗URLを記録 | 次回実行までに完了するか、不足分を取得できるか確認 |
規約・権利・個人情報・アクセス負荷を確認する
データ源の公式API、公開データ、ダウンロードで目的を満たせるかを先に確認します。Webページを取得する場合も、利用規約、robots.txt、認証・閲覧権限、著作権、利用目的を確認し、アクセス頻度と保存期間を決めてください。robots.txtだけで法的な可否が決まるわけではありません。
公開されている個人情報も保護の対象です。個人情報保護委員会の公式FAQを踏まえ、必要な項目だけを取得し、利用目的、管理責任、共有範囲を整理します。反屏蔽機能はアクセス権を付与するものではありません。制限が続くときは取得頻度を下げ、対象サイトや社内担当部門へ確認します。
料金は「利用できるデータ」を基準に比較する
行数、APIリクエスト、クレジット、計算時間は同じ単位ではありません。比較するときは、同じ対象範囲・必須項目・更新頻度を定め、必要なデータを届ける総費用へ換算します。料金が発生する失敗リクエストや再試行、結果を読み出す費用の扱いも確認してください。
月間総費用=契約・利用料+追加の取得資源+保存・連携費+設定・監視・修正の人件費として整理すると、月額料金だけでは見えない差を確認できます。「利用可能な1,000行当たり費用」を計算する場合も、同じ必須項目と重複・欠損の基準を満たすデータ同士で比べます。
Octoparseも、実行方式、利用プラン、テンプレート、追加機能に応じて費用を確認します。API/MCPへのアクセスが可能であることと、すべての取得が無制限・追加費用なしであることは別です。継続運用の前に日本向けの料金ページと実際のタスク画面で、クラウド実行、同時実行、出力、追加課金の条件を確認してください。
小さく検証してから収集範囲を広げる
まず一覧・詳細・最終ページ・欠損のあるページを含むサンプルを選び、同じ条件で複数回試します。その後、対象範囲を段階的に広げ、実行時間と品質が許容範囲に収まるかを確認します。以下は本記事で提案する検証記録のひな形です。実測結果や業界共通の合格基準ではありません。
| 検証項目 | 記入内容 | 判定すること |
|---|---|---|
| 入力条件 | 対象URL、検索条件、日時、テンプレート/タスクID | 同じ条件を再現できるか |
| 実行条件 | バッチID、実行方式、ページ範囲、同時実行設定 | 失敗した範囲を特定できるか |
| 出力 | 総行数、キーで照合した一意行数、必須列の欠損 | 件数だけでなく業務に使えるか |
| 再取得 | 失敗URL、再実行範囲、重複処理、回収結果 | 全体を最初から取り直さず復旧できるか |
| 運用 | 完了時刻、費用、通知先、修正担当者 | 次回の収集までに届けられるか |
例えばECの価格監視では、商品名と価格に加え、商品ID、店舗、送料、取得時刻を揃え、同一条件の商品を比較します。求人動向なら求人URL・企業・地域・掲載日を整理し、同じ求人の再掲載を区別します。企業情報の更新では所在地や業種を確認し、個人情報の必要性は別途判断します。どの業務も「多く取得する」前に、更新単位と比較キーを決めることが重要です。
大量データのスクレイピングに関するFAQ
Q. 何件から「大量データ」と考えればよいですか?
共通の境界はありません。行数に加え、取得ページ数、詳細ページの処理、更新頻度、納期で判断します。同じ1万行でも、一覧だけの場合と詳細ページまで開く場合では負荷が異なります。
Q. 無料プランで大量データを取得できますか?
無料プランでもデータ収集を試せますが、大量データの継続的な収集には有料プランがおすすめです。
Octoparseのテンプレート、AIアシスタント(Browser Use・Cloud Agent)、API・MCP経由の収集には、プランごとに次の行数制限があります。
- Free:月間2,000行まで(1回最大100行)
- Basic:月間10,000行まで(1回の行数制限なし)
- Standard以上:月間行数の上限なし。クラウドでの定期実行にも対応
なお、Octoparse Desktopで作成した独自タスクの収集データは、この月間行数制限の対象外です。ただし、無料プランでは別途データのエクスポート制限があります。また、成果報酬型テンプレートやプロキシなどは、プランや使用量に応じて追加料金が発生する場合があります。
Q. 同時実行数を増やせば速くなりますか?
はい。複数のタスクやサブタスクを並列実行できれば、大量データの収集時間を短縮できる場合があります。 Octoparse Cloudでは、分割可能なタスクを複数のクラウドサーバーで同時に処理できます。
ただし、すべてのタスクが分割できるわけではありません。実際の速度は対象サイトの応答速度やアクセス制限、タスクの設定にも左右されるため、同時実行数を増やせば必ず速くなるとは限りません。
Q. データ収集が途中で止まった場合、最初からやり直す必要がありますか?
必ずしも最初からやり直す必要はありません。Octoparse Cloudでは、タスクの実行履歴やエラーログを確認し、失敗したサブタスクを再実行できます。
ただし、停止した位置から必ず再開できるわけではありません。再実行後はデータの重複や欠損を確認し、必要に応じて収集条件を調整することが重要です。
Q. AI アシスタント、API、MCPはどう使い分けますか?
Octoparseでは、目的に応じて次のように使い分けられます。
- AI アシスタント:自然言語で欲しいデータを伝え、AIによるテンプレート提案やスクレイパーの作成・実行を利用したい場合。
- OpenAPI:既成テンプレートや構築済みタスクをプログラムから実行し、取得データを自社のデータベースや業務システムに連携したい場合。
- MCP Server:ChatGPTやClaudeなどの対応AIツールから、Octoparseのデータ収集機能を呼び出し、AIワークフローに組み込みたい場合。
大量データの継続収集にはOctoparse Cloud、業務システムとの自動連携にはAPI、AIエージェントとの連携にはMCPが適しています。
必要なデータを継続して届けられる方法を選ぶ
大量データの安定収集では、取得・再取得・品質確認・保存までを一つの運用として考えます。業務チームがテンプレートとAI アシスタントから始め、継続実行とAPI/MCP連携へ進むならOctoparseが候補です。Actorを利用するならApify、コード制御を優先するならScrapy、既存コードの取得基盤を補うならScraperAPIを比較してください。公式APIで要件を満たせる場合は、その条件を先に評価します。
最初の一歩は、本番と同じ項目・範囲の小さなサンプルを選び、元ページと出力を照合することです。合格条件を満たした収集方法を、運用担当者と復旧手順を決めてから広げましょう。