スクレイピングできないときは、エラーコードだけでなく、読み込み、ページ構造、認証、アクセス頻度、データ品質を順番に切り分けます。動的コンテンツ、ログイン、CAPTCHA、アクセス制限、運用監視、利用規約など、技術面と運用面の両方を確認する必要があります。
この記事では、実務で起こりやすい10の課題を「症状・主な原因・最初に確認すること」の順に整理します。アクセス制限だけを詳しく調べたい場合は「スクレイピングでブロックされる原因と対策」をご覧ください。
まず確認:そのWebサイトを収集してよいか
技術的な設定より先に、対象サイトの利用規約、robots.txt、公式APIやデータ提供手段の有無を確認します。ログインが必要なページ、個人情報、著作権で保護されたコンテンツを扱う場合は、権限と利用目的も明確にしてください。
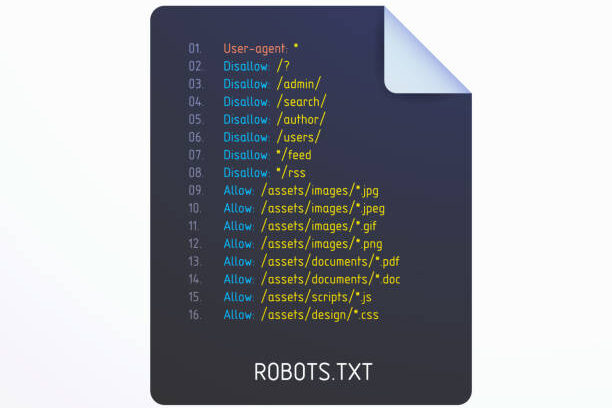
robots.txtはクローラーへの指示を示す仕組みですが、それだけで法的な可否が決まるわけではありません。明確な禁止条項がある、取得許可が不明、サーバーへ大きな負荷がかかるといった場合は、収集を始めず、サイト運営者への確認や公式APIの利用を優先しましょう。
関連記事:スクレイピングできないサイト・注意が必要なサイトの見分け方
Webスクレイピングの課題を症状から切り分ける
| 症状 | 主な原因 | 最初に確認すること |
|---|---|---|
| 画面にはあるのに取得結果が空 | JavaScript・Ajaxの読み込み待ち不足 | 要素が表示される条件と待機時間 |
| 昨日まで取れていた項目が欠ける | HTML構造やセレクターの変更 | 失敗ページのHTMLと取得件数 |
| 最初のページしか取れない | ページ送り・無限スクロールの設定不足 | 次ページの発生条件と終了条件 |
| ログイン画面へ戻る | Cookieやセッションの失効 | 認証方法、有効期限、権限 |
| CAPTCHAが表示される | ボット対策、過剰アクセス、認証要求 | 取得可否とアクセス頻度 |
| 403・429で停止する | アクセス拒否・レート制限 | 利用規約、頻度、同時実行数 |
| 重複・空欄・形式違いが多い | 抽出範囲やデータ定義の不一致 | 1行の単位、必須項目、識別キー |
| 件数を増やすと終わらない | 対象範囲、処理時間、リソースの問題 | 1ページ当たり時間と総ページ数 |
| 定期実行が気付かず失敗する | 監視・通知・変更管理の不足 | 成功条件と異常検知ルール |
| 社内で利用判断ができない | 目的・権限・保存ルールが未定義 | 責任者、利用目的、保存期間 |
課題1.動的コンテンツが読み込まれない
商品一覧、地図、口コミ、検索結果などは、最初のHTMLではなく、JavaScriptやAjaxによって後から表示される場合があります。ブラウザには表示されるのに抽出結果が空なら、要素の読み込みが完了する前に取得している可能性があります。
- 対象要素が表示されるまで待機する
- クリック後・スクロール後の待機時間を調整する
- Ajaxの完了条件とタイムアウトを確認する
- 同じページを複数回実行し、読み込み時間のばらつきを確認する
Octoparseヘルプセンター「Ajax読み込み」では、Ajaxを使うページの判定方法とタイムアウト設定を確認できます。
課題2.ページ構造の変更で抽出項目がずれる
サイトのデザイン変更、A/Bテスト、広告枠の挿入によって、同じ項目でもHTML上の位置や属性が変わることがあります。1件だけ見て設定すると、別カテゴリや別ページで欠損しやすくなります。
- 一覧、詳細、在庫切れなど複数パターンでテストする
- 見た目の位置ではなく、項目名や周辺構造を含めて選択範囲を確認する
- 必須項目の空欄率と取得件数を毎回記録する
- 構造変更時にどの担当者がタスクを修正するか決める
課題3.ページネーションや無限スクロールが途中で止まる
「次へ」ボタン、ページ番号、「もっと見る」、無限スクロールでは、それぞれ繰り返し条件が異なります。終了条件が曖昧だと、最初のページだけで終わる、同じページを繰り返す、必要以上にアクセスするといった問題が起こります。
- 次ページへ進んだことをURLや先頭レコードで確認する
- 最大ページ数または終了条件を設定する
- 読み込み前後の待機を入れる
- 重複判定に使える商品IDや詳細URLを取得する
設定例はページネーションの処理(無限スクロール)を参照してください。
課題4.ログイン状態を維持できない
会員ページでは、Cookieやセッションの期限切れ、二要素認証、権限不足により、実行途中でログイン画面へ戻ることがあります。まず、そのアカウントで自動収集してよいか、取得対象に必要な権限があるかを確認します。
Octoparse(オクトパース・オクトパス)では、許可された範囲でログイン操作をワークフローに設定したり、Cookieを保存して利用したりできます。ただし、Cookieには有効期限があるため、定期実行では更新手順も運用に含めます。詳しくはWebサイトに自動ログインする方法をご覧ください。
課題5.CAPTCHAが表示される
CAPTCHAは、サイト側が人と自動アクセスを見分けるための仕組みです。表示された場合は、単に突破方法を探すのではなく、取得許可、アクセス頻度、ログイン方法、公式APIの有無を見直してください。
- 短時間の連続アクセスや不要な再試行を止める
- ローカル実行で手動確認が必要な運用かを判断する
- 自動実行が前提なら、サイト運営者の許可や代替データ手段を確認する
- CAPTCHAの回避を保証する表現や設定を前提にしない
課題6.403・429・IPブロックで停止する
403はアクセス拒否、429は一定時間内のリクエストが多すぎるときに返される代表的なステータスです。ただし、同じコードでも原因は一つではありません。まず対象URL、発生時刻、直前の操作、リクエスト間隔、成功件数を記録します。
- アクセス間隔を広げ、同時実行数を減らす
- 不要なページや画像へのアクセスを除外する
- 取得範囲を小さく分け、再試行回数に上限を設ける
- 利用規約やrobots.txtに反していないか再確認する
- プロキシを使う場合も、許可された収集を過剰アクセスにしない
エラー別の切り分けは「スクレイピングのブロック対策」で詳しく解説しています。
課題7.データの欠損・重複・表記ゆれが発生する
抽出に成功しても、そのまま分析に使えるとは限りません。価格に通貨記号が混ざる、日付形式が違う、同じ商品が複数ページに出る、任意項目が空欄になるといった問題があります。
- 「1行が何を表すか」を先に決める
- 必須項目と任意項目を分ける
- 商品ID、詳細URL、施設IDなど一意に近いキーを取得する
- 価格、日付、単位は変換ルールを固定する
- 取得件数、空欄率、重複率を実行ごとに検証する
課題8.大量データの収集に時間がかかる
ページ数を増やす前に、1ページ当たりの処理時間、取得フィールド数、待機、再試行、重複アクセスを測ります。高速化だけを優先すると、相手サイトの負荷やブロックのリスクが上がるため、必要な更新頻度から逆算してください。
Octoparseの対象プランでは、クラウド抽出とスケジュール実行を利用できます。複数タスクを運用する場合は、同時実行数と前回タスクの完了時間を確認します。公式仕様はクラウド抽出とはで確認できます。
課題9.サイト変更や失敗に気付けない
定期実行では「タスクが終了した」だけで成功と判断できません。0件で終了する、特定項目だけ空になる、前回と同じデータを繰り返すこともあります。次の指標を監視対象にします。
- 総取得件数と前回比
- 必須項目の空欄率
- 一意キーの重複率
- HTTPエラーと失敗ページ
- 開始・終了時刻と実行時間
- サンプルレコードの目視確認
変更を検知したら、対象ページのサンプルを保存し、タスクを修正してから小規模に再テストします。修正日、変更理由、確認したURLを残すと、担当者が変わっても復旧しやすくなります。
課題10.コンプライアンスと社内ガバナンスが曖昧
収集できることと、業務で利用してよいことは別です。取得前に、目的、対象、責任者、保存期間、アクセス権、第三者提供の有無を決めます。個人情報や機密情報を扱う場合は、担当部門や専門家にも確認してください。
- 公式API・オープンデータ・提供データを優先する
- 必要な項目と期間だけを取得する
- 利用規約、robots.txt、権利関係を記録する
- サーバー負荷を抑える頻度と時間帯を設定する
- 不要になったデータと資格情報を安全に削除する
Octoparseでタスクを作るときの確認手順
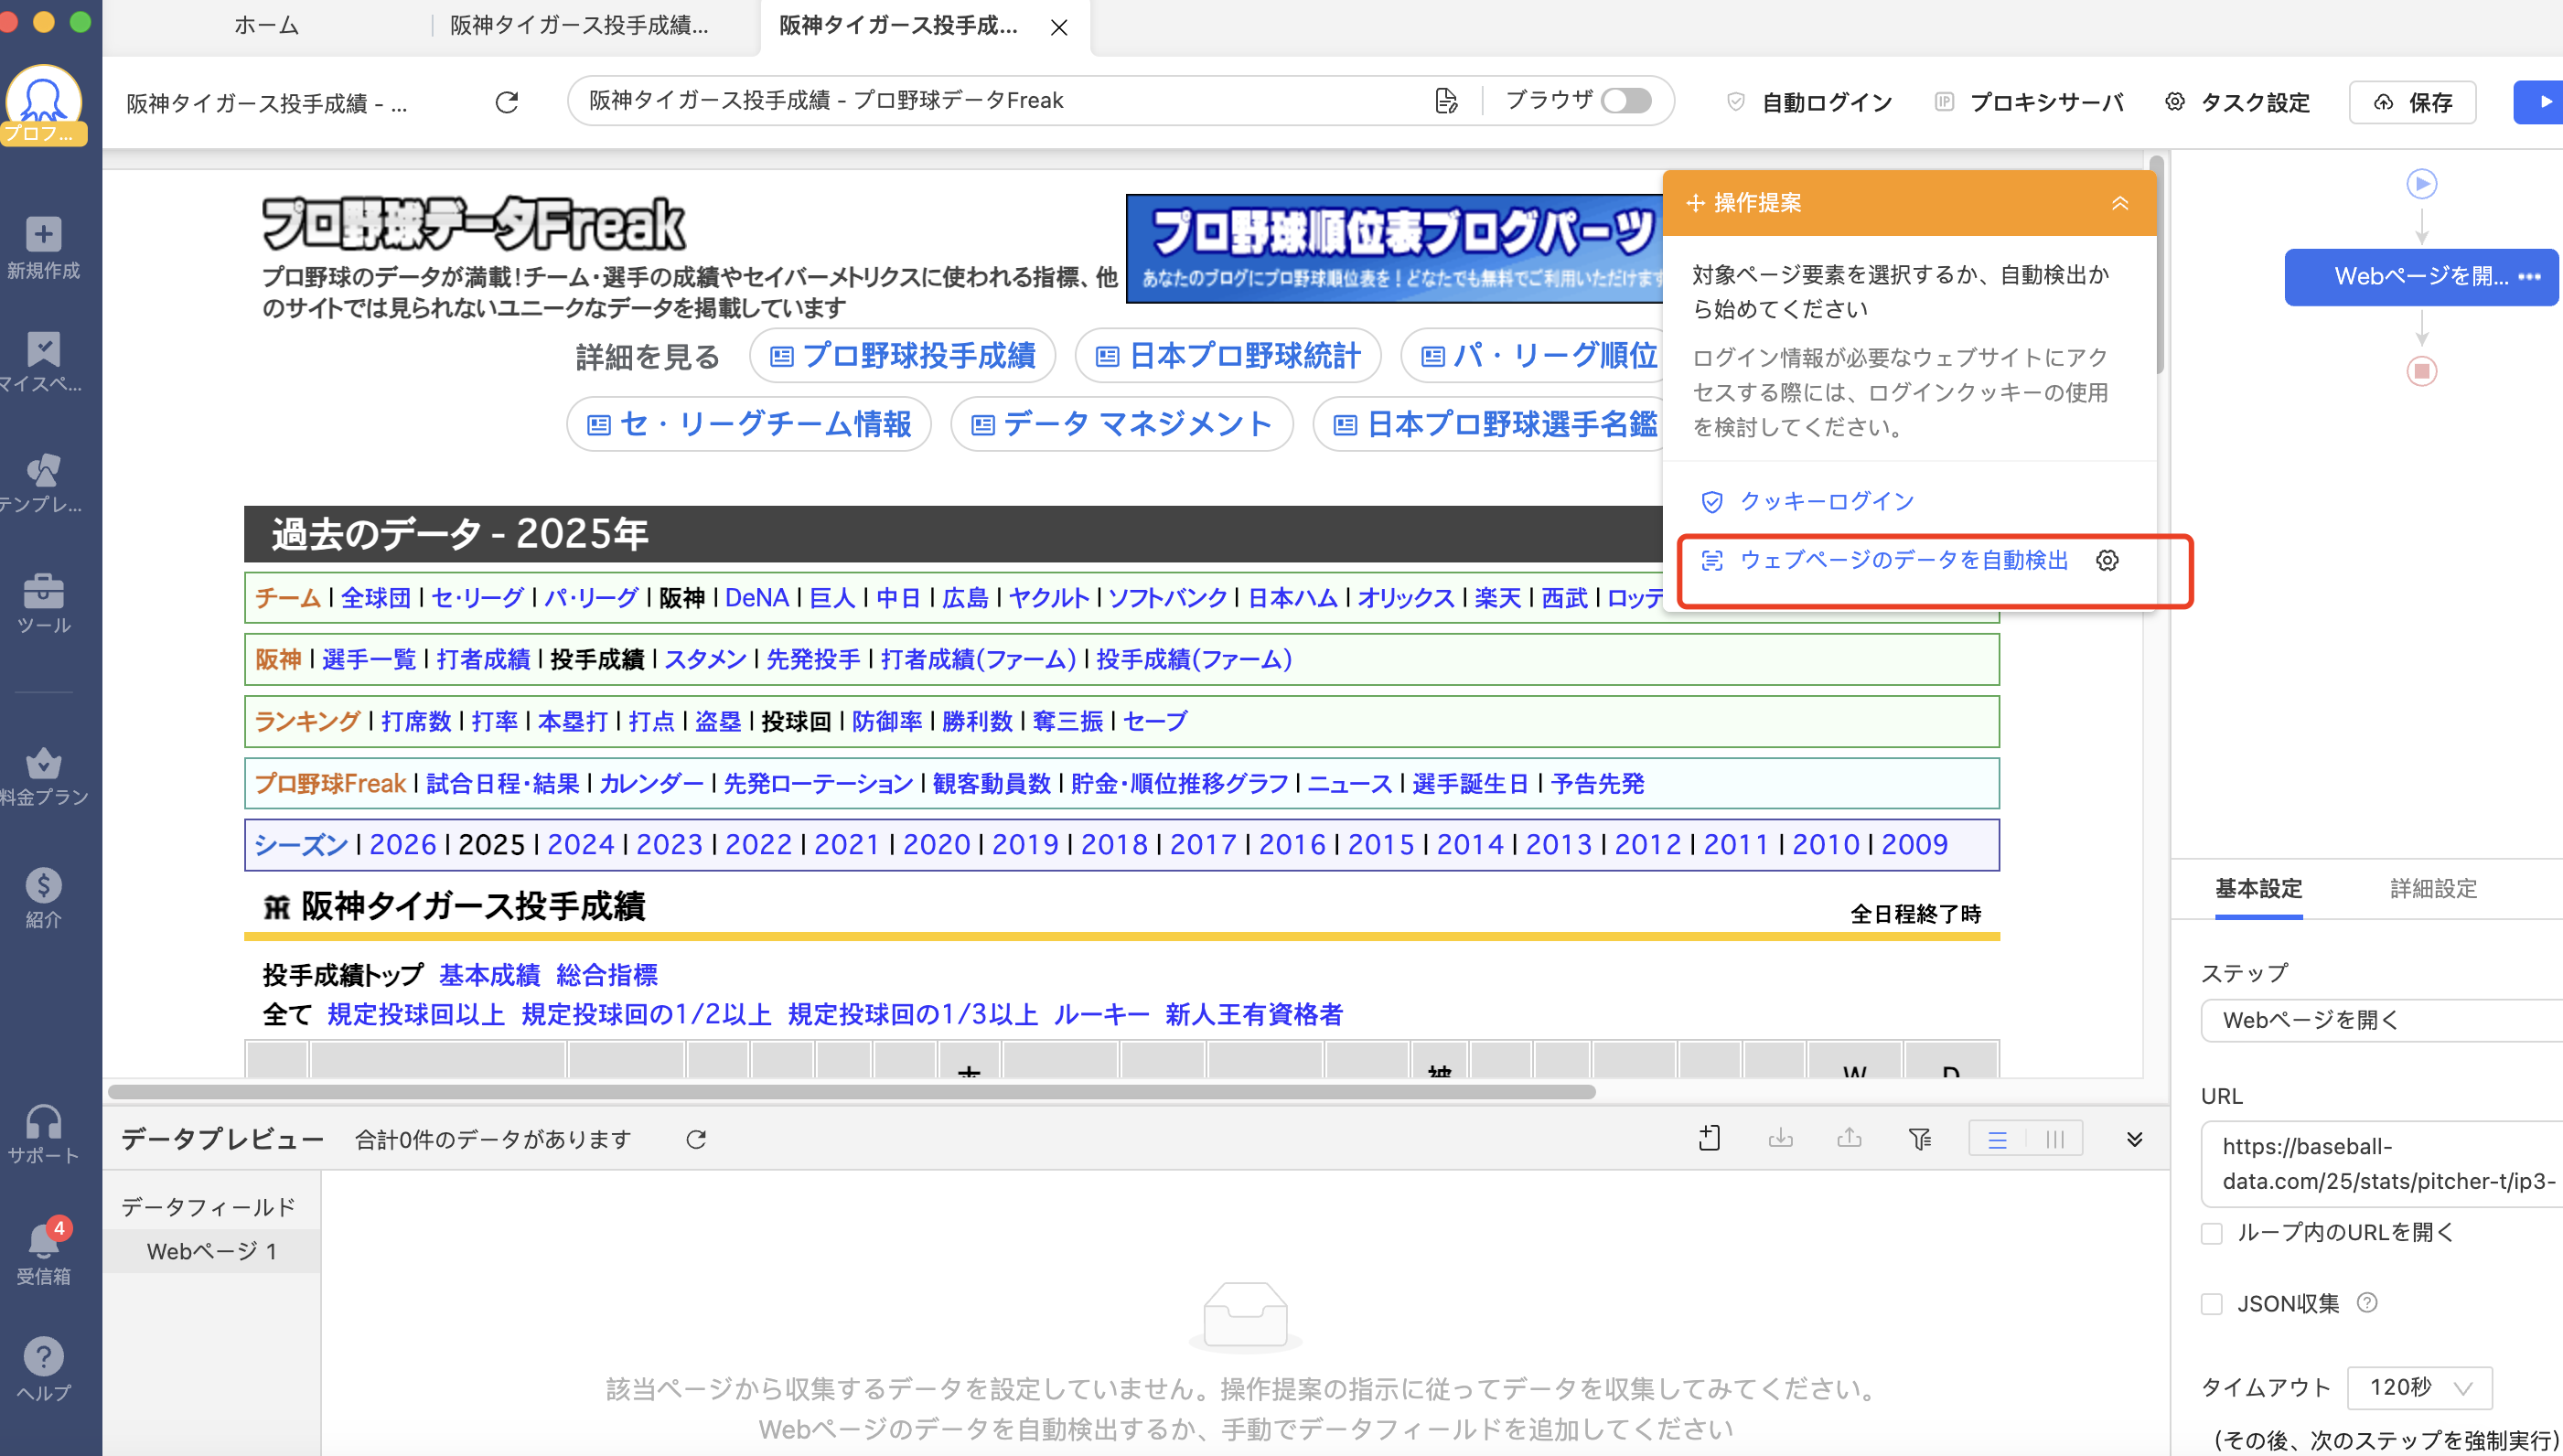
対象ページを開き、操作提案から「ウェブページのデータを自動検出」を選択して取得候補を確認します。
- 取得可否を確認する:利用規約、robots.txt、API、権限を確認する
- 小さなサンプルを選ぶ:一覧・詳細・欠損・最終ページを含める
- 成功条件を決める:件数、必須項目、一意キー、終了条件を定義する
- 動作を調整する:待機、スクロール、ページ送り、ログインを設定する
- 例外を試す:読み込み失敗、空欄、重複、セッション切れを確認する
- 小規模に実行する:結果を原ページと照合してから範囲を広げる
- 監視方法を決める:取得件数とエラーを記録し、修正担当者を決める
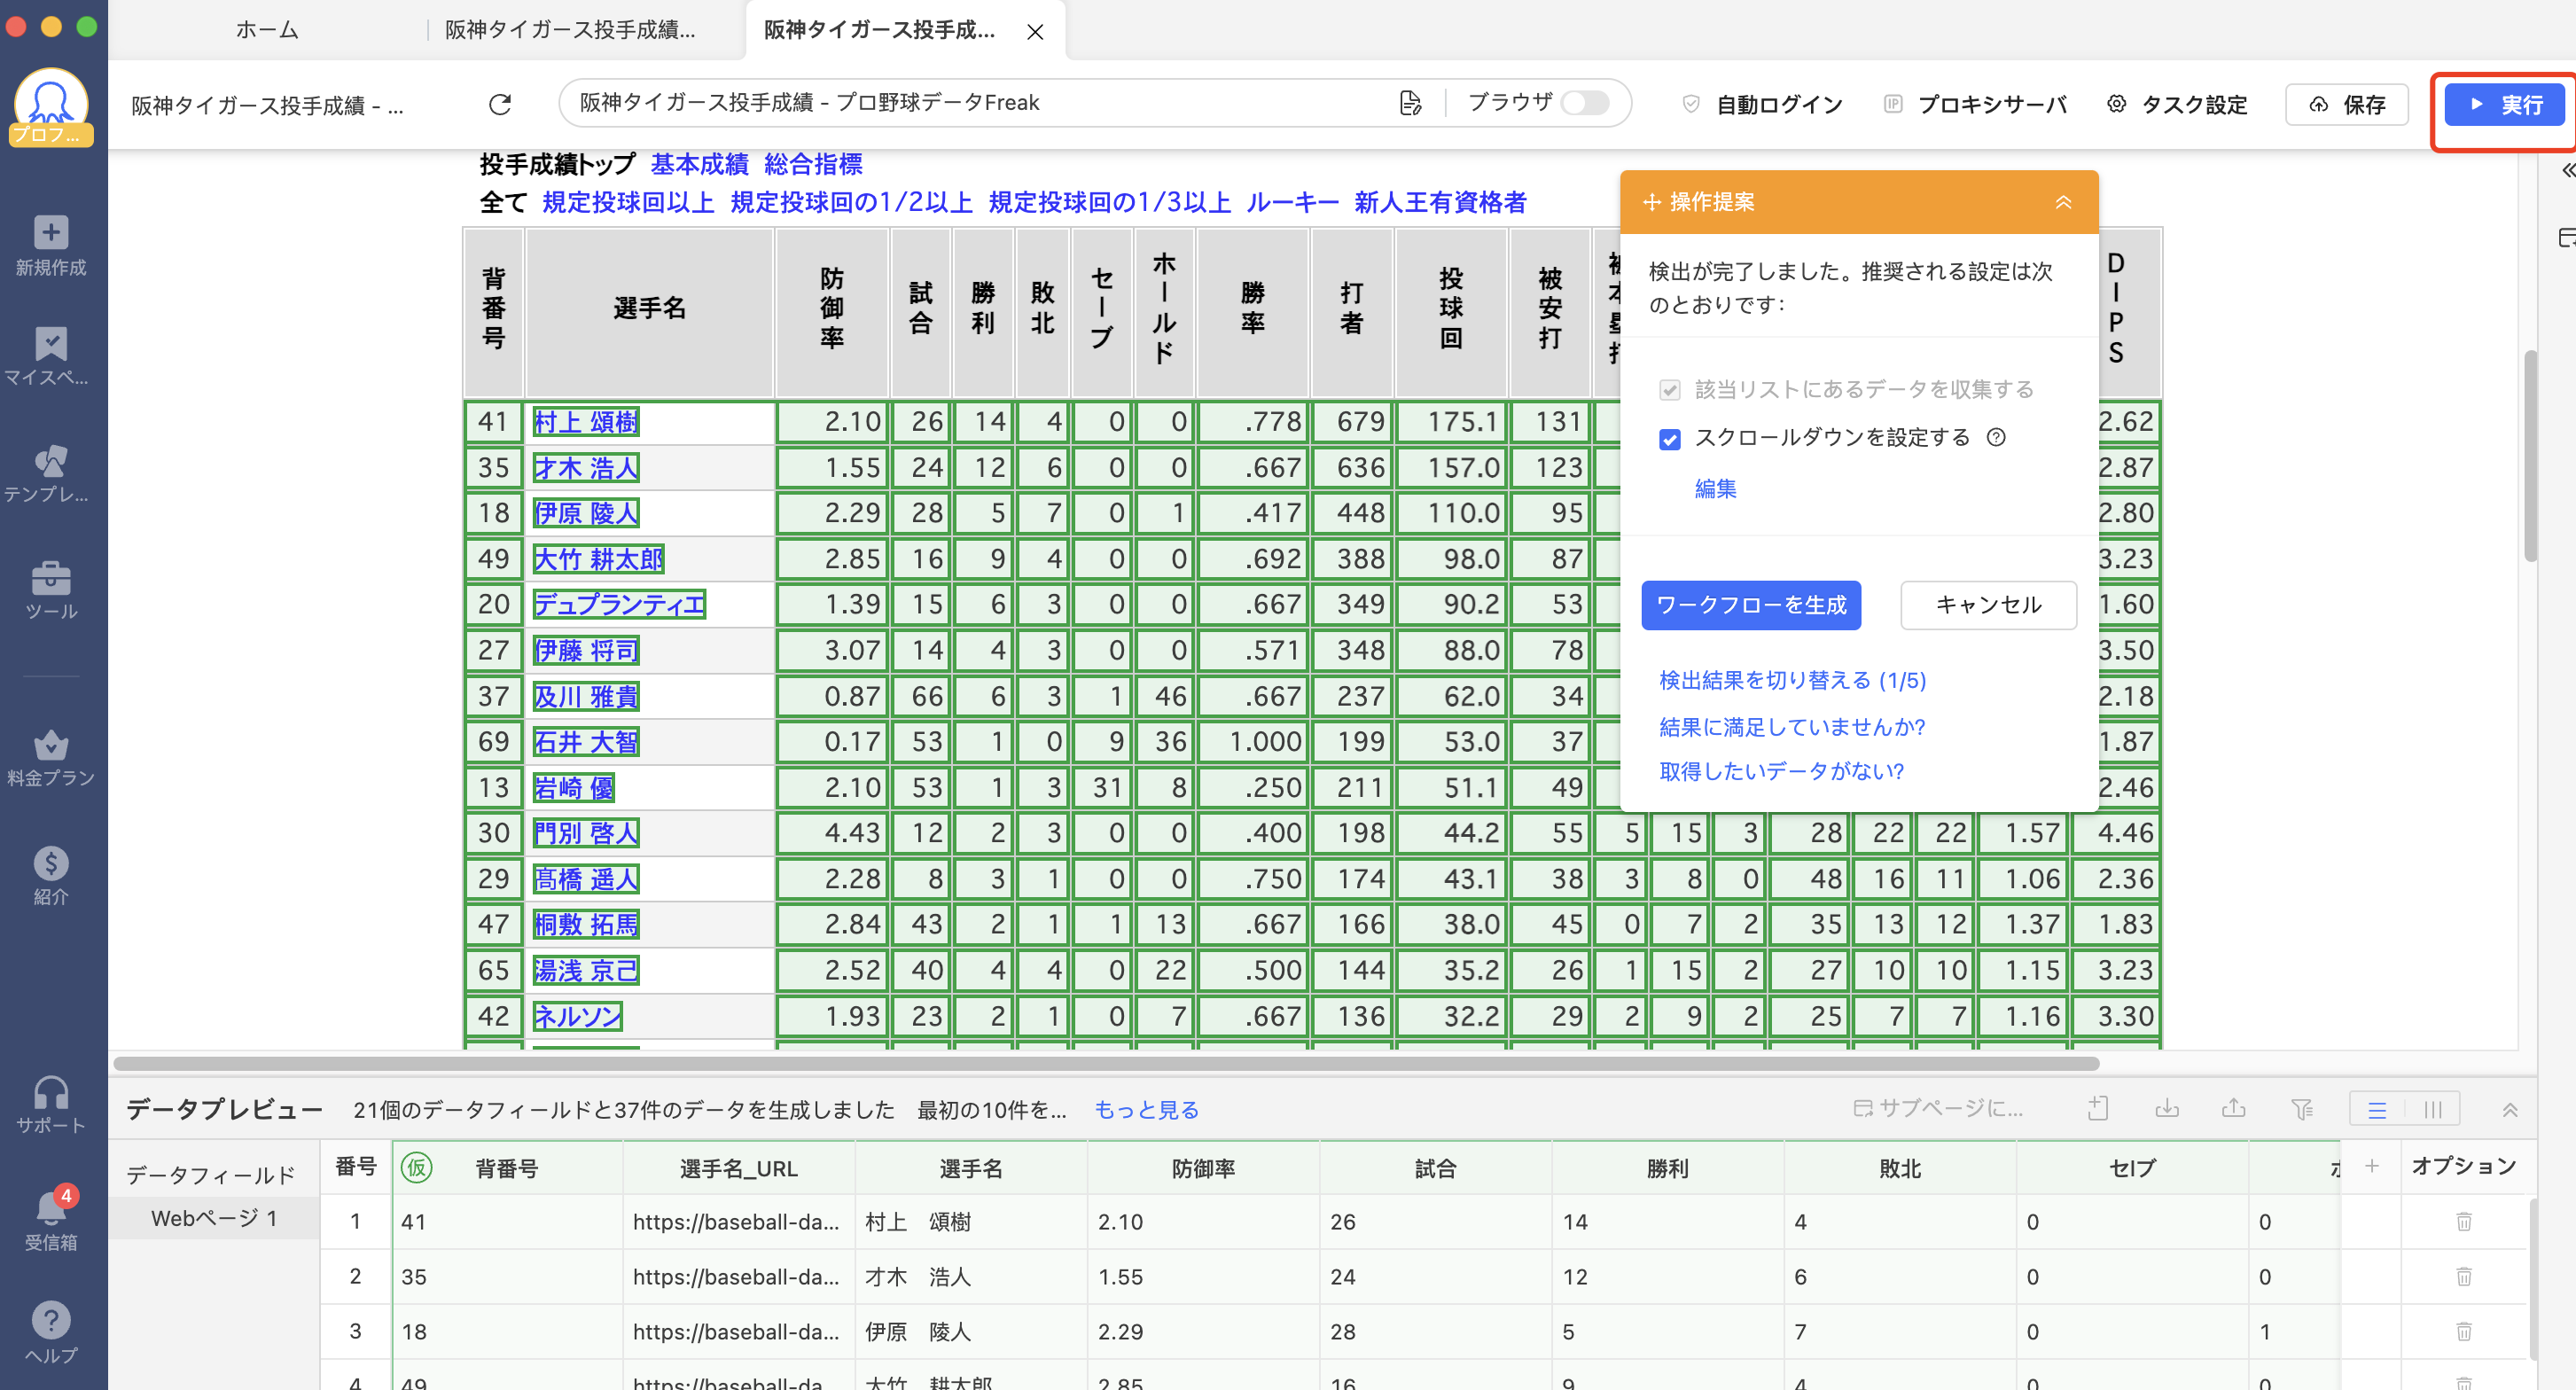
自動検出後は、スクロール設定とデータプレビューを確認してからワークフローを生成します。
よくある質問
画面に見えているデータを取得できないのはなぜですか?
JavaScriptで後から読み込まれる、iframe内にある、ログイン状態でのみ表示されるなどの原因が考えられます。対象要素が表示される条件と、取得時点のHTMLを確認してください。
403と429は同じ対策でよいですか?
同じではありません。429はアクセス頻度の超過が中心ですが、403は権限、URL、ヘッダー、地域制限、サイト側のポリシーなど複数の原因があります。コードだけで決めつけず、発生条件を記録して切り分けます。
CAPTCHAが出たらプロキシを使えば解決しますか?
解決を保証できません。CAPTCHAはアクセス頻度、行動パターン、認証状態など複数の要因で表示されます。まず取得許可と頻度を見直し、必要なら公式APIやサイト運営者への相談を優先してください。
定期実行で最低限監視すべき項目は何ですか?
取得件数、必須項目の空欄率、一意キーの重複率、失敗ページ、実行時間を監視します。前回値と比較し、急減・急増・0件を異常として検知できるようにします。
スクレイピングはプログラミングなしでもできますか?
ノーコードツールを使えば、画面操作でワークフローを作れるケースがあります。ただし、対象サイトの構造、取得可否、データ品質、失敗時の運用を判断する知識は必要です。
まとめ
Webスクレイピングの課題は、症状を「読み込み」「構造」「ページ遷移」「認証」「アクセス制限」「データ品質」「運用」「コンプライアンス」に分けると判断しやすくなります。いきなり大量実行せず、取得可否を確認し、小さなサンプルで成功条件を検証してから範囲を広げましょう。Octoparseを使う場合も、待機、ページ送り、Cookie、クラウド実行などを目的に合わせて設定し、結果の監視と変更管理までを一つの運用として設計することが重要です。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール