ベクトルデータベース(ベクトルDB)とは、文章・画像・音声などの特徴を表す数値の配列を保存し、問い合わせに近いデータを検索するためのデータベースです。表現が異なる文書を意味の近さで探す検索や、生成AIに根拠資料を渡すRAGの検索部分などで使われます。
ただし、ベクトルDBだけで文章の意味を理解したり、正しい回答を生成したりするわけではありません。ベクトルを作るモデル、データを保存して探す仕組み、検索結果を利用するアプリケーションを分けると役割が明確になります。本記事では従来のDBとの違い、四つの活用分野、代表的な関連ツール、導入時の確認方法まで解説します。
ベクトルデータベースとは
ベクトルは、たとえば [0.2, 0.8, -0.1] のように数値を並べたものです。機械学習では、文章や画像の特徴を数値列で表す処理やその表現を「埋め込み(Embedding)」と呼びます。数値の個々の要素を人間が「色」「価格」などと読めるとは限らず、意味の近さはモデルが作る空間と、距離・類似度の計算方法に依存します。
ベクトルDBは、生成済みのベクトルにID、元文書、出典URL、更新日、カテゴリなどのメタデータを結び付けて管理します。問い合わせも対応するモデルでベクトル化し、近いものを上位から返します。Milvusの公式説明でも、アプリケーションがデータ、埋め込みモデル、アクセス規則を用意し、DBが保存・索引・検索を担う分担が示されています。
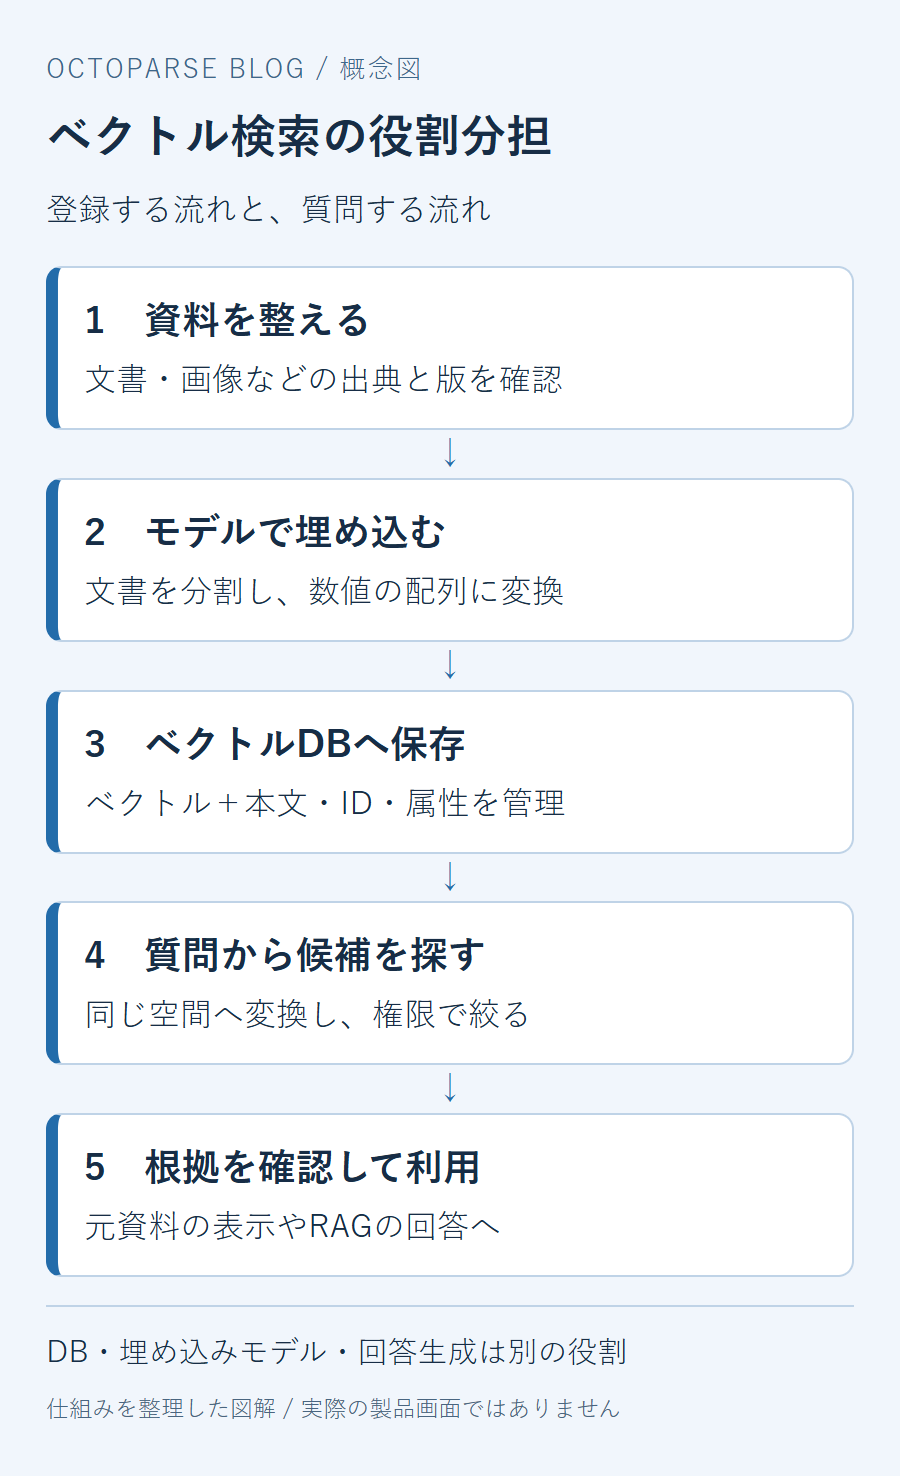
登録から検索までの仕組み
- 資料を用意する:取得・利用する権限と版を確認し、文書IDと出典を付けます。
- 文章を分割してベクトル化する:見出しや段落の関係が分かる単位に分け、埋め込みモデルとその版を記録します。
- 保存して索引を作る:ベクトルに本文・ID・メタデータを対応付け、検索方式を選びます。
- 質問を検索する:対応する埋め込みで質問を変換し、閲覧権限や対象日などの条件を適用して候補を取得します。
- 結果を利用する:元資料を表示する、別モデルで順位を調整する、LLMへ根拠として渡すなど、目的に応じて後処理します。
保存する文章と質問は、互換性のある埋め込み空間で比較する必要があります。同じ次元数でも別モデルの数値をそのまま混ぜると、距離の意味は保てません。モデルを変更する場合は再生成の要否、移行中の検索先、旧索引の扱いを確認してください。
従来のデータベースと何が違うか
業務用のリレーショナルDBは、顧客IDや日付での条件検索、結合、取引の整合性管理などに適しています。ベクトル検索は「指定条件に一致するか」に加えて、「どれが特徴として近いか」を順位付けする方法です。通常のDBでも拡張機能でベクトルを扱えるため、両者が完全に別物とは限りません。DBの基本はデータベースの解説を参照してください。
| 探したいもの | 適した考え方 |
|---|---|
| 注文番号が一致する取引 | IDの完全一致やSQLの条件検索。意味が近い別注文が返っても代わりにはなりません。 |
| 質問と関連するマニュアル | ベクトル検索で言い換えを含む候補を取得し、出典と適用条件を確認します。 |
| 特定型番についての説明 | 型番の文字列検索と意味検索を組み合わせるハイブリッド検索を検討します。 |
| 今あるPostgreSQLのデータを類似検索 | 専用DBの新設だけでなく、pgvectorのような拡張を含めて比較します。 |
厳密検索とANN:速さと取りこぼしを分ける
厳密な最近傍検索は、距離に従って最も近い候補を正確に求めます。大量の高次元データでは計算負担が増えるため、HNSWやIVFなどの索引を使う近似最近傍探索(ANN)が選ばれます。ANNは探索範囲を絞ることで高速化しますが、厳密検索と同じ上位候補を常に返すとは限りません。
pgvectorの公式READMEは厳密検索と近似検索の両方を案内しています。検索時間だけでなく、正解候補の取りこぼし、索引のメモリ、構築・更新の時間を測って方式を選びます。「従来のDBより必ず速く正確」という比較はできません。また、距離上の最近傍であることと、読者の質問に正しく答えられることは別の評価です。
距離の考え方をPythonで確認する
次は手で決めた2次元ベクトルを使い、ユークリッド距離の二乗が小さい順に並べる学習用の最小例です。埋め込みモデルやDBは使いません。数値の近さで順位が決まる部分を、Python 3の標準機能だけで確認できます。
この数値例は文章検索の精度を示す実測ではありません。実際の意味検索では、埋め込みモデルが作ったベクトルと推奨する距離尺度を使います。コサイン類似度は向き、ユークリッド距離は点同士の距離、内積は向きと大きさの影響を受けるため、自己判断で入れ替えずモデルとDBの仕様を合わせましょう。
ベクトルデータベースのメリットと利用範囲
主な利点は、大量の候補から特徴の近いデータを探す処理を、保存・索引・属性の絞り込みと組み合わせられることです。以下は用途の設計例であり、特定企業での実施結果や効果を示すものではありません。
画像認識・類似画像検索
商品写真を画像モデルでベクトル化し、似た外観の商品を探す用途があります。入力は写真、出力は候補の商品IDや画像URLです。在庫や販売地域で候補を絞るには、その属性も別に管理します。画像から特徴を取り出すのはモデルであり、DB自体が物体検出や顔認証の全処理を行うわけではありません。
背景や撮影角度が近いだけの商品が上位になる場合もあるため、同一商品・似た商品・無関係な商品の評価用画像を分けます。本人識別を伴う用途では、取得根拠、保存期間、アクセス権限を含めて別途設計が必要です。
自然言語処理(NLP)・文書検索
質問文からFAQやマニュアルの関連箇所を探す用途です。「返品したい」と「返送の手続き」のような表現の違いを扱う候補になります。一方、型番、規程番号、否定表現や細かな条件は意味の近さだけで区別しにくい場合があります。全文検索、属性条件、再ランキングを組み合わせ、候補の根拠を確認します。
レビューを似た話題ごとに集めることもできますが、分類名を付ける処理、感情分析、機械翻訳は別のモデルやプログラムの担当です。検索結果が似ているという理由だけで、レビュー全体の傾向や不具合の原因を断定しないようにします。
音声認識・音声の類似検索
音声の特徴を表すベクトルで似た音を探す方法と、音声認識で文字起こししてから文章として検索する方法があります。会議内容を探したいのか、音響的に似た素材を探したいのかで、必要なモデルと評価が変わります。ベクトルDBが音声を自動で正確に文字起こしするわけではありません。
会議の検索なら、候補に音声ファイルIDと開始・終了時刻を付けて、該当箇所を聞き直せるようにします。録音の許可、話者情報の扱い、削除依頼への対応も、検索方式と別に確認します。
データ分析・推薦
顧客や商品の行動特徴をベクトルにし、似た傾向の候補を推薦する構成があります。まず何を「近い」とみなすかを決め、購買回数、閲覧履歴などの特徴量やモデルを設計します。ベクトルDBは近い候補を返す部分を担い、需要予測や売上改善を自動で保証するものではありません。
評価では、既存の推薦方法に比べて候補が役立つか、人気商品ばかりに偏らないか、利用できない商品を除けるかを見ます。距離のスコアが高いことを、そのまま成約確率や因果関係として読むことはできません。
RAGでの役割:検索と学習を混同しない
RAGは、質問に関連する資料を検索し、その内容をLLMへの入力に加えて回答を作る方法です。ベクトルDBはその検索先の一つで、すべてのRAGに専用のベクトルDBが必須というわけではありません。登録した資料をLLMの重みに追加学習させる処理とも異なります。
根拠資料が古い、条件違いの文書が取れる、必要な部分が分割で欠けると、回答も誤る可能性があります。出典を返すこと、根拠がない質問への対応、検索対象の権限、生成回答の検証までをアプリケーションで設計してください。
ベクトルデータベースの代表的なサービスと関連ツール
以前から紹介される次の五つは、同じ種類の製品ではありません。DB、検索エンジン、検索ライブラリ、ベクトル生成を助けるライブラリを区別すると、運用で何を自分で用意するかを判断できます。
Elasticsearch:全文検索とベクトル検索を組み合わせる
Elasticsearchの公式ガイドでは、埋め込みの保存・類似検索を全文検索、フィルタ、集約と組み合わせる仕組みが説明されています。既存のキーワード検索も必要なサービスで検討できます。採用時は、対象のデプロイ方式、埋め込み生成の経路、検索クエリ、更新方法を確認します。
Gensim:自然言語処理のPythonライブラリ
Gensimは、トピックモデルや文書・単語のベクトル表現などを扱うPythonライブラリです。文書を表現する処理や関連文書の分析に役立ちますが、一般的なDBサーバーの認証、複数利用者の管理、バックアップまで一式提供する製品として選ぶものではありません。
Faiss:類似検索・クラスタリングのライブラリ
Faissは、密なベクトルの類似検索やクラスタリングを行うライブラリです。C++で実装され、Pythonから利用でき、一部のアルゴリズムはGPUに対応します。索引方式を比較する検証やアプリケーションへの組み込みに向きますが、APIサーバーやアクセス制御などは別に設計します。
Annoy:ファイルで配布できる近似検索ライブラリ
Annoyは、C++とPythonで近似最近傍検索を利用するためのライブラリです。読み取り用の索引をファイルに保存し、複数プロセスから利用する構成が特徴です。構築済みの木には項目を追加できないため、データを頻繁に更新する用途では、索引の再構築と切り替え方を確認します。
Milvus:ベクトルを保存・検索するDB
Milvusは、埋め込みと構造化メタデータを保存し、検索するオープンソースのベクトルDBです。検索機能だけを組み込むライブラリとは異なり、DBとしての構成・運用を検討する対象です。実行環境、データ量、索引、フィルタ、更新頻度に合う構成を選び、特定のGPUや速度倍率を前提にしないで評価します。
導入前に確かめる品質と運用
- 検索品質:代表質問と正解資料を用意し、上位k件に必要な根拠が入る割合や誤った候補を確認します。ANNは厳密検索とも比較します。
- 絞り込みと権限:部署・顧客・文書版などの条件を適用し、権限外資料が候補や回答へ混ざらないことを試します。
- 更新・削除:文書IDから該当する全チャンクを追跡できるようにし、廃止資料や変更前のベクトルが残らないか確認します。
- 負荷と費用:データ件数だけでなく、次元数、同時検索、索引メモリ、埋め込み再生成、バックアップを含めて見積もります。
- 復旧と監視:元資料、モデル版、変換手順を残し、索引を再作成できるか、失敗を誰が検知するかを決めます。
たとえばFAQの改定なら、元文書の更新日だけを変えるのでは不十分です。古いチャンクを特定して削除または置換し、新しい本文とベクトルを対応付け、改定対象の質問で検索し直します。検索用ベクトルに変換しても個人情報が自動で匿名化されるわけではないため、元資料と同じく管理対象として扱います。
ベクトルデータベースの今後の展望
専用のベクトルDBに加え、既存DBの拡張や検索エンジンにも類似検索が取り込まれています。選択では製品カテゴリだけでなく、今あるデータ基盤、必要な検索、更新・権限・監視を一緒に考えることが重要です。単にベクトル数を増やすより、使う根拠が新しく、必要な人にだけ届く仕組みが実用性を左右します。
まず小さな評価用データと質問で、通常の文字列検索や既存DBで足りるかを確かめましょう。言い換えや画像の特徴で探す必要が明確になってからベクトル検索を加えると、追加した仕組みの価値と運用負担を比較できます。
まとめ
ベクトルDBは、特徴を数値にしたデータを保存し、近い候補を探す基盤です。埋め込み生成、検索、回答生成の役割を分け、厳密検索とANNの違いを理解することが出発点になります。四つの活用分野と関連ツールの種類を踏まえ、検索品質だけでなく権限、更新、削除、復旧まで検証して選んでください。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール