AI学習データとは、機械学習モデルが予測・分類・生成のためのパターンを学ぶ際に使うデータです。画像や文章を集めただけで完成するわけではなく、目的に合う範囲、ラベル、利用条件、評価方法をそろえる必要があります。本記事では、学習データと教師データの違い、収集方法、委託先の選び方、テキスト・画像・音声のデータセット、品質確認の進め方を解説します。
AI学習データとは
教師あり学習では、入力と正解ラベルを組み合わせて学習します。例えば図形の画像に「三角」「丸」などの正解を付ける作業がアノテーションです。一方、教師なし学習は通常、正解ラベルのないデータの構造を探します。自己教師あり学習のようにデータの一部から学習用の目標を作る方法もあるため、すべてのAI学習データに人手の正解付けが必要とは限りません。IBMの学習データ解説でも、学習方法による違いが説明されています。
教師データは、特に教師あり学習で入力と正解の対応を示すデータを指します。まず「何を入力し、何を判定したいか」を定義しましょう。問い合わせ分類なら文章とカテゴリ、物体検出なら画像と物体の位置など、同じ画像・テキストでも必要なラベルは変わります。自社データ、公開データセット、収集委託を比較し、必要な品質と利用条件を満たす方法を選びます。
元データには画像、動画、テキスト、音声、数値などがあります。実際に利用する言語、年代、撮影条件、機器、対象業務に合うかを確認してください。公開されているデータセットでも、商用利用、改変、再配布、モデルへの利用に条件が付くことがあります。自社で収集する必要があるかは、既存データと要件の差を調べて判断します。
AI学習データ収集の重要性
AI技術の発展において、AI学習データの収集は非常に重要なプロセスです。AIモデルの性能は、使用される学習データの質と量に大きく依存しています。ここでは、AI学習データを収集する重要性について、初心者でも理解しやすいように解説します。
データの質が予測と評価の信頼性に影響する
AIモデルは、提供されたデータからパターンを学習し、新しいデータに対して予測や判断を行います。そのため、学習データに含まれる情報の質が直接、AIの判断の正確性や信頼性に影響します。高品質な学習データを使用することで、より精度の高いAIモデルを構築することが可能になります。
多様性がAIの汎用性を高める
AIモデルに多様なデータを提供することは、AIの汎用性を高める上で重要です。例えば、画像認識AIを学習させる場合、さまざまな環境や条件下で撮影された画像を学習データとして使用することで、AIはより多くのシナリオに対応できるようになります。このように、データの多様性はAIモデルの適用範囲を広げるために不可欠です。
データ量は目的と評価結果から決める
必要な件数に一律の正解はありません。モデルの種類、タスクの難しさ、カテゴリの数、既存モデルを追加学習するかで変わります。重複や誤ラベルを大量に増やしても有効な情報は増えません。まず小さな代表サンプルで学習と評価を行い、どの条件で誤りが多いかを調べて不足するデータを追加します。総件数だけでなく、カテゴリ別・環境別の件数と品質を確認することが重要です。
AI学習データ収集方法
AI学習データの収集方法は多岐にわたりますが、効率的かつ効果的な収集方法を選択することが重要です。ここでは、主に使用される収集方法の概要と、それぞれの方法の特徴を紹介します。これらの方法を理解し、プロジェクトの目的や条件に合わせて最適な方法を選択することが、AIモデルの性能向上につながります。
Webスクレイピング
Webスクレイピングは、Webページから必要な情報を抽出する方法です。まず公式のダウンロードやAPIが目的を満たすか確認し、収集が許される範囲で利用します。URL、本文や項目、公開・更新日、取得日、利用条件を一緒に残すと、学習候補の由来を追えます。収集の可否と、AI学習・保存・再配布に使えるかは別に確認してください。大量に取得できても、重複や本文以外の要素が多いままでは学習用に適しません。
オープンデータ
オープンデータや公開データセットは、目的に合えば収集の入口になります。ただし「Webで公開されている」と「自由な条件で再利用できる」は同じ意味ではありません。ライセンス、出典表示、対象期間、欠損、ラベル定義を読み、予定する学習・評価・商用利用が許されるかを確認します。オープンデータの探し方と基本条件はオープンデータの解説にまとめています。
データ収集代行サービス
収集やアノテーションを委託する場合は、対象、納品形式、ラベル仕様、権利処理、検収方法を契約前に決めます。例えば画像の物体検出では、枠の付け方、重なった物体、判断できない画像の扱いまでそろえます。まず少量のサンプルを受け取り、誤りや判断の不一致を修正してから規模を広げると、納品後の手戻りを抑えられます。委託しても、利用目的や評価データの管理は発注側に残ります。
AI学習用データ収集会社を選ぶ際のポイント
AI技術の発展とその応用範囲の拡大に伴い、適切な学習データの収集はAIプロジェクトの成功に不可欠です。データ収集会社を選定する際には、特に以下の三つのポイントを考慮することが重要です。
費用
件数単価だけでなく、対象の探索、取得、ラベル付け、二重確認、再作業、納品後の更新に何が含まれるかを比較します。曖昧なラベルを専門家が確認する作業や、個人情報の処理は追加費用になり得ます。成果物の品質基準と、基準を満たさない場合の修正範囲を先に合意してください。安い単価でも使えないデータが多ければ、学習に使える1件当たりの費用は上がります。
データ品質
品質管理では、正確性、一貫性、多様性、欠損、重複を確認します。ラベル仕様書と判断例を用意し、担当者間で不一致が出た場合の決め方も決めます。全体の平均だけでなく、カテゴリ別、言語別、撮影条件別など、モデルの利用条件ごとに確認してください。実績や評判だけで選ぶのではなく、試験納品の結果、確認記録、誤りの修正履歴から検収できる会社かを見極めます。
柔軟なサポート体制
要件の変更、ラベルの追加、データの訂正や削除に誰が対応するかを確認します。問い合わせ窓口、仕様変更の承認手順、再作業の期限と費用、更新データの差分納品などを具体化すると、運用中の問題を共有しやすくなります。特に継続収集では、どの版の元データ・仕様・成果物を使ったか追跡できることが重要です。単に「柔軟に対応」と書かれたサービス説明だけで判断しないようにしましょう。
目的別に確認したいデータセット
データセットは、対象タスクと利用条件を合わせて選びます。以下は2026年11月18日に提供元を確認した候補です。古いデータセットでも研究上の役割はありますが、本番の言語・環境を代表するとは限りません。データセットの名称や件数だけで決めず、次の点を確認してください。
テキスト
テキストデータは、AI学習において非常に重要な要素です。特に、自然言語処理(NLP)技術の発展に伴い、多様なテキストデータの収集と分析が求められています。
JParaCrawl:日本語を含む対訳コーパス
JParaCrawlは、NTTがWebから収集し、文を対応付けた対訳コーパスです。日英などの翻訳モデルの研究に使う候補で、英語文と日本語文の対応が正しいか、対象分野の語彙が合うかを確認します。公式規約は情報解析を伴う研究開発目的に限定し、商用利用は別途問い合わせるよう案内しています。大量の対訳が公開されていることだけを理由に、製品へそのまま組み込まないでください。
WRIME:日本語の感情分析データセット
WRIMEの公式リポジトリには、日本語投稿に対する筆者本人と第三者の感情ラベルが収録されています。感情強度と極性、主観と客観を区別できる点が特徴です。正解を一つの単純な感情とみなす前に、どの立場のラベルを目的変数にするか決めます。公開ライセンスはCC BY-NC-ND 4.0で、商用利用を自由に許す条件ではありません。利用目的や加工方法について提供元の条件を確認してください。
画像データ
画像データは、コンピュータビジョンの分野において中心的な役割を果たします。特に、画像認識、顔認識、オブジェクト検出などの技術の進歩には、大量かつ多様な画像データセットが不可欠です。
CIFAR-10:画像分類を学ぶための候補
MegaFaceは、公式ページで配布終了が告知されているため、新規収集先としては勧めません。画像分類の学習例には、CIFAR-10の公式ページで公開されている10クラス、32×32ピクセルの画像データを検討できます。入力画像とクラスラベルの対応を学ぶ用途に向きますが、顔認識の代替ではありません。小さな画像での評価が実際のカメラ画像にも当てはまるとは限らず、利用条件と出典も確認します。
Open Images V7:画像・領域・関係のアノテーション
Open Images V7は、画像単位のラベル、物体の枠、セグメンテーションなど複数の注釈を提供します。画像分類と物体検出では使用する注釈が違うため、タスクに必要なファイルを選んでください。公式ダウンロード説明には画像の出典、作者、ライセンスなどの情報もあります。注釈と元画像の条件を区別し、画像が現在取得できるかも確認します。
音声
音声データは、音声認識、音声合成、自然言語理解など、AIの多くの応用分野において重要な役割を果たします。特に、多様な言語やアクセント、発話環境をカバーする広範なデータセットの収集は、AIモデルの汎用性と精度を高める上で不可欠です。
Mozilla Common Voice:音声と書き起こし
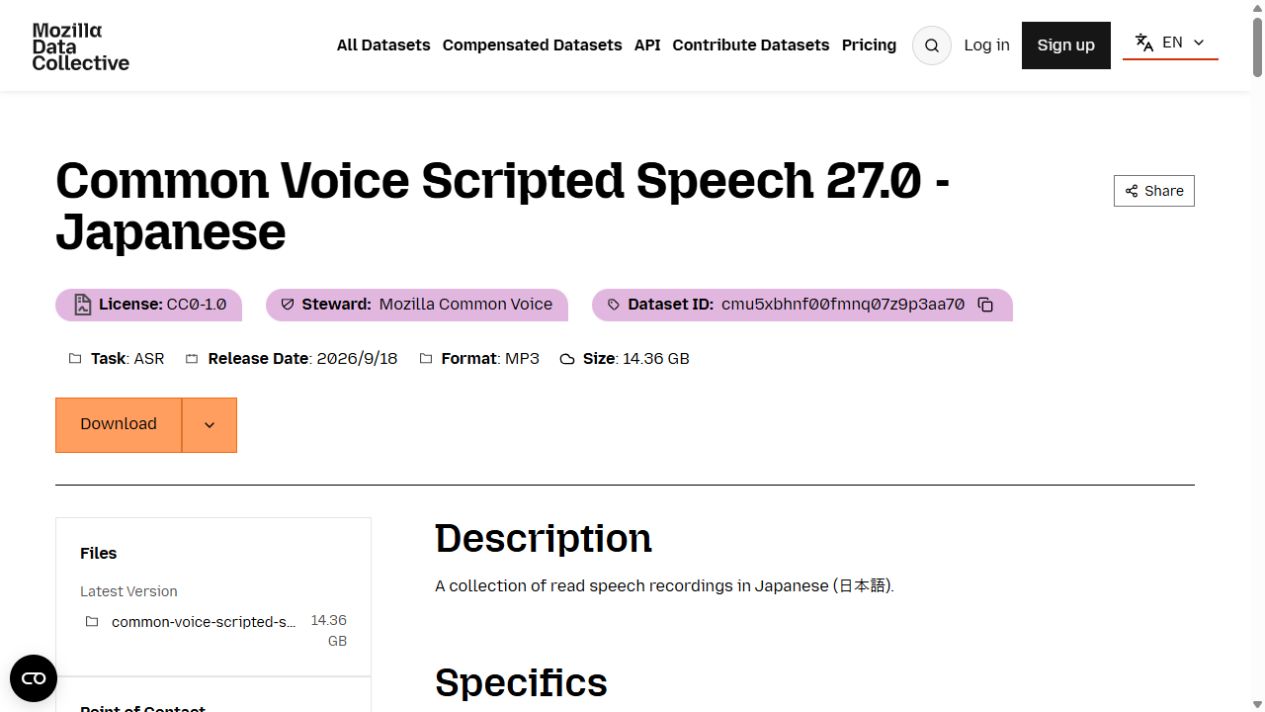
Common Voiceは、コミュニティが作成する音声データのプロジェクトです。現行の配布先はMozilla Data Collectiveで、Common Voice Scripted Speech 27.0の日本語データは日本語の読み上げ音声を扱います。音声認識では音声ファイルと書き起こしの対応を確認し、話者や文章が評価側と重複しないかも点検します。ページにはCC0-1.0の表示に加え、話者の特定やデータセットの再ホスト・再共有を禁止する条件が明記されています。ライセンス名だけでなく詳細条件まで読んでください。
Speech Commands:単語レベルの音声認識
Speech Commandsの原論文は、限られた語彙のキーワードを認識するための音声データセットを説明しています。長い会話の文字起こしとは異なるタスクなので、短いコマンドを検出したい場合の候補です。音声の長さ、対象単語、背景雑音、分割方法、利用条件を確認します。一般的な日本語音声認識モデルの評価を、英語の短いコマンドだけで代用しないようにしましょう。
収集後に行う準備:分割とデータリークの防止
学習用データはモデルのパラメータを学ばせるために使い、検証用データは設定やモデルを比較するために使い、テスト用データは最後の評価に使います。Googleのデータ分割ガイドでは、同じテスト結果を繰り返し使って調整すると、そのテストに合わせたモデルになり得る点も説明されています。分割比率だけを先に決めず、実際に予測する未知データを再現する分け方を考えます。
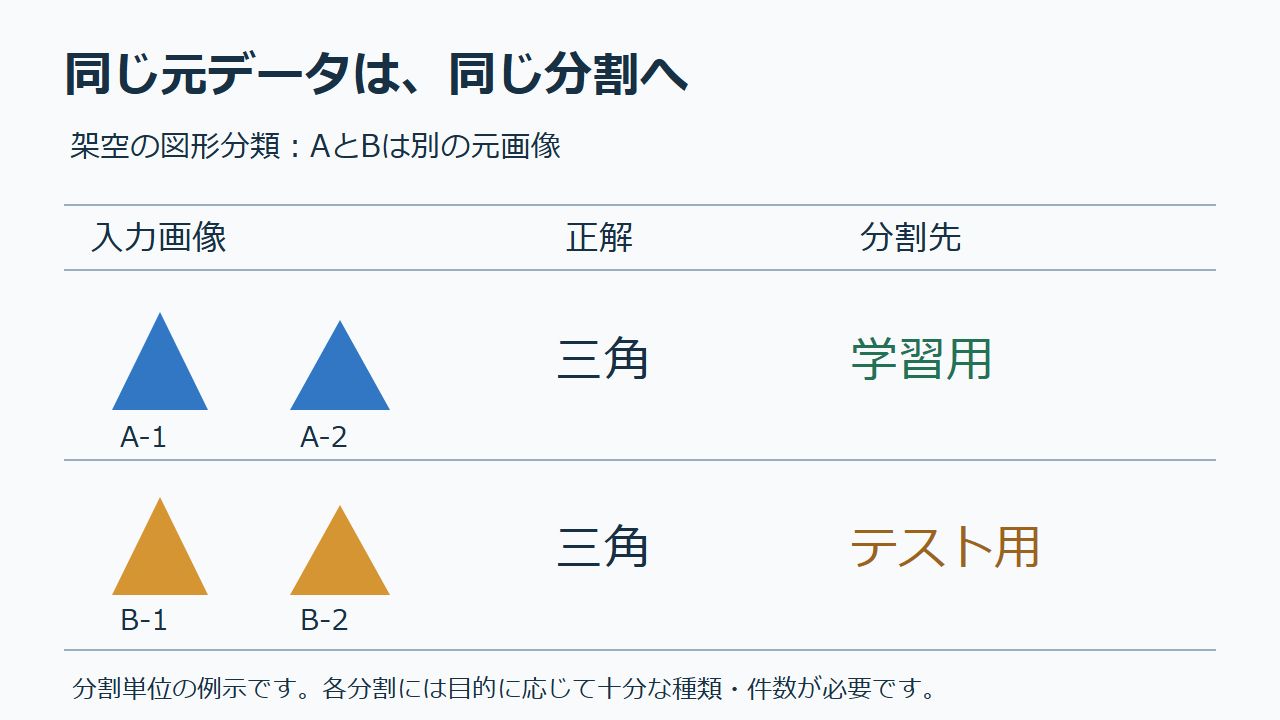
同じ人物の複数記録、同じ商品の別画像、同じ文書の別ページなど、互いに近いデータをランダムに分けると、未知データへの強さを過大評価することがあります。元データの識別子でまとめて分ける、未来の予測なら時間で分けるなど、評価目的に合う単位を選びます。納品一覧には、元レコードID、派生元ID、割り当てた分割、データセットの版を持たせると、同じ元データが複数の分割へ入っていないか照合できます。分割後に画像を加工して増やす場合も、派生元の分割を引き継ぎます。図は分割単位の例であり、実際には各側のカテゴリ構成も確認します。学習方法そのものの用語整理は機械学習の8つの基礎用語を参照してください。
前処理でも漏れが起こります。例えば平均値による補正や特徴量選択を全データで学習してから分割すると、テスト側の情報が混ざります。scikit-learnのデータリーク解説のように、分割後に学習側だけで前処理のパラメータを決め、その変換を検証・テストにも適用します。データの版、分割ルール、ラベル仕様を記録すると再現と見直しがしやすくなります。
AI学習データを収集する際の注意点
AI学習データの収集は、AIモデルの性能に直接影響を与える重要なプロセスです。データの質と量はもちろん、その収集方法にも注意を払う必要があります。以下では、AI学習データを収集する際に考慮すべき主要な注意点をいくつか紹介します。
データの質と正確性
AIモデルの学習に使用されるデータは、正確である必要があります。不正確または誤ったデータを学習材料として使用すると、AIモデルが誤った情報を学習し、その結果として不正確な予測や分析を行うことになります。データ収集の過程で、データの正確性を確保するために、信頼できるソースからデータを収集し、可能であればデータのクリーニングや前処理を行うことが重要です。
データの多様性と包括性
AIモデルが現実世界の複雑さと多様性を理解できるようにするためには、収集するデータが多様であることが必要です。特定のグループやシナリオに偏ったデータのみを使用すると、AIモデルが偏見を持つ可能性があります。したがって、異なる背景、環境、条件からデータを収集し、モデルがより公平で偏りのない判断を下せるようにすることが重要です。
プライバシーと倫理的考慮
個人情報、著作物、契約で制限された情報は、取得できることと学習に利用できることを分けて判断します。利用目的、本人への説明や同意が必要か、匿名化・アクセス制御・保存期間、再配布や商用利用の条件を確認してください。AIと著作権については文化庁の資料なども参照し、個別の権利関係が不明なデータは採用を保留します。匿名化したつもりでも再識別の可能性が残るため、識別子を消すだけで十分とは限りません。
まとめ
AI学習データの準備では、目的と入力・正解を定義し、利用条件を確認し、少量のサンプルで品質を点検してから収集を広げます。収集後はラベル、欠損、重複、カテゴリの偏りを確認し、未知データで評価できる分割を行いましょう。Webページのデータ抽出が必要な場合、Octoparseは抽出項目とページ移動をタスクで設定し、学習候補の元データを構造化する工程を担当できます。公式の製品説明も参照してください。権利確認、アノテーション、学習、モデル評価は別工程であり、抽出しただけで学習用データが完成するわけではありません。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール