Webクローラーエンジニアになるには、Pythonなどの言語だけでなく、HTTP・HTMLの理解、取得先の利用条件、データ品質の検証、運用中の障害対応まで学ぶ必要があります。この記事では「クローラーを作れる」から「継続して安全に運用できる」までの学習順序と、成果物の作り方を示します。
Webクローラーエンジニアの仕事とは
Webクローラーエンジニアは、許可されたデータソースを確認し、ページやAPIから必要な情報を取得して、後工程で使える形に整える担当者です。仕事は取得プログラムを書くことだけではありません。取得範囲・更新頻度・一行の単位・重複判定キーを決め、サイト変更や通信失敗を検知し、欠損が起きたら修復します。クローラーとスクレイピングの基本的な違いは別記事で確認できます。
現行のScrapy公式アーキテクチャでも、リクエストのスケジューリング、ダウンロード、抽出、後処理は別の役割です。実務ではこれらに監視・再実行・権利確認を加えて一つの収集工程として設計します。
クローラー開発で学ぶ順番
1. HTTP・HTML・データの形を理解する
まずHTTPのステータス、リダイレクト、文字コード、HTMLの要素と属性を読みます。ブラウザの表示と取得したHTMLが違う場合は、JavaScriptによる後読み込みを疑います。最初から大規模な並列収集に進まず、取得した一ページから「一行は何を表すか」「必須列は何か」を定義してください。
2. 小さな取得処理とテストを書く
Pythonの標準ライブラリやScrapyを使う場合、取得・解析・保存を分けて作ると失敗箇所を特定しやすくなります。ページ送りの終了条件、タイムアウト、再試行の上限を明示し、取得先に過度な負荷をかけない間隔を設定します。どの言語を選ぶかはスクレイピング言語の比較記事を参照し、本記事では選定表を繰り返しません。
3. データ品質と運用を設計する
URLなどの一意キー、取得日時、出典URL、必須項目を保存します。ページ数だけで成功と判断せず、空欄率、重複、前回との差、サンプル行の元ページ照合を確認します。ログには失敗したURLと理由を残し、認証情報や個人情報は記録しません。サイトの構造が変わる前提で、セレクタの修正と再実行手順をREADMEに記載します。
成果物の具体例:CSVの欠損と重複を確認する
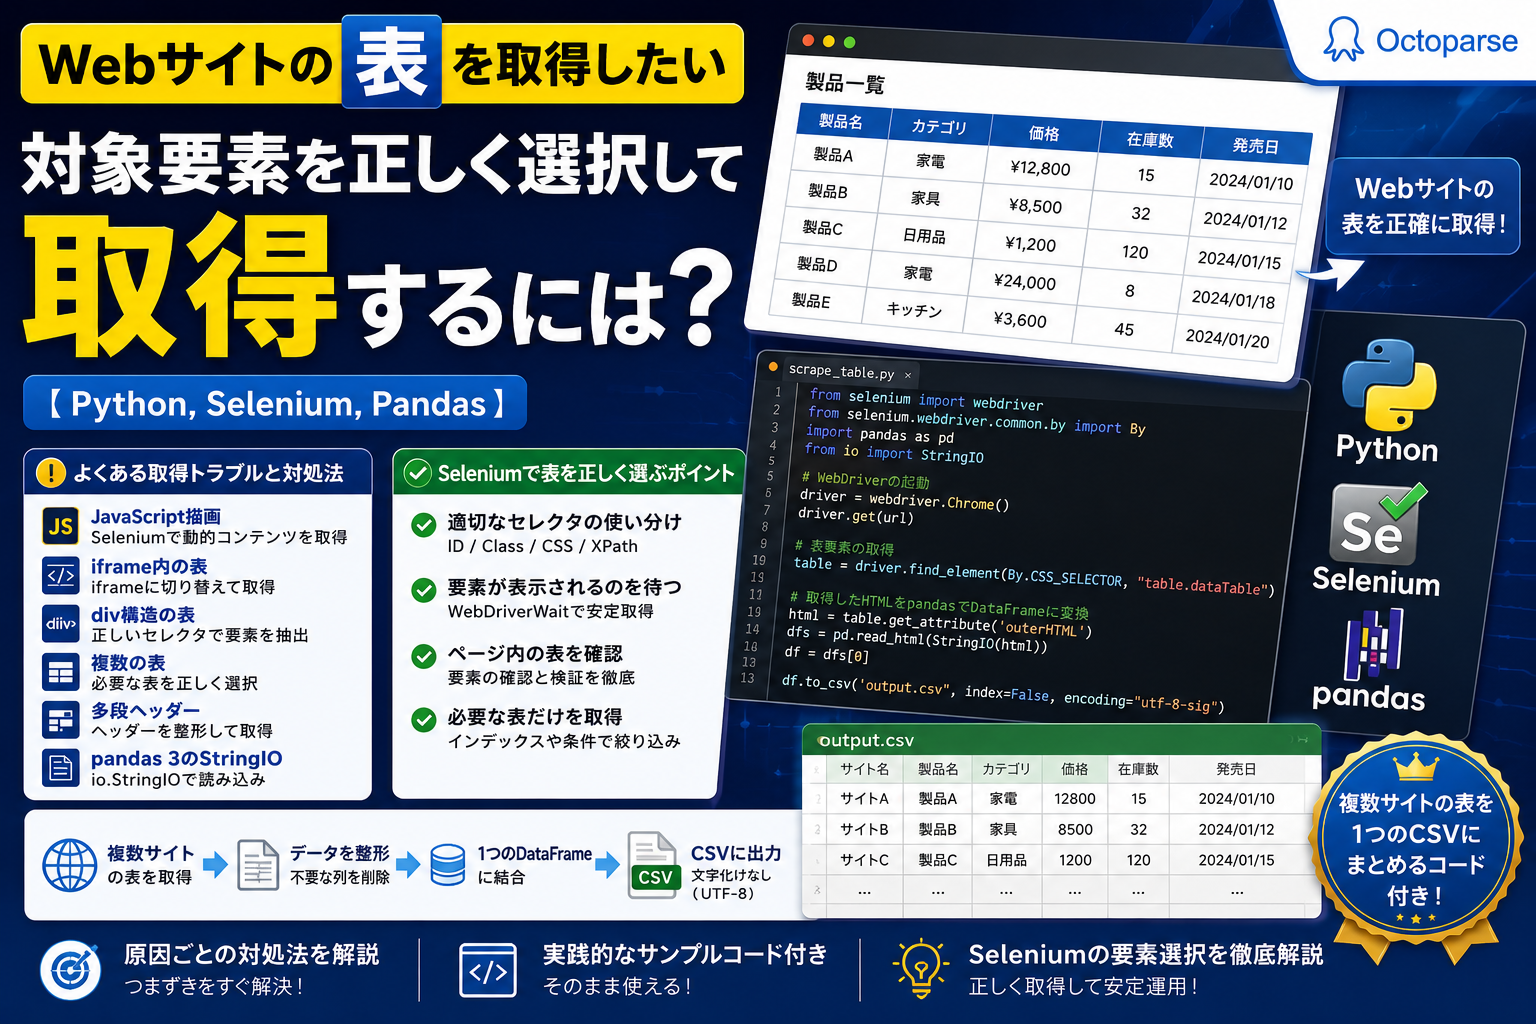
学習用の成果物には、収集コードだけでなく品質確認を付けましょう。次のPythonコードは、自分で取得したCSVに source_url 列と title 列があるかを確認し、空欄とURL重複を数えます。CSVの列名が異なる場合は、コード内の列名を置き換えてください。
同じURLに複数の更新時点や別レコードが含まれる場合は、URLだけを重複キーにしないでください。ページの構造と業務上の一行の定義に合わせて、IDや取得日時を組み合わせます。空欄・重複が見つかったら元ページ、抽出条件、ページ送りを順に見直します。
ポートフォリオに残すべきもの
- 取得の目的、対象と利用条件、公式APIや公開ダウンロードを先に調べた記録
- 入力URL、出力列、一行の単位、ページ送りの終了条件を示す設計書
- 取得・抽出・品質確認のコードまたはタスク設定と、再実行手順
- サンプル行の照合方法、欠損・重複の検査、失敗時のログと修復方針
robots.txtの標準は自動アクセスに関するサイト側の指示を定めます。これに加え、利用規約、API利用条件、著作権、個人情報、アクセス負荷を個別に確認してください。アクセスを拒まれた場合に、無断で制限を回避することを学習目標にしないことが重要です。
Octoparseと自作クローラーの使い分け
コードを書く前にページの構造や必要な列を確かめたい場合は、Octoparseで小規模なタスクを作り、抽出結果を検証する方法もあります。公式ヘルプセンターによると自動検出は類似要素やページネーションの候補を示しますが、特殊・複雑なページでは精度が下がる場合があります。タスクを試す際も、列の対応、終了条件、サンプル行を自分で確認してください。
独自の認証連携、細かなテスト、チームのCI/CDや専用のデータ基盤まで一体で管理するなら自作が適します。OctoparseはWeb上のデータ取得を助ける製品であり、分析や品質保証を自動で完了するものではありません。公式CSV/APIが目的を満たすなら、まずその経路を選ぶのが合理的です。
よくある質問
未経験なら最初に何を作ればよいですか?
利用を許された小さなデータソースで、一ページ取得、列の定義、CSV出力、欠損・重複検査までを一つにまとめます。速度や件数より、再現できる手順と検証記録を優先してください。
年収はいくらですか?
職種名、担当範囲、雇用形態、勤務地で変わるため、古い別職種の平均値をクローラーエンジニアの相場として扱うことはできません。応募時には現行の求人票で開発・運用・データ基盤の責任範囲と提示額を確認してください。
まとめ
Webクローラーエンジニアを目指すなら、HTTPとHTML、取得処理、データ品質、運用と利用条件を一続きで学びましょう。コードやノーコードのどちらを使う場合も、作ったデータを元ページと照合し、失敗を検知・修復できることが実務上の強みになります。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール