文章や表の備考欄に混ざったメールアドレスを抜き出したいとき、正規表現を使うと「文字の並び方」を条件にして候補を探せます。ただし、候補を抽出することと、そのアドレスが実在・送信可能であることを確かめることは別です。本記事では、メールアドレス抽出を例に、Excel、Python、Octoparseの3通りを比較し、式・コード・操作手順と確認ポイントをまとめます。
まず決める:1件だけか、複数件か
たとえば備考欄に「窓口 sales@example.com、サポート support+jp@example.org」と書かれている場合、最初の1件だけを別セルに移すのか、2件とも一覧にするのかで手順が変わります。元の文字列を残したまま抽出列を追加し、少なくとも「一致なし」「複数一致」「句読点が隣接」「同じアドレスの重複」を確認してください。ここで使う example.com などは入力方法を示す例示用のドメインです。
以下では、一般的な半角英数字のアドレス候補に使える簡易パターン [A-Za-z0-9._%+-]+@(?:[A-Za-z0-9-]+\.)+[A-Za-z]{2,} を使います。@ の前は英数字・一部の記号、後ろはドット区切りのドメインを想定し、\. は「任意の1文字」ではなくピリオドそのものを表します。引用符付きのローカル部、国際化アドレスなどを網羅する検証式ではありません。抽出後に用途に合う別の検証を行ってください。
方法1:ExcelのREGEXEXTRACT関数で抽出する
備考欄や問い合わせ一覧がすでにExcelにあり、対応するMicrosoft 365版Excelを使えるなら、MicrosoftのREGEXEXTRACT関数で列ごとに処理できます。古い買い切り版を含むすべてのExcelで使える機能ではないので、まず利用中の環境で関数を入力できるか確認してください。
A2に対象テキストがある場合、B2に次の式を入力します。第3引数の 0 は最初の一致だけを返し、1 に変更すると複数の一致を返します。下の行にも適用する場合は式をコピーし、空欄や一致しない行を確認します。
「窓口 sales@example.com、サポート support+jp@example.org」のように複数件を持つセルで第3引数を 1 にすると、結果は配列として周囲のセルへ展開されます。展開先に値がある場合や、行ごとに件数が違う場合は表の配置が崩れないか確かめてください。式はメールアドレスの候補を取り出すもので、宛先として使えることの証明ではありません。
方法2:Pythonでテキストファイルから全件を探す
長いテキストファイルから複数の候補を抽出したい場合は、Python標準ライブラリの re.findall が使えます。次のコードはUTF-8の contacts.txt を読み、上記の簡易パターンに一致した候補を重複を除いて表示します。ファイルは自分が取り扱う権限のあるものを指定してください。
たとえばファイル内に sales@example.com と support+jp@example.org があれば、その2件が候補になります。大文字小文字の違いや余分な記号、複数箇所にある同一アドレスをどう扱うかは目的次第です。re.findall はテキスト内の一致を探しますが、元ページの利用許可、本人の同意、宛先の有効性まで判断しません。公開ページから得た連絡先の利用には、サイトの条件と個人情報の取り扱いを別途確認してください。
方法3:Octoparseで取得したフィールドを正規表現で整形する
Webページのテキストからデータを取得するタスクを作っている場合は、Octoparseの抽出フィールドに対して正規表現を適用できます。ここでの役割は、ページ上に表示されるテキストを収集し、そのフィールドの値からメールアドレス候補を切り出すことです。Web上に存在しないアドレスを見つけたり、アドレスの実在性を保証したりする機能ではありません。まず対象サイトの利用条件と取得範囲を確認します。
- 対象ページを開くタスクで、メールアドレスを含む本文や連絡先欄を抽出フィールドとして指定し、数ページのプレビューで元の文字列が取れているか確認します。
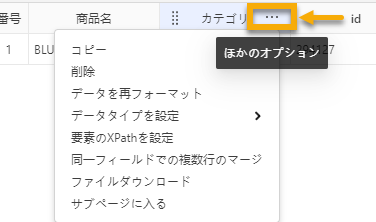
- そのフィールドの右上メニューで「データを再フォーマット」を開きます。
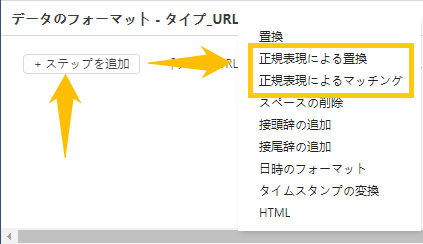
- 「ステップを追加」から「正規表現によるマッチング」を選び、サンプルの文字列で一致結果を確認します。ジェネレーターで複数の一致が必要なら「すべて一致」の設定も確認します。
- 必要な列だけを残してプレビューを再確認し、収集したデータを利用環境で選べる形式へ出力します。複数アドレスを1件ずつ別行にしたい場合は、フィールド構成と後処理を別途設計します。
公式ヘルプの正規表現ツール解説には、サイドバーの「ツール」から正規表現ジェネレーターを開く方法や、よく使うパターンを選ぶ方法もあります。画面や利用できる機能はバージョン・契約で変わるため、実際の画面で項目を確認してください。
抽出できない・余計な文字が混ざるとき
- 0件になる:まず元フィールドに文字列が入っているか、ページの遷移前後で要素が変わっていないかを確認します。正規表現は空欄からアドレスを作れません。
- 末尾の句点や不要な文字を拾う:
\S+@\S+のような広すぎる条件は避け、複数のサンプルで抽出結果と元テキストを並べて点検します。 - 1件しか取れない:Excelでは戻り値モード、Pythonでは
findallの使用、Octoparseではフィールドの一致結果と行の構成を確認します。 - 形式は合うが使えない:正規表現は構文の一部を見ているだけです。重複、公開範囲、利用目的、送信可否は別の工程で確認します。
まとめ
表の一列を整えるならExcel、複数のテキストを処理するならPython、Webページから収集したフィールドをその場で整形するならOctoparseが候補です。どれも最初に「どの文字列を、何件、どの列に取り出すか」を決め、元データと抽出候補を照合することが大切です。正規表現は候補抽出の道具と考え、アドレスの実在性や利用可能性の判断とは切り分けましょう。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール