データマイニングとは、データの中にあるパターンや関係を見つけ、予測や意思決定に役立つかを検証する取り組みです。売上の合計を集計するだけでなく、似た特徴を持つ対象のグループや、普段と異なる記録などを調べます。データを集めるスクレイピングとは役割が異なり、件数が多いだけで正しい結論が得られるわけでもありません。
本記事は、データマイニングの「五つの特徴」を、誤解しやすい点と合わせて確認するための解説です。大量なら正確なのか、分析結果は自動的に信頼できるのか、発見は必ず未知でなければならないのか。こうした疑問を整理し、結果の読み方と工程ごとの確認項目につなげます。手法の体系と全体のプロセスは、データマイニングの総合解説も参照してください。
特徴を理解するための基本の意味
統計学や機械学習などを用いてデータを調べ、傾向や関連性を取り出すプロセスです。例えば、商品の同時購入の傾向を探す、顧客を似た行動のグループに分ける、過去の記録から将来の値を予測するといった課題に使います。IBMの解説も、記述と予測の両方を主な用途として挙げています。
データマイニングを、業務目標の設定からデータ準備・評価・運用まで含む広い意味で使う場合もあります。分析手法だけを指す場合もあるため、プロジェクトでは担当範囲を明確にしましょう。データ全般を扱う分野はデータサイエンス、集計結果を共有する用途はBIとも関係しますが、同じ言葉ではありません。
スクレイピングは収集、データマイニングは分析・知識の発見を担います。Webから価格を一覧にするところまでが収集で、価格変動のパターンを調べるのが分析です。ブラウザー拡張機能の「Data Miner」という製品名とも区別してください。製品の操作方法はData Minerの使い方で扱っています。
データマイニングの重要性
記録が複数のシステムに分かれていたり、項目が多かったりすると、表を眺めるだけでは関係を把握しにくくなります。データマイニングは、調べる対象を絞り、判断の候補を得るための手段になります。小売の購買分析、製造の保全、金融の異常検知など、用途は目的によって変わります。個々の用途例はAWSのデータマイニング解説でも紹介されています。
ただし、分析すれば自動的にノイズが消えたり、必ず利益が出たりするわけではありません。誤記録や欠損の確認、業務担当者による解釈、実施後の評価が必要です。見つけた相関が偶然ではないか、別の要因で説明できないかも調べます。
データマイニングの五つの特徴と誤解しやすい点
1. データの量だけでなく、目的との適合性を重視する
大量の記録を扱えることは特徴ですが、必要な件数は課題やばらつきによって異なります。少量のデータでも探索はできます。反対に、同じ対象の重複や偏った時期のデータを増やしても、知りたい対象を正しく表せるとは限りません。収集前に対象範囲、期間、一行が表す単位を決めましょう。
2. 信頼性を自動的に保証せず、検証によって確かめる
データに基づく結果でも、入力の誤りや評価方法の誤りがあれば信頼できません。元の記録に戻れる出典、加工ルール、検証用データを残します。予測を行う場合は学習に使っていないデータで評価し、対象や時期が変わっても役立つかを確認します。
3. 表面の集計から一歩進み、関係を探索する
全体平均では見えないグループ差や、複数項目の組み合わせに注目します。ただし、BIツールで見つからない情報だけを扱うわけではありません。可視化による探索とモデルによる分析は補完的です。まず分布を見てから、目的に合う手法を選ぶと解釈しやすくなります。
4. 未知の発見だけでなく、既存の仮説の確認にも使う
新しい関連の発見は重要ですが、既存の仮説を別の期間や対象で確かめることにも価値があります。「以前の傾向が今も続くか」を確認できれば、施策の継続や変更を判断できます。探索段階で得た仮説を、その同じデータだけで証明したことにしないよう注意します。
5. 分析結果を行動と評価につなげる
見栄えのよいグラフより、誰が何を判断できるかが大切です。異常候補を抽出するなら、確認担当者、通知する条件、見逃しと誤検知の扱いを決めます。売上や効率の改善は分析結果だけで断定せず、実際の施策とその評価によって確かめましょう。
観測・発見・予測を混同しない:Irisの分布を読む
次の散布図は、scikit-learnのIrisデータセットにある150件の観測を、がく片と花弁の長さで表示した教材例です。色と記号は既知の三つの品種ラベルを表します。分類器やクラスタリングの実行結果ではなく、まず分布を確かめるための可視化です。
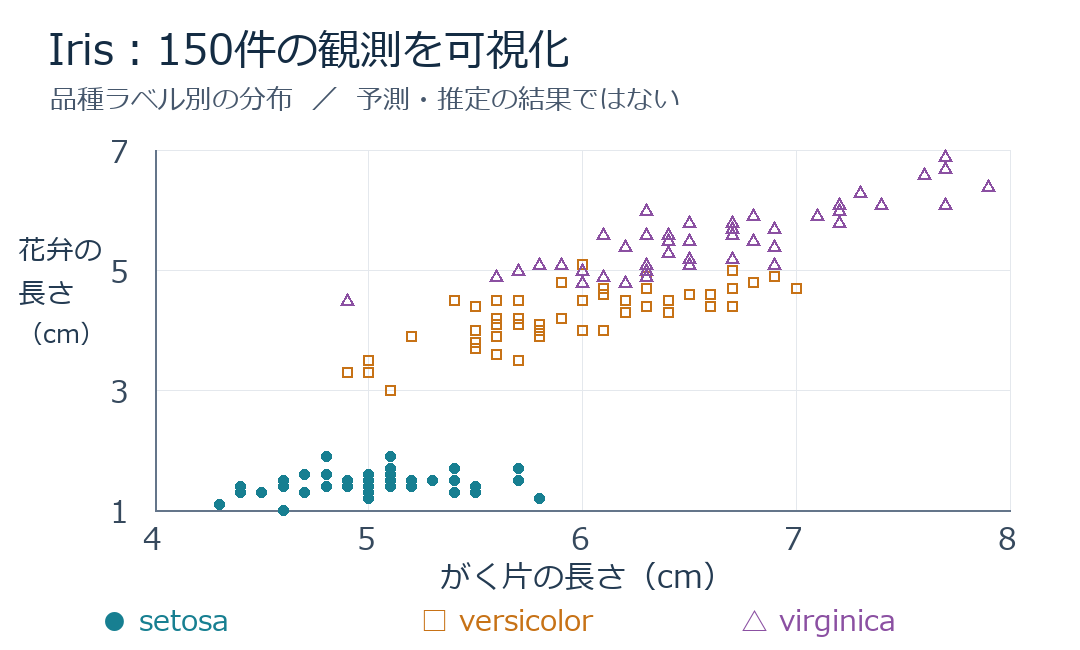
この二つの項目では、setosaは他の二品種から離れた領域に多く分布し、versicolorとvirginicaには重なりが見られます。散布図から見える傾向と、未知データを正しく分類できるかは別の問いです。判別性能を述べるには、学習・評価の分離と適切な指標による確認が必要になります。
同じ図でも、目的によって次の作業は変わります。品種が分かっている観測から未知の品種を予測したいなら分類、ラベルを使わず似た観測をまとめたいならクラスタリングです。後者でできたグループが、既知の品種と一致するとは限りません。「色で分かれて見える」ことを、モデルが自動発見した証拠と解釈しないことが大切です。
また、この図は限られた教材データを二つの項目で表示したものです。他の花や別の測定条件まで同じ分布になるとは言えません。対象範囲の外へ結論を広げない姿勢は、顧客分析や商品分析でも同じです。追加収集を考える際も、単に件数を増やすより、足りない対象や条件を明確にします。
五つの特徴を実務に生かす六つの確認項目
最初に、分析の目的と結果の使い道を決めます。「何か面白い傾向を探す」だけでは成功の判断ができません。確認したい問い、対象期間、評価する指標、判断を受け取る担当者をそろえてから、次の六つの工程で確認すべき点を整理します。
1. 収集・統合:一行の意味と対象範囲はそろっているか
社内データ、公式のダウンロードやAPIなどから必要な項目を集めます。異なるデータを結合するときは、同じIDが同じ対象を指すか、一行が一人・一商品・一取引のどれなのかを確認します。取得元、取得日、対象期間、利用条件も保存しましょう。
Web上の情報が必要で、公式の構造化データでは要件を満たせない場合には、Octoparseで閲覧可能なページから必要項目を抽出し、構造化する方法があります。ページ構造やアクセス条件に応じた設定とサンプル確認が必要です。Octoparseは収集工程を支援し、その後の統計分析やモデル評価は別に設計します。
2. 前処理:何を直し、何を残したか説明できるか
欠損、重複、単位、文字コード、日時の扱いをそろえます。外れた値をすべて削除すると、本当に知りたい例外まで失う場合があります。削除・補完した理由と件数を残し、元のデータを変更前の状態で保存します。学習データから求める平均や変換ルールは、評価データと分けて扱います。
3. 探索:平均だけで判断していないか
件数や平均に加え、分布、項目同士の関係、期間やグループごとの差を確認します。対象から抜けている集団や、特定の時期に集中した記録がないかも調べます。ここで得た発見は仮説として扱い、次の検証に必要なデータや手法を考えます。
4. 手法選定:単純な方法より役立つか
知りたいことがカテゴリ、数値、グループ、例外のどれなのかで手法を選びます。最初から複雑なモデルに限定せず、単純なルールや既存の方法を比較基準にします。精度だけでなく、説明のしやすさ、実行環境、更新や維持の負担も選定条件です。
5. 評価:未知の条件でも通用するか
学習・検証・テストの役割を分け、評価に使うデータを先に確保します。時系列の予測では未来の記録を過去の学習に混ぜず、同じ顧客などが両方に入る影響も確認します。scikit-learnの注意点でも、前処理の不整合とデータリークが取り上げられています。
分類では正解率だけでなく、目的に応じて適合率・再現率や誤分類の内訳を見ます。異常検知では、見逃しと確認作業の負担の両方が判断材料になります。使ったデータの範囲、評価方法、比較基準、苦手な条件を一緒に報告しましょう。
6. 活用:判断する人と見直す条件が決まっているか
結果を業務担当者と確認し、施策や判断ルールとして使えるかを検討します。相関と因果、予測と確定事項を分けて説明してください。運用を始めた後も、データの分布や性能、誤検知・見逃し、業務上の効果を見て、継続・修正・停止を判断します。
よくある質問
大量のデータやAIは必須ですか?
必須とは限りません。必要な規模や手法は、目的、ばらつき、評価方法によって変わります。集計や可視化で十分に答えられる問いなら、それを先に試します。件数の増加より、対象を適切に表しているか、検証できるかを優先しましょう。
スクレイピングしたデータは、そのまま分析できますか?
収集できたことと分析に使えることは別です。利用条件、対象範囲、欠損・重複、単位、更新日時を確認し、必要に応じて整理します。収集手順と分析手順を分けると、結果に問題があったときに原因を追いやすくなります。
まとめ
データマイニングでは、パターンを発見することに加え、それが信頼でき、行動に役立つかを検証することが重要です。目的を定め、収集・前処理・探索・手法選定・評価・活用をつなげましょう。まず一つの問いと代表的なデータに絞り、単純な方法を基準に確認すると、必要な追加データや次の作業が見えてきます。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール