正規表現とは、文字列の形をルールで表し、検索・抽出・置換に使う方法です。Webページから取得した「価格:¥18,306(税込)」のような文字列を、金額だけに整えたいときに役立ちます。ただし、正規表現は値の意味や正しさまでは判断しません。同じページに通常価格とセール価格が並ぶ場合は、まず抽出するフィールドを選び分ける必要があります。
この記事では、正規表現の基本記号、コピーして試せる短いパターン、Octoparseで抽出済みフィールドを整形する手順を説明します。古い画面のボタン位置を暗記するより、現在の「データを再フォーマット」機能でどの値をどう確認するかに重点を置きます。メールアドレスだけの抽出方法は別記事にまとめ、本記事では価格・日付・郵便番号を扱います。
正規表現とは?検索・抽出・置換の違い
検索は「この形の文字列があるか」を調べ、抽出は「一致した部分を取り出す」、置換は「一致した部分を別の文字に変える」操作です。たとえば商品ページのテキストから「18,306」を取り出すなら抽出、金額に含まれるカンマを消して「18306」にするなら置換です。先に対象の列と目的を決めると、必要以上に長いパターンを書かずに済みます。
正規表現の働きは利用するソフトウェアの実装にも左右されます。Python、JavaScript、.NET、Octoparseで、利用できる構文やオプションがすべて同じとは限りません。あるテスターで動いた式をそのまま本番へ貼る前に、実際に使う環境でサンプル行を試してください。特に全角数字、改行、文字列の先頭・末尾の扱いは確認が必要です。
正規表現の基本記号を少数から覚える
| 記号 | 意味と短い例 |
|---|---|
[0-9] | 半角数字1文字。[0-9][0-9] は連続する2桁 |
+ | 直前の要素を1回以上。[0-9]+ は1桁以上 |
{n} | 直前の要素をちょうどn回。[0-9]{4} は4桁 |
? | 直前の要素を0回または1回。-? はハイフンの有無 |
^ と $ | 文字列の始まりと終わり。^[0-9]+$ は全体が半角数字 |
(?:...) | まとめるが結果を別グループに保存しない。(?:,[0-9]{3})+ は「,」と3桁を反復 |
\s | 空白・改行などの空白文字。\s+ は連続する空白 |
\d を「数字」と説明する資料もありますが、全角数字を含むかどうかは実行環境で異なります。半角の0から9だけを扱う例では [0-9] と書くほうが意図を明確にできます。また、点 . は多くの環境で「任意の1文字」を意味し、通常のピリオドを探すときは \. とエスケープします。記号そのものを探すのか、特別な意味を使うのかを区別してください。
データ抽出で試せる正規表現の例
次の短い文字列を入力し、どの部分に一致するかを確認しましょう。対象ページに存在する表記を先に観察し、表記ゆれがあれば行ごとに結果を確認してください。
| 目的・入力文字列 | 正規表現と一致結果 |
|---|---|
| カンマ付き金額 商品A:¥18,306(税込) | [0-9]{1,3}(?:,[0-9]{3})+一致:18,306 |
| 郵便番号の形 〒100-0001 | [0-9]{3}-[0-9]{4}一致:100-0001 |
| 日付の形 更新日:2026-11-02 | [0-9]{4}-[0-9]{2}-[0-9]{2}一致:2026-11-02 |
| 連続空白 商品名 価格 | \s+一致:2文字分の全角空白 |
最初の金額パターンは「カンマ付き」の値を想定しています。「980」のようにカンマがない金額は一致しません。その場合は対象の表示形式を確認し、別のパターンを加えるか、抽出した金額フィールド全体から不要な文字を置換する方法を選びます。郵便番号と日付のパターンも形を検出するだけで、実在する住所や正しい暦日であることを保証しません。
郵便番号の欄全体が必ず「数字3桁-数字4桁」であるかを検査したいなら、^[0-9]{3}-[0-9]{4}$ と前後に境界を付けます。入力文字列「〒100-0001」は「〒」を含むため、この全体一致には失敗します。一方、境界のない [0-9]{3}-[0-9]{4} なら途中の「100-0001」を見つけられます。「抽出」と「入力全体の形式検査」で同じ式を使い回さないことがポイントです。
Pythonでパターンと結果を確かめる
コードで確認できる場合は、Python標準ライブラリの re でも同じ短い例を試せます。次のコードは学習用文字列からカンマ付き金額を一つ検索します。Octoparseの正規表現エンジンと完全に同じ動作を保証するテストではないため、Octoparse側でも一致結果を確認してください。
複数の価格が同じ文字列にあると re.search は最初の一致だけを返します。複数を比較する必要があるなら、どの価格が通常価格で、どれが割引後かを抽出元の項目で分けます。パターンだけで価格の意味を判定しようとすると誤用につながります。長いHTML全体を正規表現で分解するより、ページの要素を選択してフィールドを作り、その中の文字列を整形する順序が安全です。
Octoparseで正規表現を作成・生成して使う方法
Octoparseの現在の公式ヘルプでは、抽出したフィールドの「データを再フォーマット」で、正規表現によるマッチングと置換を選べます。正規表現が分からない場合は、よく使う表現を選ぶ方法やAI正規表現ジェネレータ、簡易ルール生成機能も案内されています。生成された式を確認せずにそのまま本番へ適用せず、まず対象フィールドの複数行で試しましょう。
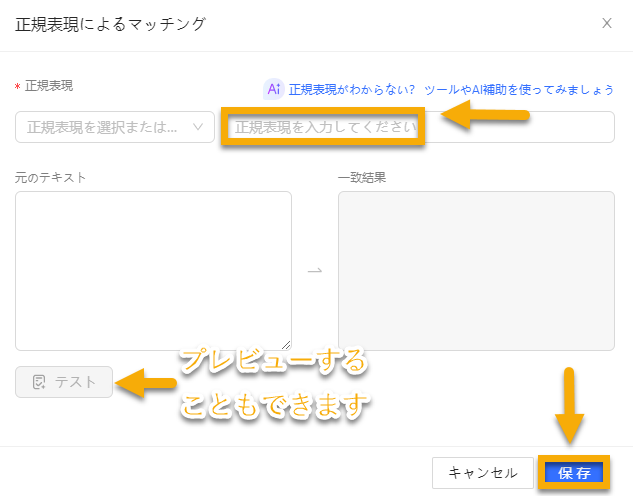
- 対象ページから必要なフィールドを抽出し、データプレビューで元の文字列を確認する。価格なら通常価格とセール価格が別の要素か先に調べる。
- 該当フィールドの「ほかのオプション」から「データを再フォーマット」を開き、「正規表現によるマッチング」または「正規表現による置換」を選ぶ。
- 短いパターンを入力するか生成機能で候補を作り、元の文字列と一致結果を比較する。先頭・途中・末尾、空欄、表記が違う行をそれぞれ見る。
- 期待と異なる行があれば、まず抽出する要素と入力文字列を確認し、その後でパターンを調整する。保存後に小規模の実行結果を再確認する。
「マッチング」は一致した部分を取り出す操作、「置換」は一致した部分を指定文字列へ変える操作です。たとえば価格からカンマを消すなら、まず必要な価格が正しく取れているかを確認し、置換でカンマを空文字にします。複数の整形ステップを追加できても、順序が変われば結果も変わります。元の列を残したまま整形後の列を比較できるようにすると、誤変換に気づきやすくなります。
正規表現ジェネレーターを使う際の注意点
自動生成された正規表現は出発点です。与えたサンプルが「¥18,306」だけなら、カンマのない価格、別の通貨、空欄、複数価格の表示まで扱えるとは分かりません。少なくとも成功する例と失敗する例を用意し、対象外の文字列まで一致しないかを確認します。価格なら送料や割引前価格まで混ざっていないかも調べます。
ネット上のコード表には、特定の正規表現エンジンでしか使えない構文や、日付の形を正しく表せない式が混ざることがあります。複雑な画像URLやHTML構造を一つの「万能な式」で処理しようとしないでください。HTMLタグの中身はページの要素選択で取り、正規表現は抽出後のテキスト整形に絞ると、サイトの構造変更にも原因を切り分けやすくなります。
個人の電話番号やメールアドレスのような情報は、正規表現で見つけられるからといって無条件に収集・保存・営業利用できるわけではありません。対象サイトの利用条件と個人情報の扱いを確認してください。タスクを共有するときは、入力例に実在する顧客情報やCookieを含めず、架空の文字列で検証することも大切です。
まとめ
正規表現の作成は、まず抽出したい文字列と、抽出してはいけない文字列を並べるところから始まります。[0-9]、回数指定、先頭・末尾の境界など少数の記号でも、価格や日付の形を扱えます。ただし形式が一致しても、値の意味や正確さは別に確認が必要です。
Octoparseではフィールドを選んだ後、「データを再フォーマット」でマッチングや置換を設定できます。ジェネレーターで候補を作った場合も、複数の表記と空欄を含むサンプルを使い、元ページと出力を照合してから実行範囲を広げてください。正規表現を短く保ち、抽出元と整形後の列を区別することが、後から修正しやすいタスクにつながります。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール