PHPでWebスクレイピングする方法|cURL・DOMXPathの実践コード
PHPでWebスクレイピングを始める方法を、cURL・DOMXPathで2ページを巡回してCSVへ保存するコードから説明。取得前の条件確認、よくあるエラー、Octoparseとの使い分けも解説します。
PHPでWebスクレイピングを始めるなら、HTMLの取得、要素の抽出、CSV保存を別々に考えると迷いにくくなります。この記事ではPHPのcURLとDOMXPathを使い、練習用サイトの2ページから必要な列を取り出す最小構成を説明します。古いAmazonページを正規表現で切り出すコードは現在のHTML構造に依存し、入力URLをそのまま取得する設計にも問題があるため使いません。
PHPでWebスクレイピングをする前に決めること
この例は、学習用に公開されているQuotes to Scrapeの先頭2ページだけを対象にします。実サイトでは、利用規約、robots.txt、公式API・ダウンロードの有無を先に確認し、取得許可のあるページだけを少量から扱ってください。自動アクセスは相手のサーバーへ負荷をかけるため、間隔と停止条件も設けます。robots.txtの仕組みはRFC 9309で確認できます。
PHPの役割を「HTTPで静的HTMLを受け取る」「DOMで必要な要素を選ぶ」「結果を保存する」の3つに分けます。JavaScript実行後にだけ現れる内容はcURLの応答HTMLには含まれない場合があります。そのときはブラウザの開発者ツールで通信や公開APIを確認し、取得方法を見直します。
PHPの準備:cURLとDOM拡張を確認
PHP 8.1以降のCLIを想定します。端末でphp -vを確認し、php -mの一覧にcurlとdomがあることを確認してください。配布方法によって拡張の有効化手順は異なります。以下は追加のスクレイピング用ライブラリを使わず、PHPのcURL、DOMDocument、DOMXPath、fputcsvで構成します。
PHPクローラーのコード例:2ページを読みCSVへ保存
次のコードをcrawl.phpとして保存し、端末でphp crawl.phpを実行します。取得先はコード中の固定ドメインと2つのパスだけです。任意の入力URLをサーバー側でそのまま取得する仕組みにはしていません。成功時は同じフォルダーにquotes.csvを作り、page_url、text、authorの列を書き込みます。
取得はcURLのタイムアウトとHTTPステータス・Content-Typeで確認し、DOMXPathで各div.quote内の文字列を抽出します。CSVの行には取得元URLも残すため、後から表示元を点検できます。対象ページのHTMLクラス名が変わればXPathも直す必要があります。引用文の再配布や業務利用は、データの権利・利用条件を別途確認してください。
動かないときの確認順
- HTTPエラー・タイムアウト:URLの応答、アクセス条件、リダイレクトの有無を確認します。この例は予期しない転送を追わない設定です。制限を力ずくで回避せず、利用条件に適した取得方法へ切り替えます。
- CSVの見出しだけになる:受け取ったHTMLに
div.quoteがあるか確認します。ブラウザで見える内容がJavaScript描画なら、HTML取得だけでは選択できません。 - 文字化け:レスポンスの文字コードとHTMLの指定を確認します。この練習ページはUTF-8のためコードではUTF-8として読み込みます。他のサイトにそのまま流用しないでください。
- CSVを書けない:保存先フォルダーの書込権限、開いているファイル、ディスク容量を確認します。
PHP自作とOctoparseはどう使い分ける?
自社のPHP環境へ小さな取得処理を組み込み、HTMLや例外処理を自分で管理したい場合は、上の自作コードが学習・検証に向いています。データを得ることが目的なら、対象サイトに合うOctoparseテンプレートの入力と出力列を確認する方法もあります。合うテンプレートがない場合は、AIアシスタントを通じたクラウドAI収集で専用タスクを生成・実行する経路を検討でき、細かな操作を自分で設定する場合にはデスクトップの自作タスクも選べます。日本語Docsで選んだ方法の条件を確かめ、サイトの利用条件と抽出結果の品質を確認してください。Octoparseが任意のPHPコードを自動変換するわけではありません。
比較の基準は「コード保守を誰が担うか」「サイトの画面変更に誰が対応するか」「必要なページ数・列・更新頻度はいくつか」です。単純な静的ページならPHPで足りることがあります。画面操作や複数ページの設計が必要なら、まず公式テンプレートの有無とプレビュー結果を確かめましょう。一般的なスクレイピングの定義は基礎記事、クローラーの概念は用語記事に分けています。
よくある質問
PHPでHTMLを正規表現だけで抽出できますか?
単純な文字列には使えても、タグの入れ子、属性順、引用符や改行が変わるHTML全体の解析には適しません。本文のようにDOMへ読み込み、XPathで要素を指定すると抽出箇所を点検しやすくなります。
PHPのcURLでJavaScript後の画面も取れますか?
cURLはHTTP応答を取得しますが、通常はブラウザのJavaScriptを実行しません。まず応答HTMLや公開APIに目的の項目があるかを確認し、なければ対象サイトに合うブラウザ型の方法やOctoparseタスクを検討します。
まとめ
PHPでWebスクレイピングを行う基本は、許可を確認した少量のページをcURLで取得し、DOMXPathで必要な要素だけを選び、元URL付きでCSVに保存することです。固定URL、タイムアウト、応答確認、ページ上限と間隔を先に決め、HTML変更や取得失敗を見つけられる構成にしましょう。コードを自分で管理する必要がなければ、OctoparseのテンプレートやAIアシスタントから始める収集経路、デスクトップのカスタムタスクも要件に合わせて比較できます。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール

今すぐOctoparseを始めて、業務効率化を実現しましょう。
関連記事
藤井, あゆみ
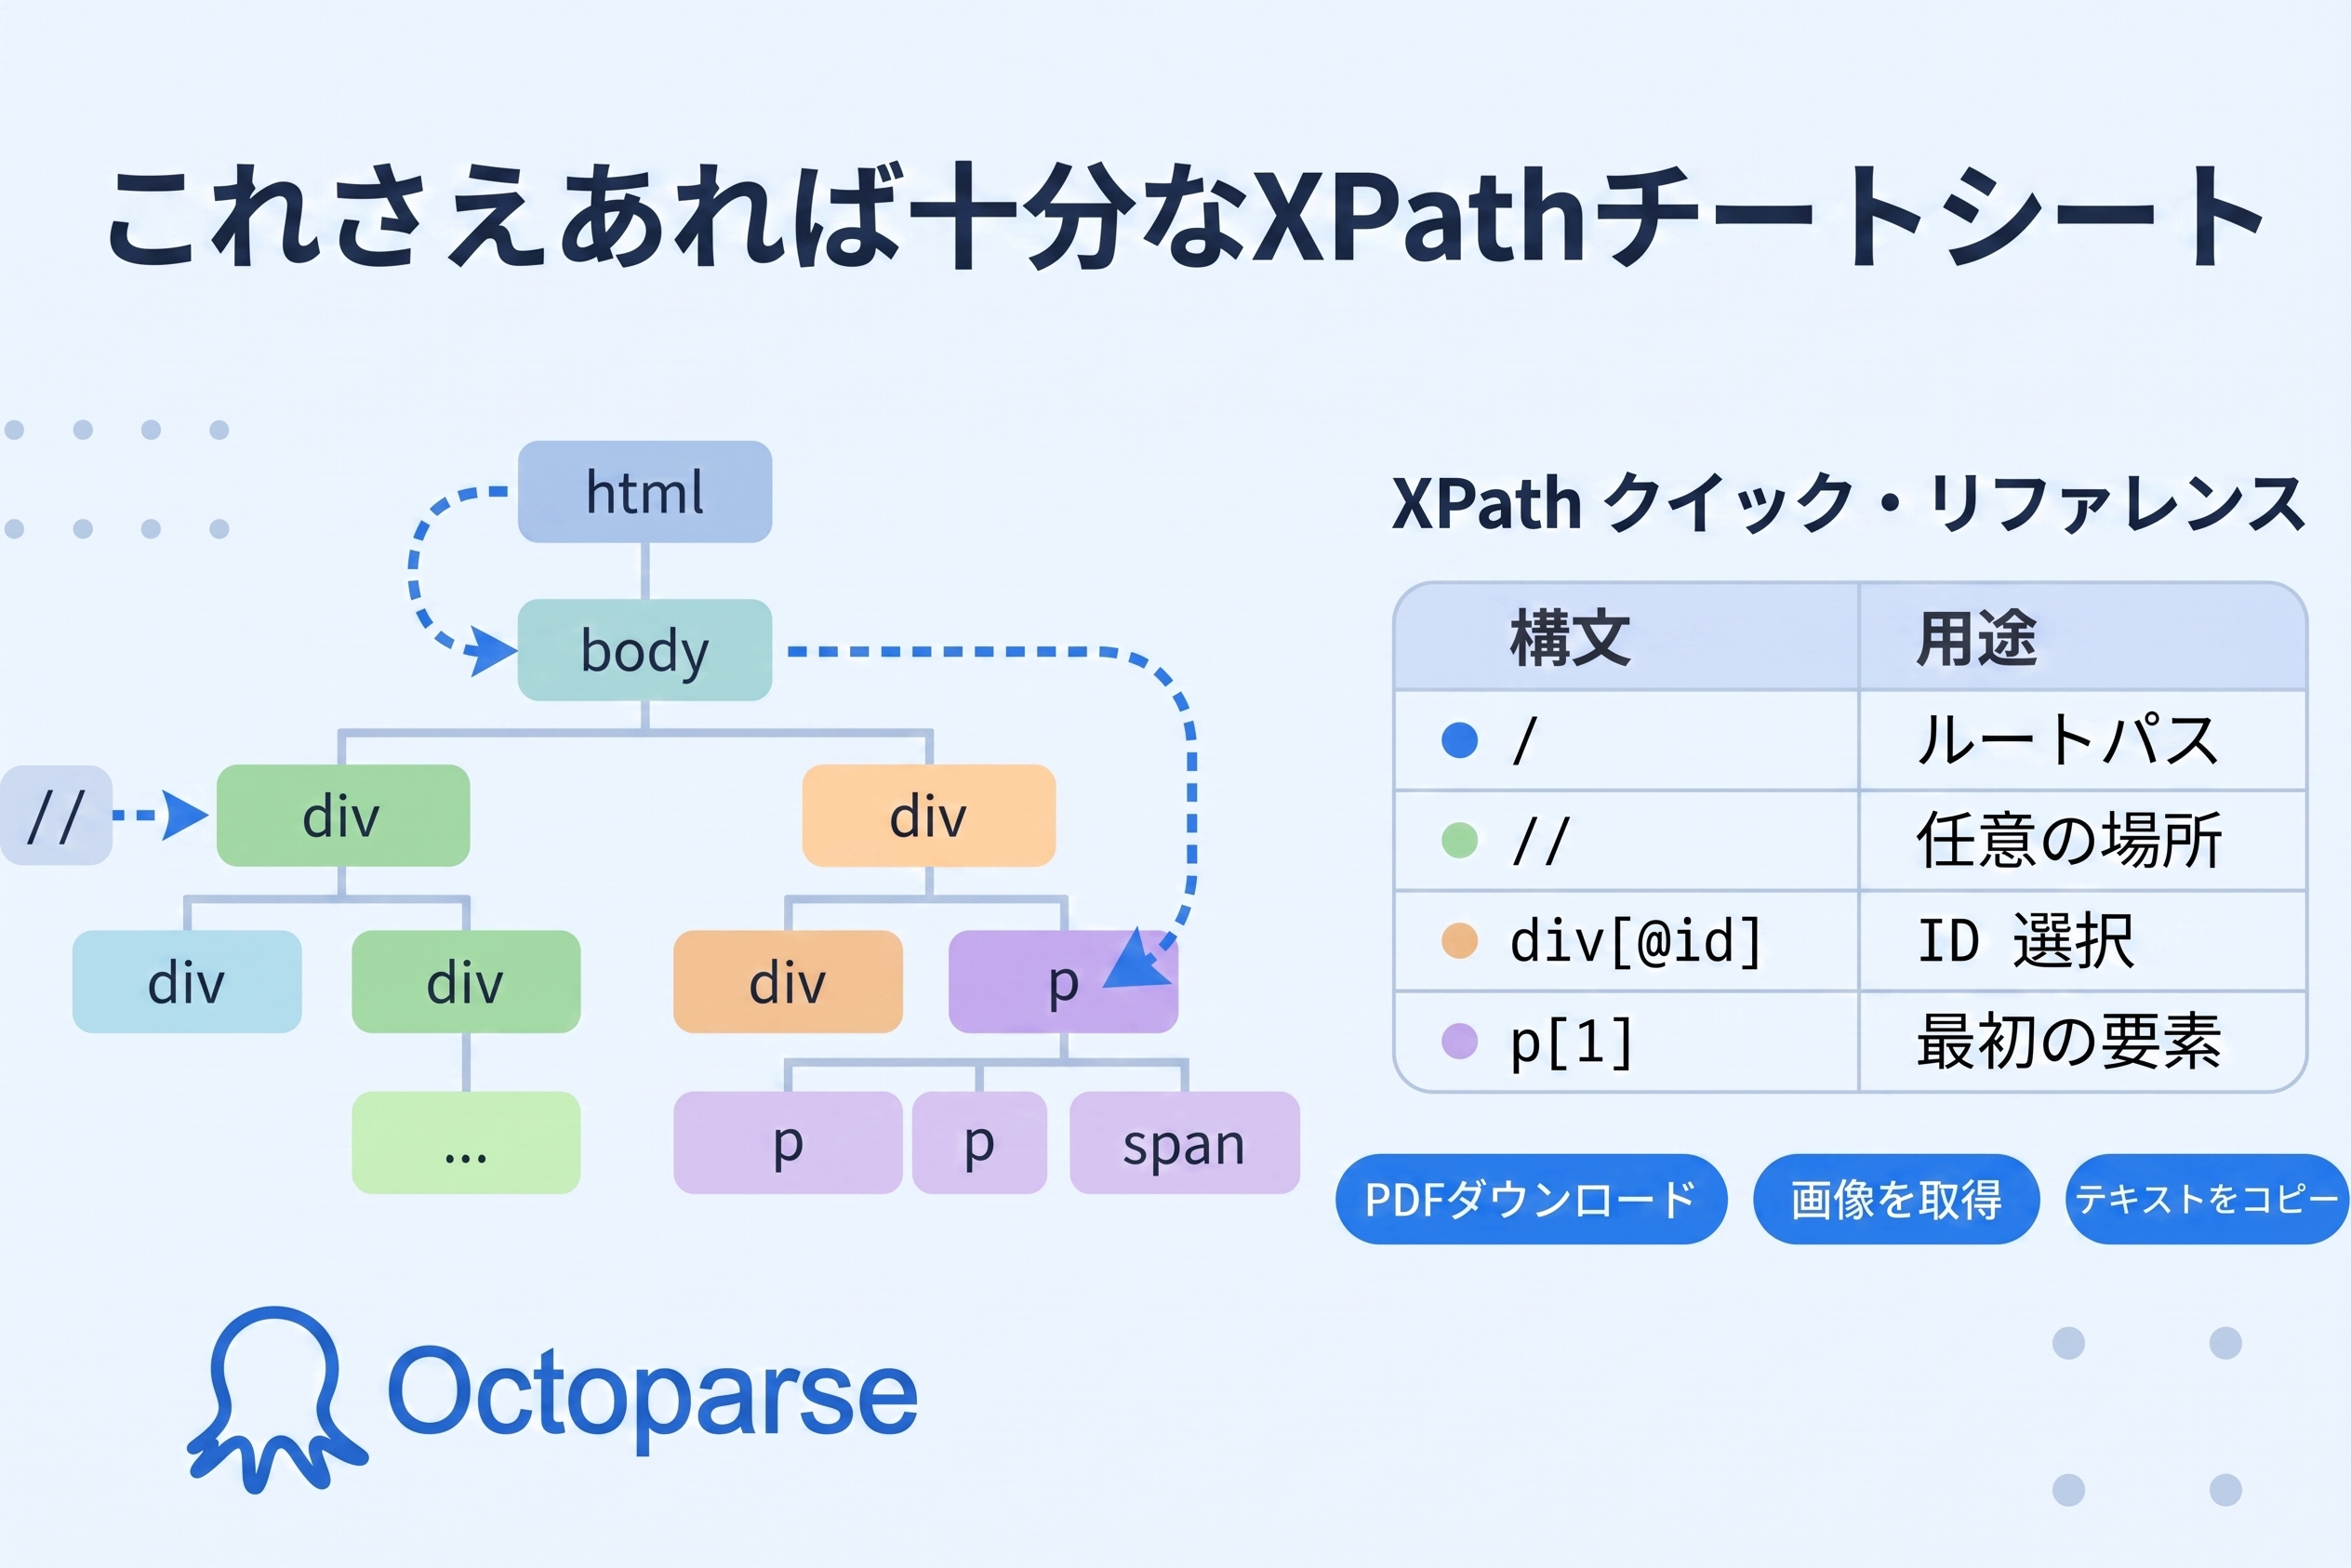
Webスクレイピングで要素が取得できずお悩みですか?本記事では、動的サイトにも対応できる完全版「XPath チートシート」を提供します。SeleniumやScrapyでの具体的な活用法や、CSSセレクタとの違いなど、データ抽出を安定させる実践的なテクニックを網羅的に解説します。2026-07-22T10:52:34+00:00 · 7 min read
たかはし
Googleスクレイピングは本当に禁止なのか?利用規約と日本法の境界を正直に解説。Google Custom Search API・SERP APIサービス・Octoparseノーコードの3方式を徹底比較し、テンプレートで3分・CSV出力まで完了する実践手順を紹介します。2026-07-15T10:01:29+00:00 · 7 min read
マツモト
Pythonなしで気象庁データを自動収集する方法を解説。アメダスのリアルタイムデータ・過去10分データをExcel/CSVに出力する手順と農業・建設・小売での活用例を紹介。2026-06-30T11:57:48+00:00 · 7 min read
よしだ
ASINコードの意味・確認方法から、ASIN一括取得が可能なツール5選の比較まで徹底解説。Keepa・ASINFetcher・Octoparseなどの機能・料金・対応規模をEC担当者・Amazon出品者向けに詳しく紹介します。2026-06-17T12:06:38+00:00 · 7 min read


