オープンソースのWebクローラーは、取得対象が静的HTMLかJavaScriptで描画されるページか、何ページをどの頻度で取得するかによって、適切な選択肢が変わります。最初から「人気順」で選ぶのではなく、HTML取得、ブラウザ操作、URL管理、再試行、保存、監視のどこまでをフレームワークに任せたいかを決めることが重要です。
この記事では、開発者がコードで構築・保守することを前提に、現在も公式ドキュメントを確認できる7つのオープンソース候補を、対応言語・JavaScript対応・運用負荷で比較します。無料のノーコードツールを探している方は「無料Webスクレイピングツールの比較」、クローラーの仕組みを知りたい方は「Webクローラーとは」をご覧ください。
オープンソースWebクローラー7選の比較表
| 候補 | 主な言語 | JavaScriptページ | 向いている用途 | 導入・運用負荷 |
|---|---|---|---|---|
| Scrapy | Python | 追加のブラウザ連携が必要 | 静的HTML中心の継続クロール | 中 |
| Crawlee | JavaScript / Python | ブラウザ型クローラーを選択可能 | HTTP取得とブラウザ取得の併用 | 中 |
| Playwright | JS/TS、Python、Java、.NET | 得意 | ログイン、クリック、動的画面 | 中〜高 |
| Puppeteer | JavaScript / TypeScript | 得意 | Node.jsでのブラウザ自動操作 | 中〜高 |
| Selenium | 複数言語 | 得意 | 複数ブラウザを使う既存資産との連携 | 高 |
| Heritrix | Java | 限定的 | Webアーカイブ向けの大規模収集 | 高 |
| Apache Nutch | Java | 限定的 | 分散クロールや検索基盤との連携 | 高 |
「JavaScriptページに対応」とは、ブラウザを起動して画面描画を待てることを指します。ブラウザ実行は便利ですが、HTMLを直接取得する方式よりCPU・メモリ・実行時間を使います。まずHTTP取得で必要なデータが得られるかを確認し、必要なページだけブラウザ型に切り替えると運用しやすくなります。
選ぶ前に決める5つの条件
- ページの描画方式:取得したHTMLにデータがあるか、ブラウザ操作後に表示されるか
- 操作の有無:ログイン、クリック、無限スクロール、フォーム入力が必要か
- 規模と頻度:数十ページの単発取得か、数十万URLを継続処理するか
- 運用要件:再試行、重複排除、キュー、ログ、通知、途中再開が必要か
- チームの言語:Python、Node.js、Javaなど、保守できる技術スタックは何か
さらに、対象サイトの利用規約、robots.txt、APIの有無、個人情報・著作権、アクセス頻度を確認してください。オープンソースであることは、対象データを自由に取得できることを意味しません。
1.Scrapy|Pythonで静的HTMLを継続収集する
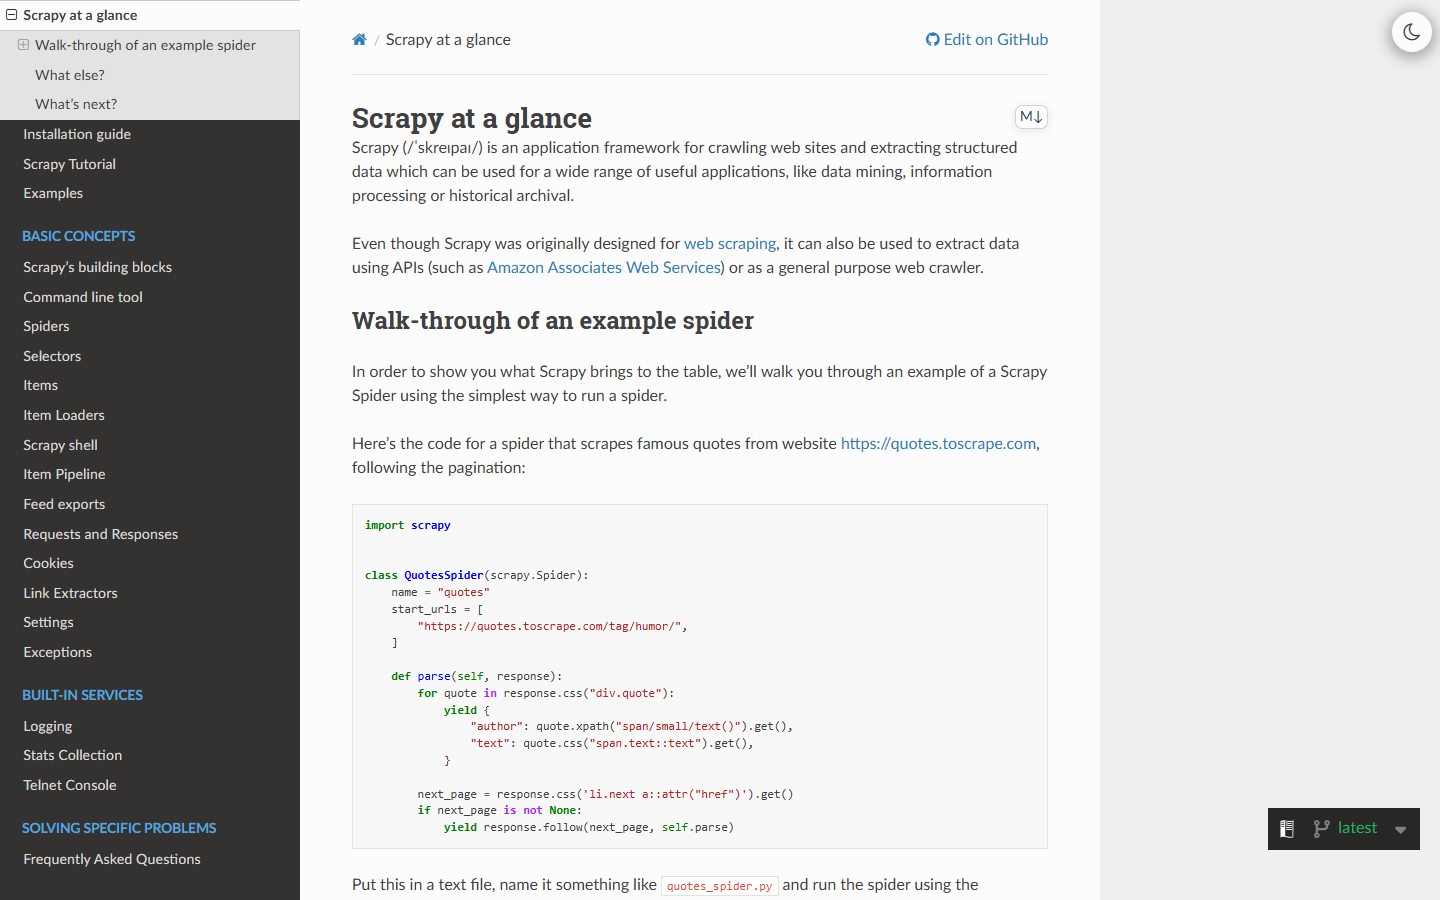
Scrapyは、Python製のクローリング・データ抽出フレームワークです。リクエスト、レスポンス、セレクター、アイテム、パイプラインなど、継続クロールに必要な構成要素が分かれています。商品一覧、求人一覧、記事一覧のように、HTML内に必要な情報があるサイトで特に扱いやすい選択肢です。
一方、クリック後にデータが表示されるページでは、APIリクエストを調べるか、Playwrightなどのブラウザ自動化と組み合わせる設計が必要です。公式のインストールガイドで、対応するPython環境と依存関係を確認してから導入しましょう。
2.Crawlee|JavaScriptとPythonでHTTP・ブラウザ取得を使い分ける
Crawleeは、JavaScript版とPython版が公開されているWebスクレイピングライブラリです。HTTPベースのクローラーと、Playwrightなどを使うブラウザベースのクローラーを用途に応じて選べます。静的ページと動的ページが混在する案件で、同じ考え方の中にキューや再試行を組み込みたい場合に検討しやすい候補です。
JavaScript版とPython版は、機能や更新時期が常に同一とは限りません。導入前に、利用する言語のJavaScriptドキュメントまたはPythonドキュメントで必要な機能を確認してください。
3.Playwright|ログインや動的画面をブラウザで操作する
Playwrightは、Chromium、Firefox、WebKitを操作できるブラウザ自動化ライブラリです。JavaScript / TypeScript、Python、Java、.NET向けの公式案内があり、ログイン、ボタンクリック、ページ遷移、動的要素の待機が必要な取得に向いています。
ただし、Playwrightだけで大規模なクローラー運用が完成するわけではありません。URLキュー、重複排除、再試行、保存、スケジューリング、監視は別途設計します。ブラウザ操作が必要なページだけに使い、静的ページはHTTP取得へ分けるとリソースを抑えやすくなります。
4.Puppeteer|Node.jsでChrome・Firefoxを自動操作する
Puppeteerは、JavaScript / TypeScriptからブラウザを操作するライブラリです。Node.jsの既存システムに組み込み、ページ描画後のHTML、スクリーンショット、PDF、ネットワーク通信などを扱いたい場合に候補になります。公式のブラウザ対応情報を確認し、対象ブラウザと利用バージョンを固定してテストしてください。
Playwrightと役割が近いため、両方を同じ案件に入れる必要は通常ありません。既存コード、必要なブラウザ、待機・デバッグ方法、チーム経験で一つを選び、クロール管理は別レイヤーに分けると保守しやすくなります。
5.Selenium|複数ブラウザと既存の自動化資産を生かす
Seleniumは、WebDriverを通じて複数ブラウザを自動操作するプロジェクトです。テスト自動化の既存資産、社内の対応言語、ブラウザ検証環境を生かしてデータ取得も行う場合に選択肢になります。
Webスクレイピングだけを新規に始める場合は、ドライバー管理、待機条件、並列実行、障害復旧まで含めてPlaywrightやPuppeteerと比較してください。「操作できる」ことと「継続クロールを安全に運用できる」ことは別です。
6.Heritrix|Webアーカイブを目的に収集する
Heritrixは、Webアーカイブ用途を主眼に置いたJava製クローラーです。個別の商品項目を表形式にするというより、サイト群を一定の方針で収集し、アーカイブとして保存する要件に向いています。
収集範囲、URL正規化、除外ルール、保存容量、再開方法を事前に設計する必要があります。小規模な表データ抽出には構成が重いため、目的が「分析用の行・列データ」なのか「将来参照するWebアーカイブ」なのかを先に分けてください。
7.Apache Nutch|分散クロールと検索基盤を構成する
Apache Nutchは、拡張可能なJava製Webクローラーです。多数のURLを分散処理し、検索・インデックス基盤へつなぐ構成を検討する場合に候補になります。プラグイン、クロールDB、重複処理、保存先など、システム全体の設計が必要です。
少数サイトの項目抽出には運用負荷が大きくなりやすいため、最初から採用するのではなく、Scrapyなどで満たせない規模・分散要件があるかを確認しましょう。
旧版の10ツールから構成を変えた理由
旧版は、クローラーフレームワーク、HTMLパーサー、商用クラウドサービス、更新状況を確認しにくいプロジェクトを同じ「オープンソースWebクローラー」として並べていました。新版では分類を整理し、現在の公式ドキュメントと利用境界を確認できる候補に絞っています。
- MechanicalSoupやNokogiriのような取得・解析部品は、完全なクロール運用基盤と分けて考える
- Apifyのような商用プラットフォームは、オープンソース候補のランキングから外す
- 公式の更新・互換性・セキュリティ情報を追いにくいプロジェクトは、本番候補に入れる前に保守状況を確認する
- ツール数を10に合わせるより、目的が異なる代表候補を比較する
コードを書かずに収集したい場合はOctoparse
ここまで紹介した7つは、基本的にコード、実行環境、ログ、保存、保守をチームで管理する選択肢です。エンジニアがいない、画面で取得項目を選びたい、テンプレートから短期間で試したい場合は、ノーコードのOctoparseが比較対象になります。
| 判断軸 | オープンソース | Octoparse |
|---|---|---|
| 作成方法 | コードと設定を自社で実装 | 画面操作とワークフローで設定 |
| 自由度 | 設計・開発できる範囲で高い | 製品が対応する機能内で構成 |
| 保守 | 依存関係、実行基盤、監視を自社管理 | タスク設計と取得結果の確認が中心 |
| 向くチーム | 開発・運用担当者がいる | 業務担当者が自分で試したい |
どちらを選んでも、対象サイトの変更、取得結果の欠損・重複、利用規約、実行頻度の管理は必要です。まず20〜50ページで検証し、取得率、重複率、処理時間、失敗時の復旧方法を比べてから本番化してください。
よくある質問
初心者にはどのWebクローラーがおすすめですか?
Pythonで静的HTMLを扱うならScrapy、Node.jsで動的画面を操作するならPlaywrightまたはPuppeteerが候補です。コードを書かない場合はOctoparseのテンプレートやカスタムタスクから小さく試します。
ScrapyとPlaywrightはどちらを選ぶべきですか?
取得したHTMLに必要なデータがあればScrapy、ブラウザで描画・操作しないとデータが出なければPlaywrightが基本です。サイト内でページ種類が分かれる場合は、両者を役割分担させる方法もあります。
オープンソースなら商用利用できますか?
プロジェクトごとにライセンス条件が異なります。リポジトリのLICENSE、依存パッケージ、再配布の有無を確認してください。また、ツールのライセンスと、対象サイトの規約・データの権利は別に確認が必要です。
まとめ
オープンソースWebクローラーは、言語より先に「HTMLだけで足りるか、ブラウザ実行が必要か」を切り分けると選びやすくなります。静的HTML中心ならScrapy、HTTPとブラウザを併用するならCrawlee、画面操作が中心ならPlaywright・Puppeteer・Selenium、アーカイブや分散基盤ならHeritrix・Apache Nutchが主な候補です。
小さな検証用URLセットを用意し、取得精度、実行時間、失敗時の復旧、保守担当者まで比較してください。コード管理を避けたい場合は、Octoparseで同じURLを試し、実務上の総コストで判断しましょう。

競合情報も営業リストも、ウェブデータをそのままExcel・CSV・Google Sheetsに出力
コード不要、誰でも今日から。クリック操作だけで必要な項目を自動抽出
Google Maps・食べログ・iタウンページ向けテンプレートで、リード獲得をすぐに開始
クラウドで毎日・毎週自動実行。大量取得でも安定して、競合動向を常に把握
MCP対応でAIエージェントと連携。収集データをAIに渡して分析・活用まで一気通貫
クレジットカード不要で無料スタート。世界600万人以上が選んだ信頼のツール